qué es el aprendizaje automático
Si te preguntas qué es el aprendizaje automático, la respuesta más sencilla es esta: el aprendizaje automático es una forma de que los ordenadores aprendan patrones a partir de datos y utilicen esos patrones para hacer predicciones, recomendaciones o tomar decisiones. En lugar de escribir cada regla a mano, las personas proporcionan ejemplos al sistema, y el sistema aprende de ellos.
El glosario de NIST define el aprendizaje automático como sistemas informáticos que se adaptan y aprenden de los datos para mejorar la precisión. Suena técnico, pero la idea cotidiana resulta familiar: cuantos más ejemplos útiles vea el sistema, mejor podrá reconocer patrones.
qué es el aprendizaje automático en términos sencillos
El aprendizaje automático es una rama de la inteligencia artificial. IBM, Google Cloud, Microsoft Azure y AWS lo explican de forma similar: el aprendizaje automático utiliza datos y algoritmos para entrenar sistemas que pueden hacer predicciones o encontrar patrones sin estar programados explícitamente para cada caso.
Imagina que enseñas a un niño a reconocer perros. No enumeras todas las formas posibles de las orejas, longitudes de la cola y colores del pelaje. Le muestras ejemplos. Con el tiempo, el niño aprende el patrón. El aprendizaje automático funciona con un espíritu similar, pero con datos, matemáticas y algoritmos.
Cómo funciona el aprendizaje automático
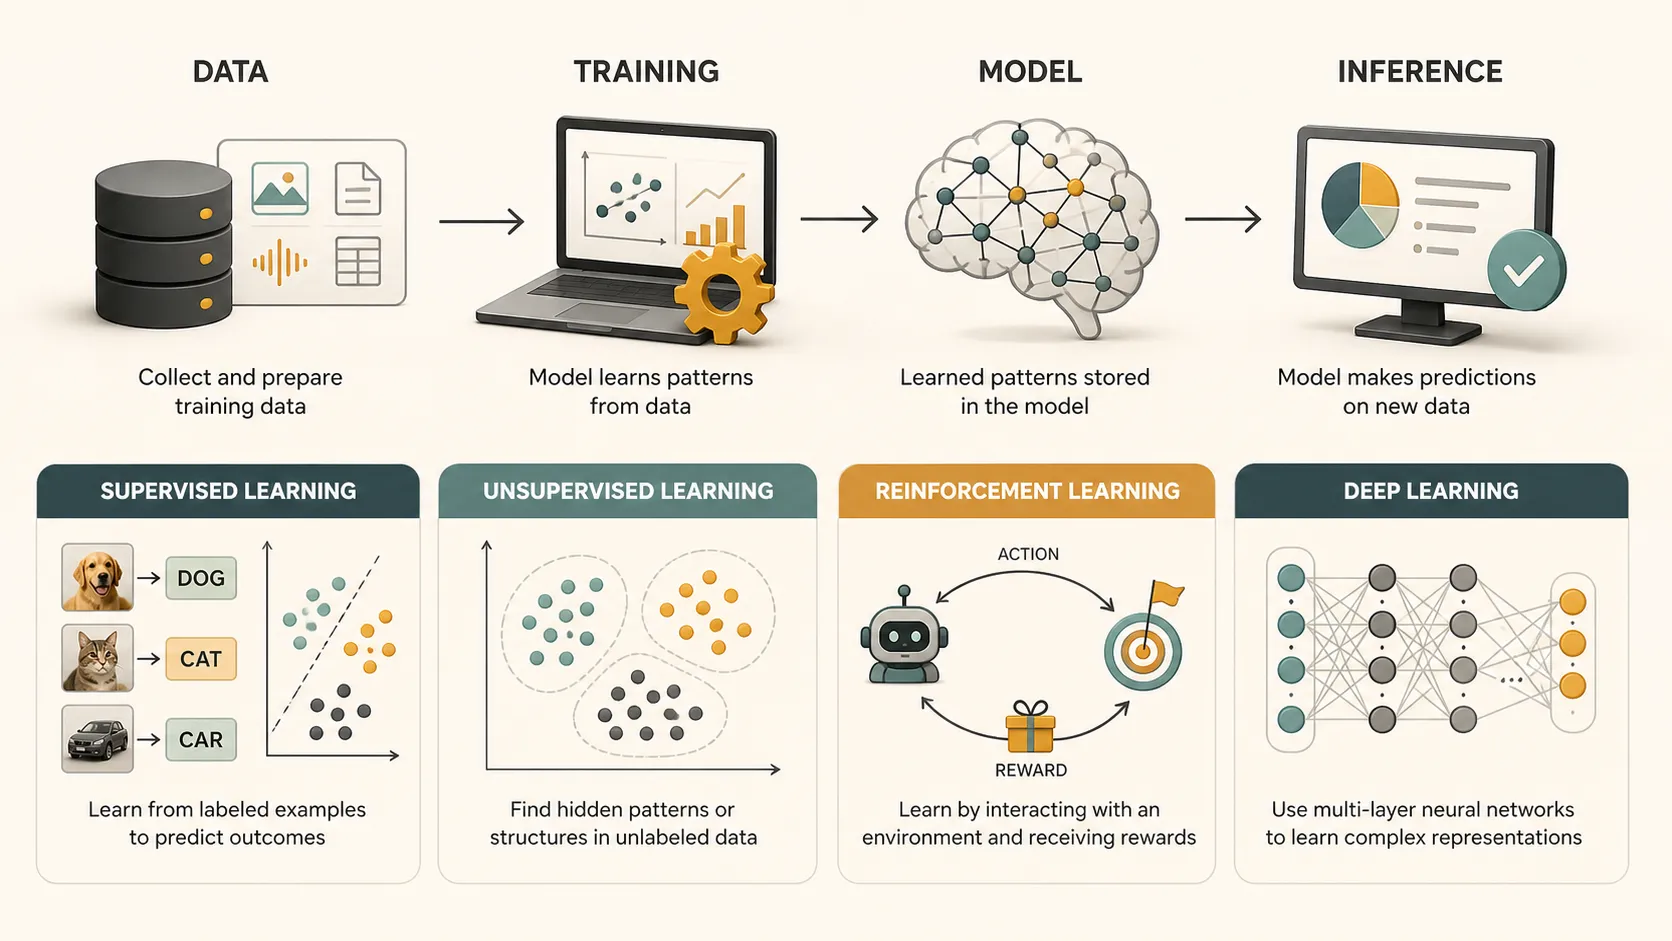
La mayoría de los proyectos de aprendizaje automático siguen un flujo básico: recopilar datos, prepararlos, entrenar un modelo, probarlo y, después, utilizar el modelo con nuevas entradas. La guía de AWS para crear una aplicación de aprendizaje automático describe esto como un proceso iterativo: definir el problema, preparar los datos, crear características útiles, entrenar el modelo, evaluarlo y utilizarlo para hacer predicciones.
Un filtro de spam es un ejemplo sencillo. El sistema aprende de correos electrónicos etiquetados como «spam» y «no spam». Durante el entrenamiento, detecta patrones: enlaces sospechosos, frases repetidas, comportamiento del remitente o formato. Durante la inferencia, aplica lo que ha aprendido a un correo electrónico nuevo y predice si es spam.
La palabra importante es «predice». El aprendizaje automático no entiende el mundo como una persona. Encuentra patrones estadísticos. Eso puede ser potente, pero también significa que la calidad de los datos importa enormemente.
Tipos comunes de aprendizaje automático
El aprendizaje automático no es un único método. Incluye varios enfoques principales:
| Tipo | ¿para qué se utiliza aquí el aprendizaje automático? | Ejemplo |
|---|---|---|
| Aprendizaje supervisado | Aprendizaje a partir de ejemplos etiquetados | Predecir los precios de las viviendas a partir de ventas anteriores |
| Aprendizaje no supervisado | Encontrar patrones sin etiquetas | Agrupar clientes según su comportamiento |
| Aprendizaje por refuerzo | Aprendizaje mediante recompensas y penalizaciones | Entrenar a un agente que juega a videojuegos |
| Aprendizaje profundo | Uso de redes neuronales por capas | Reconocimiento de imágenes o transcripción de voz |
Stanford CS229 enseña aprendizaje automático mediante temas fundamentales como el aprendizaje supervisado, el aprendizaje no supervisado, las redes neuronales y el aprendizaje por refuerzo. El curso intensivo de aprendizaje automático de Google también resulta útil para principiantes porque explica los conceptos con ejemplos prácticos. Para quienes quieran documentación práctica, la guía de usuario de scikit-learn y los fundamentos de aprendizaje automático de TensorFlow son sólidas referencias técnicas.
Aprendizaje automático frente a IA frente a aprendizaje profundo
La gente suele confundir la IA, el aprendizaje automático y el aprendizaje profundo. Están relacionados, pero no son idénticos.
La inteligencia artificial es el campo amplio: crear sistemas que puedan realizar tareas asociadas a la inteligencia humana, como el razonamiento, el lenguaje, la percepción, el aprendizaje o la toma de decisiones. El aprendizaje automático es una forma de crear sistemas de IA. El aprendizaje profundo es un tipo de aprendizaje automático que utiliza redes neuronales con muchas capas.
Por tanto, la relación es sencilla: la IA es la categoría general. El aprendizaje automático está dentro de la IA. El aprendizaje profundo está dentro del aprendizaje automático.
Una calculadora sigue reglas fijas, por lo que no es aprendizaje automático. Un sistema de recomendaciones que mejora al aprender del comportamiento de los usuarios es aprendizaje automático. Un modelo de lenguaje grande que utiliza redes neuronales profundas es aprendizaje profundo.
Ejemplos reales de aprendizaje automático
El aprendizaje automático ya forma parte de la vida cotidiana. Los servicios de streaming lo utilizan para recomendar vídeos. Los bancos lo usan para detectar transacciones inusuales. Los servicios de correo electrónico lo emplean para filtrar spam. Las herramientas de traducción lo usan para convertir idiomas. Los motores de búsqueda lo utilizan para entender las señales de relevancia y clasificación.
En el ámbito sanitario, la FDA mantiene una lista de dispositivos médicos habilitados para IA, muchos de los cuales utilizan técnicas de IA o aprendizaje automático para imágenes médicas, diagnósticos o apoyo clínico. Esto recuerda que el aprendizaje automático puede ser útil, pero los sistemas de alto riesgo necesitan pruebas y supervisión.
La ciencia es otro ejemplo destacado. AlphaFold utiliza IA para predecir estructuras de proteínas, ayudando a los investigadores a estudiar la biología de forma más eficiente. Demuestra que el aprendizaje automático no sirve solo para anuncios, aplicaciones y paneles de control; también puede respaldar el descubrimiento científico.
Por qué importa la calidad de los datos
Un modelo de aprendizaje automático solo es tan bueno como los datos y las suposiciones que hay detrás de él. Si los datos de entrenamiento están incompletos, sesgados, desactualizados o mal etiquetados, el modelo puede aprender patrones equivocados.
Por ejemplo, un modelo de contratación entrenado con datos históricos de contratación sesgados puede repetir esos patrones. Un modelo médico entrenado principalmente con una población puede rendir peor para otra. Un modelo de recomendaciones puede volverse demasiado limitado y seguir mostrando a los usuarios más de lo mismo.
Un buen trabajo de aprendizaje automático incluye limpieza de datos, pruebas, validación, supervisión y revisión humana. También implica plantear preguntas incómodas: ¿quién está representado en los datos? ¿Quién falta? ¿Qué ocurre si el modelo se equivoca?
Explicar visualmente el aprendizaje automático con Pi
El aprendizaje automático puede parecer abstracto porque el trabajo importante a menudo es invisible: preparación de datos, entrenamiento del modelo, evaluación, implementación y ciclos de retroalimentación. La explicación visual ayuda a las personas a ver el proceso.
Con Pi, puedes convertir conceptos de aprendizaje automático en una presentación: un flujo de trabajo de datos a modelo, una comparación entre aprendizaje supervisado y no supervisado, un gráfico que muestre la precisión del modelo o una explicación basada en iconos sobre entrenamiento e inferencia. Pi también puede personalizar temas, colores, diseños, iconos, gráficos y elementos visuales generados por IA, lo que facilita presentar ideas técnicas a estudiantes, clientes, fundadores o equipos internos.
Riesgos y uso responsable
Los sistemas de aprendizaje automático pueden cometer errores. Pueden amplificar sesgos, exponer información privada, generar resultados injustos o resultar difíciles de explicar. Por eso es importante una IA responsable.
El Marco de gestión de riesgos de IA de NIST ofrece a las organizaciones una forma de reflexionar sobre los riesgos de una IA fiable. Los Principios de IA de la OCDE destacan los valores centrados en las personas, la equidad, la transparencia, la solidez, la seguridad y la rendición de cuentas.
Para principiantes, la conclusión es sencilla: el aprendizaje automático no debe juzgarse solo por su precisión. También debe evaluarse por su equidad, seguridad, privacidad, capacidad de explicación e impacto en el mundo real.
Conclusión
El aprendizaje automático es la práctica de enseñar a los ordenadores a aprender patrones a partir de datos y aplicar esos patrones a situaciones nuevas. Es uno de los principales motores de la IA moderna, desde las recomendaciones y la detección de fraude hasta las herramientas médicas y la investigación científica.
El concepto es sencillo, pero su aplicación requiere cuidado. Un buen aprendizaje automático necesita buenos datos, objetivos claros, pruebas, supervisión y un uso responsable. Los mejores modelos no son solo ingeniosos. Son útiles, fiables y adecuados para las personas a las que afectan.
Preguntas frecuentes (FAQ)
P: ¿Qué es el aprendizaje automático?
R: El aprendizaje automático es una rama de la IA en la que los ordenadores aprenden patrones a partir de datos y utilizan esos patrones para hacer predicciones, recomendaciones o tomar decisiones.
P: ¿Es el aprendizaje automático lo mismo que la inteligencia artificial?
R: No. La IA es el campo más amplio. El aprendizaje automático es un método utilizado para crear sistemas de IA. El aprendizaje profundo es una categoría más pequeña dentro del aprendizaje automático.
P: ¿Cuáles son ejemplos comunes de aprendizaje automático?
R: Algunos ejemplos comunes incluyen sistemas de recomendaciones, filtros de spam, detección de fraude, reconocimiento de voz, clasificación de imágenes, herramientas de traducción y algunos sistemas médicos de IA.
P: ¿Se necesita programar para aprender aprendizaje automático?
R: Puedes entender las ideas básicas sin programar, pero crear modelos reales de aprendizaje automático suele requerir habilidades de programación, estadística, gestión de datos y pruebas.


