Kimi K3 Open Day: 2.8 Trilyong Parameter, Bukas na ang mga Timbang
Noong Hulyo 27, 2026, idinaos ng Moonshot AI ang Kimi K3 Open Day at inanunsyo ang tatlong magkakaugnay na paglulunsad: ang mga bigat ng modelong Kimi K3, ang opisyal na teknikal na anunsyo, at tatlong teknolohiyang pang-imprastraktura: MoonEP, FlashKDA, at AgentEnv. Ipinakita ng kaganapan ang Kimi K3 hindi lamang bilang isang bagong malakihang modelo, kundi bilang isang paglulunsad na sumasaklaw sa pag-access sa modelo, arkitektura, at imprastraktura ng deployment.
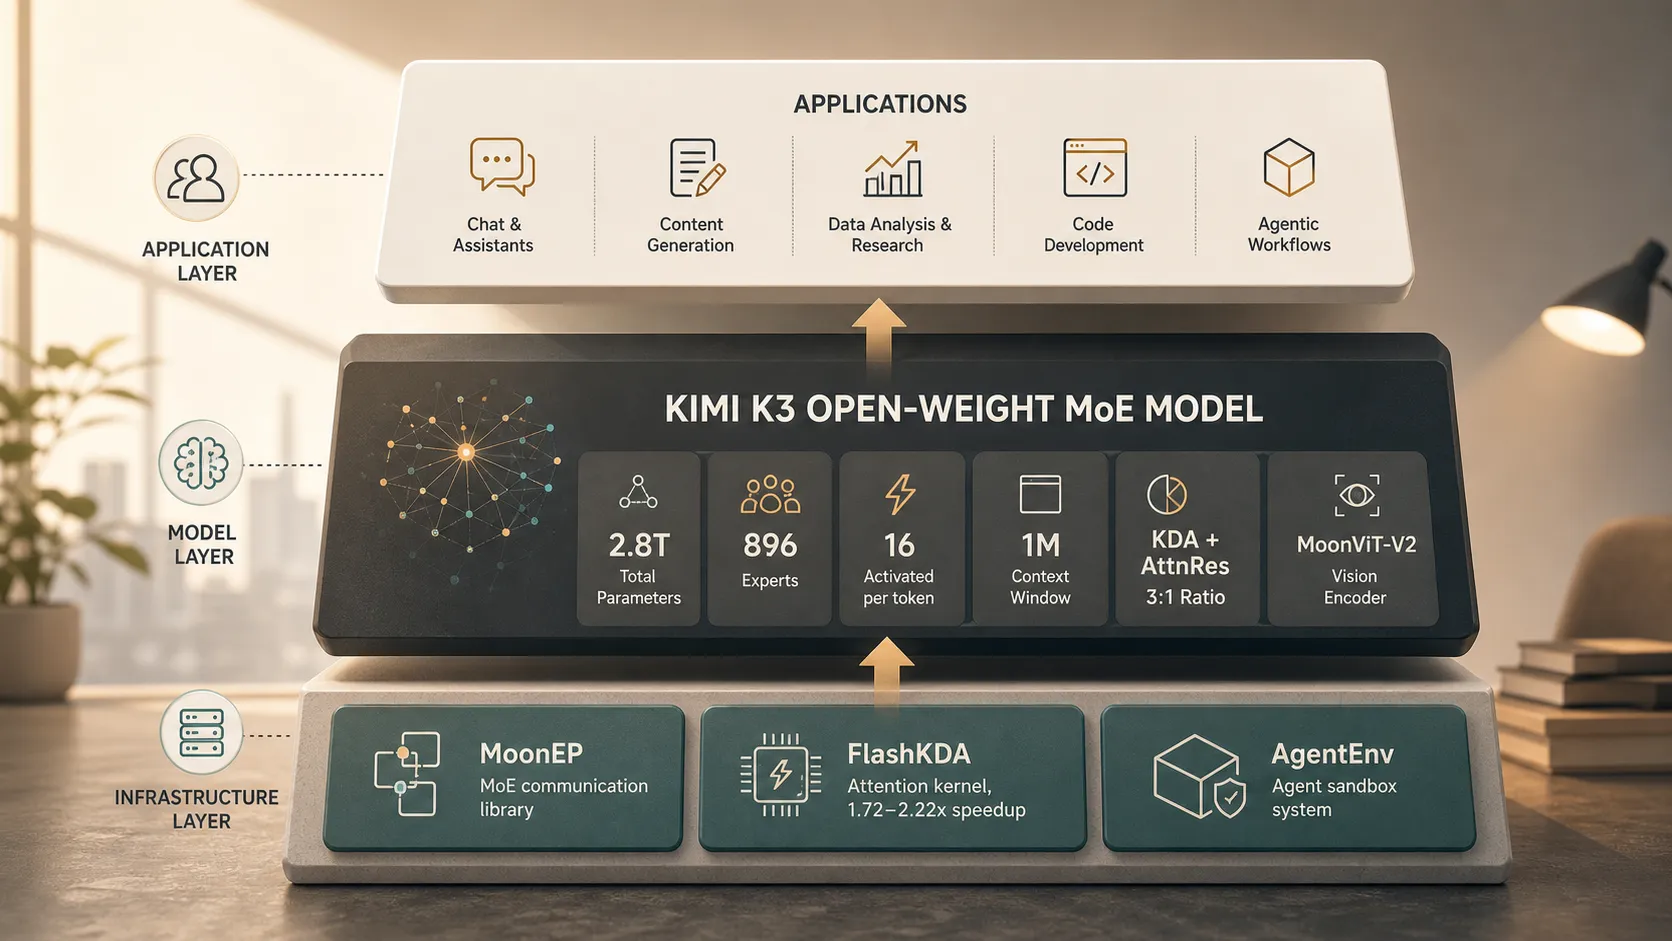
Malinaw ang pangunahing espesipikasyon: ang Kimi K3 ay isang open-weight na modelo na may 2.8 trilyong parameter na binuo sa arkitekturang Mixture of Experts (MoE). Inilahad ng Moonshot AI ang mahahalagang teknikal na detalye, kabilang ang 896 na eksperto, 16 na ekspertong ina-activate kada token, isang 1M-token na context window, KDA + AttnRes sa 3:1 na ratio, MoonViT-V2, at iniulat na 2.5x na pagpapabuti sa scaling efficiency.
Mahalaga ang terminong open-weight. Ang open-weight ay nangangahulugang ginagawang available ang mga sinanay na bigat ng modelo sa ilalim ng itinakdang mga tuntunin. Hindi ito awtomatikong nangangahulugang ganap na open-source ang modelo, na karaniwang nagpapahiwatig ng mas malawak na access sa source code, training data, mga tool, at reproduction pipeline. Gayunpaman, maaaring baguhin ng open-weight access kung paano nagde-deploy, nagsisiyasat, at bumubuo ang mga developer at organisasyon sa paligid ng isang pangunahing AI model.
Ibinuod ng Moonshot AI ang halaga ng pamamaraang ito sa pagsasabing “ang mga open-weight model... ay nagpapababa ng hadlang sa pag-access sa katalinuhan, nagtutulak ng inobasyon, at nagbibigay sa mga user ng higit na kontrol sa data, privacy, at pagmamay-ari.”
Ang Open Day Event: Tatlong Pangunahing Paglulunsad
Nakatuon ang Kimi K3 Open Day sa tatlong kategorya ng paglulunsad.
Una, inilabas ng Moonshot AI ang mga bigat ng modelong Kimi K3. Ito ang pangunahing anunsyo ng open-weight. Para sa mga tagabuo, maaaring magbigay ang access sa mga bigat ng mas flexible na deployment kaysa sa API lamang na naka-host, lalo na kapag kailangan ng mga team ng kontrol sa imprastraktura, latency, privacy, o data residency.
Ikalawa, inilathala ng Moonshot AI ang teknikal na ulat ng Kimi K3. Mahalaga ito dahil hindi masusuri ang mga anunsyo ng malalaking modelo batay lamang sa bilang ng parameter. Tinutukoy ng arkitektura, estratehiya sa routing, disenyo para sa mahabang context, multimodal na kakayahan, at mga pahayag sa efficiency kung kapaki-pakinabang ang isang modelo sa aktuwal na paggamit.
Ikatlo, inilabas ng Moonshot AI ang MoonEP, FlashKDA, at AgentEnv. Tina-target ng mga teknolohiyang pang-imprastrakturang ito ang komunikasyon ng eksperto, performance ng attention, at pagpapatakbo ng agent. Ipinapakita ng pagsasama ng mga ito na ang Kimi K3 Open Day ay hindi lamang paglulunsad ng modelo; isa rin itong paglulunsad ng imprastraktura para mas epektibong magamit ang napakalalaking open-weight model.
Ang Modelo: Mahahalagang Espesipikasyon
Ang Kimi K3 ay isang MoE model na may 2.8 trilyong parameter. Sa arkitekturang Mixture of Experts, bahagi lamang ng modelo ang ina-activate para sa bawat token. Pinipili ng router ang isang subset ng mga eksperto, na nagbibigay-daan sa system na pagsamahin ang napakalaking kabuuang kapasidad sa mas mababang aktibong compute kaysa sa dense model na may kahalintulad na laki.
Ayon sa Moonshot AI, ang Kimi K3 ay may 896 na eksperto, kung saan 16 na eksperto ang ina-activate kada token. Sentral ang disenyong ito sa profile ng efficiency ng modelo. Nagbibigay-daan ito sa modelo na magkaroon ng napakalaking kabuuang kapasidad habang gumagamit ng piling activation sa panahon ng inference.
| Espesipikasyon | Opisyal na Detalye ng Kimi K3 |
|---|---|
| Kabuuang Parameter | 2.8 trilyon |
| Arkitektura | Mixture of Experts (MoE) |
| Alokasyon ng Eksperto | 896 na eksperto / 16 na ina-activate kada token |
| Context Window | 1M token |
| Disenyo ng Attention | KDA + AttnRes sa 3:1 na ratio |
| Arkitektura ng Vision | MoonViT-V2 |
| Scaling Efficiency | 2.5x na pagpapabuti |
Ang 1M-token na context window ay isa sa mga pinakapraktikal na espesipikasyon. Maaaring suportahan ng mahabang context ang pagsusuri ng buong dokumento, pagrepaso ng malalaking codebase, pangangatwiran sa maraming file, mga workflow para sa legal o pinansyal na dokumento, at mas mahahabang gawain ng agent nang hindi kailangang hati-hatiin ang bawat input sa maliliit na piraso.
Gumagamit din ang Kimi K3 ng KDA + AttnRes sa 3:1 na ratio, isang hybrid na disenyo ng attention na kaugnay ng estratehiya nito para sa mahabang context. Kasama sa modelo ang MoonViT-V2 bilang arkitektura nito sa vision, na nagpapahiwatig ng katutubong multimodal na kakayahan sa halip na purong text-only na system. Iniulat din ng Moonshot AI ang 2.5x na pagpapabuti sa scaling efficiency, na nagmumungkahing idinisenyo ang Kimi K3 hindi lamang para sa laki, kundi para rin sa mas praktikal na ekonomiya ng training at inference.
Ang Paglulunsad ng Infra: MoonEP, FlashKDA, at AgentEnv.
Kailangan pa rin ng mga open-weight model ng matitibay na system sa paligid ng mga ito. Umaasa ang malalaking MoE model sa mahusay na komunikasyon, mabilis na attention kernel, at ligtas na mga kapaligiran sa pagpapatakbo. Direktang tinutugunan ng paglulunsad ng imprastraktura ng Moonshot AI ang mga pangangailangang ito.
MoonEP: Komunikasyon ng MoE Expert
Ang MoonEP ay isang communication library para sa MoE expert parallelism. Sa mga MoE system, niruruta ang mga token sa iba't ibang eksperto, at maaaring nakabahagi ang mga ekspertong iyon sa maraming device. Lumilikha ito ng mga hamon sa komunikasyon na maaaring maglimita sa throughput at magpataas ng latency.
Para sa Kimi K3, na may 896 na eksperto at 16 na ina-activate kada token, malaking problemang pang-system ang expert routing. Dinisenyo ang MoonEP upang pahusayin ang distributed expert communication at bawasan ang mga bottleneck sa malakihang MoE deployment.
FlashKDA: Mas Mabilis na Long-Context Attention
Ang FlashKDA ay isang attention kernel na in-optimize para sa KDA. Lalo na mahalaga ang papel nito para sa mga workload na may mahabang context, kung saan maaaring maging magastos ang prefill computation. Iniulat ng Moonshot AI na naghahatid ang FlashKDA ng 1.72x hanggang 2.22x na pagpapabilis sa prefill performance sa mga Nvidia H20 GPU kumpara sa mga flash-linear-attention baseline.
Mahalaga ito dahil kapaki-pakinabang lamang ang 1M-token na context window kung mahusay itong maibibigay. Maaaring gawing mas praktikal sa production ng mas mabilis na attention kernel ang pagsusuri ng mahahabang dokumento, code review, mga workflow sa pananaliksik, at multi-step na pangangatwiran.
AgentEnv: Sandbox para sa mga AI Agent
Ang AgentEnv ay isang agent sandbox system na magkasamang binuo kasama ang KVCache.ai. Nagbibigay ito ng nakahiwalay na sandbox environment para sa mga agent na kailangang magsagawa ng mga hakbang, subukan ang mga aksyon, mag-fork ng state, mag-restore ng mga naunang state, o magpatakbo ng magkakaparis na branch.
Ang mga workflow ng agent ay kadalasang nagsasangkot ng higit pa sa pagbuo ng text. Maaari silang gumamit ng mga file, tool, code execution, at multi-step na pagpapasya. Nakakatulong ang sandbox na ihiwalay ang pag-uugali ng agent mula sa mga panlabas na system habang sinusuportahan ang eksperimento. Kapaki-pakinabang ang mga feature ng AgentEnv na snapshot, restore, at fork kapag kailangang galugarin ng mga agent ang maraming landas bago magbigay ng pangwakas na resulta.
Bakit Mahalaga ang Open-Weight
Binabago ng open-weight access ang ugnayan sa pagitan ng mga provider ng modelo at mga tagabuo. Maaaring makapangyarihan ang isang saradong hosted API, ngunit nananatiling kontrolado ng provider ang imprastraktura, hosting, daloy ng data, at mga limitasyon sa operasyon. Nagbibigay ang open-weight model sa mga kwalipikadong team ng mas malaking puwang upang i-deploy, iangkop, i-optimize, at isama ang modelo sa sarili nilang mga system.
Para sa mga enterprise, ang pinakamalaking bentahe ay kontrol sa deployment at data. Ang mga sensitibong dokumento, panloob na code, legal na rekord, impormasyon ng customer, at pinansyal na materyal ay maaaring mangailangan ng pribadong imprastraktura. Maaaring suportahan ng open-weight access ang lokal o pribadong-cloud na deployment kung saan pangunahing kinakailangan ang pamamahala ng data, privacy, at pagmamay-ari.
Para sa mga developer, nagbibigay ang open-weight access ng mas malalim na teknikal na integrasyon. Maaaring i-optimize ng mga team ang mga inference stack, subukan ang mga paraan ng adaptation, at bumuo ng mga workflow batay sa mga lakas ng modelo. Ang MoE scale ng Kimi K3, 1M-token na context, vision capability ng MoonViT-V2, at mga inilunsad na imprastraktura ay lumilikha ng pundasyon para sa mga espesyalisadong aplikasyon.
Nananatiling mahalaga ang pagkakaiba nito sa open-source. Hindi awtomatikong ibinibigay ng open-weight ang training data, source pipeline, o buong recipe para sa reproduction. Gayunpaman, maaari pa rin nitong pababain ang mga praktikal na hadlang para sa mga team na nangangailangan ng access sa modelo, pribadong deployment, o higit na kontrol sa performance at privacy.
Ang Hatol: Paglulunsad ng Modelo at Imprastraktura
Pinakamainam na unawain ang Open Day ng Kimi K3 bilang isang magkakaugnay na paglulunsad sa tatlong antas: pag-access sa modelo, teknikal na pagbubunyag, at imprastraktura ng deployment. Ang MoE model na may 2.8 trilyong parameter ang sentro ng anunsyo, ngunit mahalaga ang teknikal na ulat at mga tool sa imprastraktura upang maunawaan ang mas malawak nitong kahalagahan.
Malalaki ang opisyal na espesipikasyon: 2.8T kabuuang parameter, 896 na eksperto na may 16 na ina-activate kada token, isang 1M-token na context window, KDA + AttnRes sa 3:1 na ratio, MoonViT-V2, at iniulat na 2.5x na pagpapabuti sa scaling efficiency. Ipinapakita ng MoonEP, FlashKDA, at AgentEnv na tinutugunan din ng Moonshot AI ang mga system na kailangan upang mabisang mapatakbo ang malalaking open-weight model.
Ang Kimi K3 ay hindi inilalarawan bilang ganap na open-source; ito ay open-weight. Gayunpaman, sa paglalabas ng mga bigat, teknikal na detalye, at sumusuportang imprastraktura, ginawa ng Moonshot AI ang Kimi K3 na isang mahalagang pangyayari sa pagbuo ng malakihang open-weight AI.
Mga Madalas Itanong (FAQ)
T: Ano ang Kimi K3?
S: Ang Kimi K3 ay isang open-weight na Mixture of Experts AI model mula sa Moonshot AI na may 2.8 trilyong parameter, na inanunsyo sa Kimi K3 Open Day noong Hulyo 27, 2026.
T: Ano ang ibig sabihin ng open-weight?
S: Ang open-weight ay nangangahulugang naa-access ang mga sinanay na bigat ng modelo sa ilalim ng itinakdang mga tuntunin sa lisensya. Naiiba ito sa open-source, na karaniwang nagpapahiwatig ng mas malawak na access sa source code, data, at reproduction pipeline.
T: Anong mga teknolohiyang Infra ang inilabas kasama ng Kimi K3?
S: Inilabas ng Moonshot AI ang MoonEP, FlashKDA, at AgentEnv. Sinusuportahan ng MoonEP ang komunikasyon ng MoE, pinapabilis ng FlashKDA ang KDA attention, at nagbibigay ang AgentEnv ng sandbox system para sa mga AI agent.
T: Ano ang pinakamahahalagang espesipikasyon ng Kimi K3?
S: Ang Kimi K3 ay may 2.8T kabuuang parameter, 896 na eksperto na may 16 na ina-activate kada token, 1M-token na context window, KDA + AttnRes sa 3:1 na ratio, MoonViT-V2, at 2.5x na pagpapabuti sa scaling efficiency.


