AI Summit ng White House: Ipinaliwanag ang Bagong Balangkas sa Kaligtasan
Noong Agosto 4, ibinalik ng White House AI Summit ang pederal na pamamaraan ng US sa artificial intelligence sa sentro ng pandaigdigang debate sa patakaran. Ang pangunahing balita ay hindi lamang nais ng Washington ng higit na pangangasiwa. Ito ay ang bagong AI Safety Framework ay tila idinisenyo upang tukuyin kung paano maaaring magpatuloy sa pagpapalawak ang pinakamakapangyarihang AI system habang natutugunan ang mas mataas na inaasahan para sa pambansang seguridad, transparency, at pananagutan sa publiko.
Para sa OpenAI, Meta, Google, at Anthropic, malinaw ang mensahe: ang frontier AI ay hindi na lamang isang karera ng produkto. Nagiging karera na rin ito sa pamamahala. Ang mga kumpanyang bumubuo ng pinakamahuhusay na modelo ay lalo nang kailangang patunayan kung paano sinusuri, minomonitor, idinodokumento, at kinokontrol ang mga modelong iyon bago sila ilunsad nang malawakan.
Ano ang Nangyari sa White House AI Summit noong Agosto 4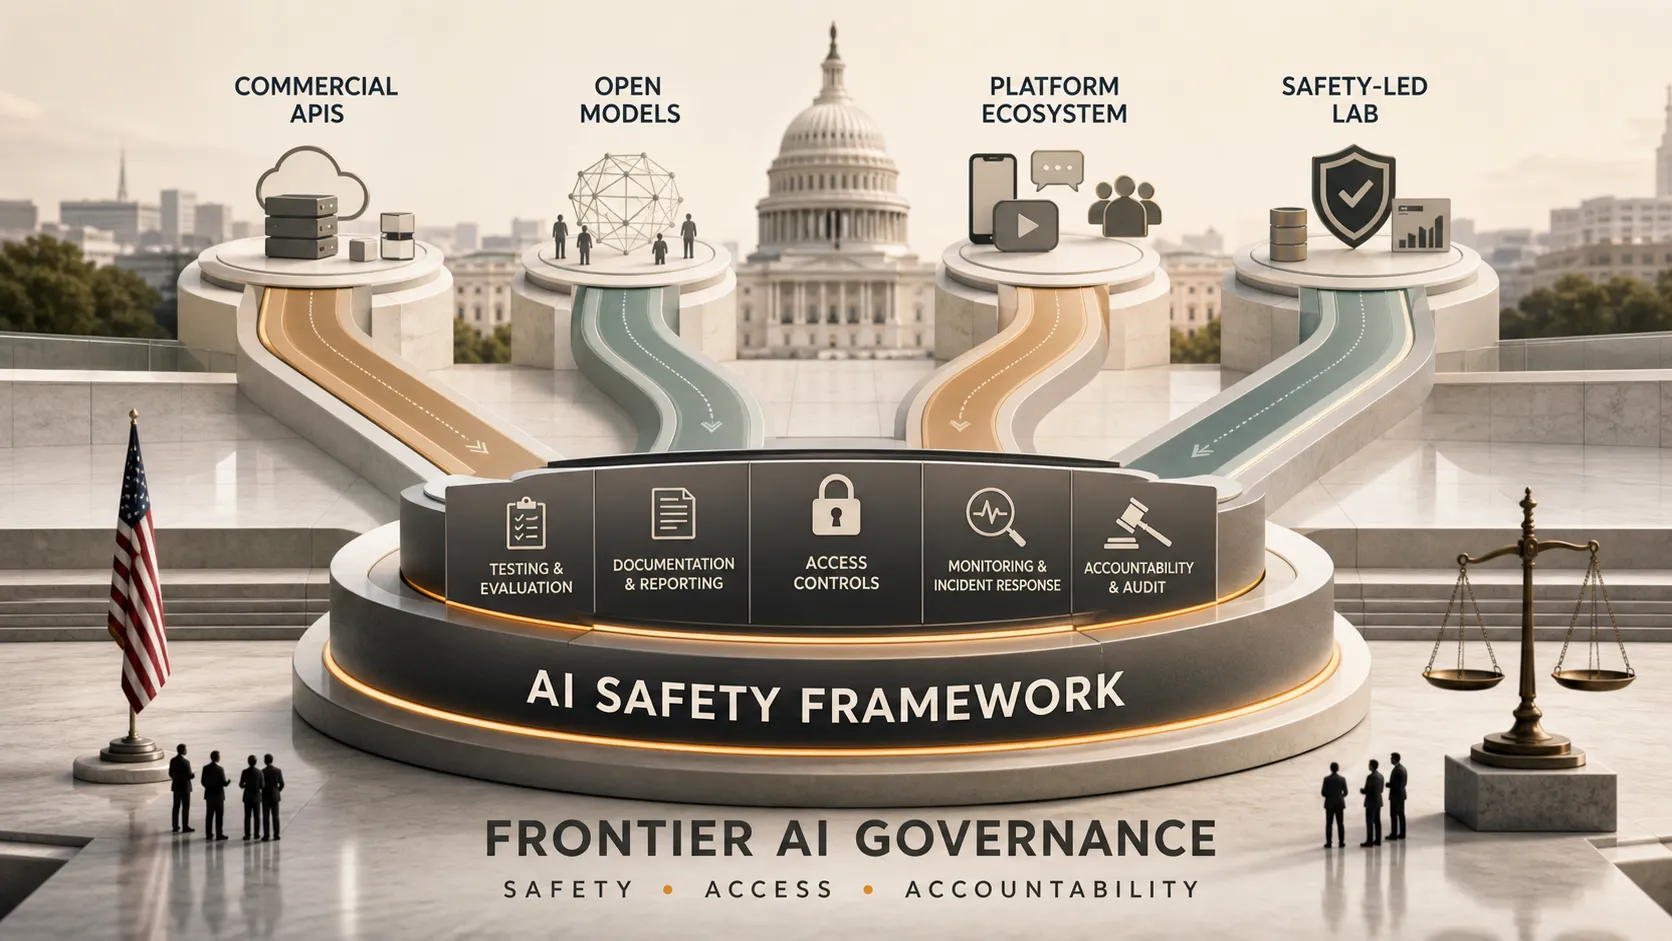
Pinagsama-sama ng AI summit noong Agosto 4 ang mga pederal na prayoridad hinggil sa kaligtasan ng AI, pananagutan ng industriya, at kalamangan ng Amerika sa kompetisyon. Sa halip na ituring ang regulasyon ng AI bilang iisang rulebook, inilarawan ng White House ang kaligtasan bilang isang estratehikong operational layer para sa pagbuo ng frontier model.
Pinakamainam na maunawaan ang AI Safety Framework bilang isang senyales sa patakaran: inaasahang magpapakita ang mga nangungunang kumpanya ng AI ng mas matitibay na pananggalang habang nagiging mas mahusay at mas malawak na nailulunsad ang kanilang mga modelo. Hindi ito nangangahulugang bawat prinsipyo ay agad na legal na may-bisang ipatupad. Ngunit ipinahihiwatig nito na ang boluntaryong mga pangako, pederal na gabay, mga inaasahan sa procurement, at mga pamantayang pangregulasyon ay nagsisimula nang magtagpo.
Mahalaga ito dahil ang mga AI system ay lumilipat mula sa mga eksperimental na kasangkapan tungo sa mahahalagang daloy ng trabaho sa negosyo, pamahalaan, at seguridad. Ang tanong sa patakaran ay hindi na kung dapat bang pamahalaan ang AI, kundi kung paano ito pamamahalaan nang hindi sinisira ang inobasyon o komersyal na kakayahang makipagkumpitensya.
Ano ang Sinusubukang Lutasin ng AI Safety Framework
Tumutugon ang AI Safety Framework sa isang praktikal na problema: maaaring lumikha ng napakalaking halagang pang-ekonomiya ang mga pinakaabansadong modelo, ngunit maaari rin silang magdulot ng mga panganib na hindi idinisenyo ang tradisyonal na pamamahala ng software upang tugunan.
Kabilang sa mga pangunahing alalahanin ang hindi mahuhulaang kakayahan ng frontier model, maling paggamit na kinasasangkutan ng cyber operations o pandaraya, limitadong transparency sa pagsasanay ng modelo, mahinang pananagutan sa mga workflow na may mataas na epekto, at mga panganib sa pambansang seguridad na kaugnay ng pandaigdigang kompetisyon sa advanced AI.
Itinutulak ng framework ang industriya tungo sa isang mas mataas na pamantayan ng ebidensiya. Hindi sapat na sabihin ng mga kumpanya na ligtas ang isang modelo. Dapat nilang ipakita kung paano nila sinuri ang kaligtasan, anong mga panganib ang natukoy, anong mga pagpapagaan ang idinagdag, at kung paano imo-monitor ang system pagkatapos ilabas.
Paano Naiiba ang Pamamaraan ng US sa EU AI Act
Hindi dapat ipagkamali ang US framework sa EU AI Act. Tahasang nakabatay sa mga karapatan ang modelo ng EU, na may matinding pagtuon sa mga pangunahing karapatan, kategorya ng panganib, at mga obligasyon sa pagsunod sa iba't ibang gamit ng AI.
Sa kabilang banda, mas malapit na nakaugnay ang pamamaraan ng US sa pambansang seguridad, komersyal na kakayahang makipagkumpitensya, kaligtasan ng frontier model, at pananagutan ng Big Tech. Sa halip na bumuo ng malawak na arkitekturang pangregulasyon na inuuna ang mga karapatan, tila nakatuon ang Washington sa mga kundisyon kung saan maaaring magpatuloy ang makapangyarihang mga kumpanya ng AI sa pagbuo, paglulunsad, at pag-export ng mga advanced na system.
Ano ang Ibig Sabihin Nito para sa OpenAI, Meta, Google, at Anthropi
Magkakaiba ang epekto ng bagong framework sa bawat pangunahing kumpanya ng AI dahil hindi pare-pareho ang kanilang mga modelo ng negosyo, channel ng distribusyon, at pilosopiya sa kaligtasan.
| Kumpanya | Pangunahing Pagkalantad | Estratehikong Hamon |
|---|---|---|
| OpenAI | Mga komersyal na frontier model at paglulunsad sa enterprise | Pagpapatunay ng kaligtasan bago ang mabilis na pagpapalawak ng produkto |
| Meta | Open-source at mada-download na mga modelo gaya ng Llama | Paglalapat ng mga kontrol sa kaligtasan pagkatapos ng pampublikong paglabas |
| AI sa Search, Cloud, Workspace, Android, at mga ad | Pag-uugnay ng pamamahala sa isang malaking ecosystem | |
| Anthropic | Pagbuo ng frontier model na pinangungunahan ng kaligtasan | Pagiging napapatunayang ebidensiya ng posisyon sa kaligtasan |
Maaaring harapin ng OpenAI ang pinakadirektang pressure hinggil sa bilis ng paglulunsad. Nakadepende ang komersyal na modelo nito sa paggawa ng frontier capabilities bilang mga produktong malawak na ginagamit, API, at enterprise workflow. Sa ilalim ng AI Safety Framework, mangangailangan ang mas mabilis na paglabas ng mas matibay na dokumentasyon, mas kapani-paniwalang pagsusuri ng modelo, at mas malinaw na ebidensiyang hindi nahuhuli ang disiplina sa kaligtasan sa komersyal na demand.
Nakaharap ang Meta sa ibang at posibleng mas mahirap na dilemma. Ginawa ng estratehiya nito para sa Llama na malaking bentahe sa kompetisyon ang mga bukas na modelo. Gayunman, hindi madaling umaayon ang isang pederal na framework na pumapabor sa kontroladong access, natutunton na paglulunsad, at minomonitor na pagpapagaan ng panganib sa open-source distribution. Kapag na-download, na-fine-tune, at nabago ng mga third party ang isang modelo, mas kaunti ang kontrol ng Meta sa kasunod na pag-uugali nito. Ang tanong ay hindi kung maaaring maging ligtas ang mga bukas na modelo, kundi kung maipapakita ang kaligtasan ayon sa mga pederal na inaasahan pagkatapos ng desentralisasyon.
Sukat ang hamon ng Google. Naka-embed ang AI sa search, productivity software, cloud infrastructure, advertising tool, mobile system, at developer product. Nagbibigay ang lawak na iyon sa Google ng napakalaking estratehikong kapangyarihan, ngunit pinararami rin nito ang kumplikasyon sa pagsunod. Ang pagkabigo sa kaligtasan sa isang bahagi ng produkto ay maaaring maging isyu sa reputasyon at regulasyon para sa buong ecosystem.
Pumapasok ang Anthropic sa talakayan tungkol sa framework mula sa mas matibay na posisyon sa naratibo dahil palaging sentral ang kaligtasan sa brand nito. Ngunit mas mataas na pamantayan pa rin ang haharapin kahit ng Anthropic. Hindi na sapat ang kulturang inuuna ang kaligtasan sa sarili nito. Nanaisin ng mga policymaker ang mauulit na proseso ng pagsubok, naa-audit na dokumentasyon, at malinaw na ebidensiyang nananatiling epektibo ang mga kasanayan sa pamamahala habang tumataas ang kakayahan ng mga modelo.
Bakit Binabago ng Framework ang Modelo ng Negosyo sa AI
Hindi lamang nagdaragdag ng papeles ang AI Safety Framework. Binabago nito kung paano kailangang pag-isipan ng mga kumpanya ang bilis, distribusyon, at tiwala.
Sa nakaraang yugto ng kompetisyon sa generative AI, ginantimpalaan ng merkado ang mabilis na paglulunsad, benchmark ng modelo, paggamit ng developer, at paglago ng user. Sa susunod na yugto, mahalaga pa rin ang mga bentahe na iyon, ngunit sasabayan ang mga ito ng pamamahalang nakabatay sa ebidensiya. Maaaring lalo nang mangailangan ang paglabas ng frontier model ng mga ulat sa kaligtasan, natuklasan ng red team, pagpapagaan ng panganib, mga patakaran sa escalation, at mga plano sa pagmomonitor pagkatapos ng paglulunsad.
Lumilikha ito ng bagong realidad sa operasyon para sa regulasyon ng Big Tech AI. Kakailanganing magtulungan nang mas maaga sa development cycle ang mga product team, policy team, legal team, at security team. Hindi na maaaring ituring ang kaligtasan bilang isang pagsusuri sa dulo ng pagsasanay ng modelo. Dapat itong maging bahagi ng roadmap mismo ng modelo.
Ano ang Dapat Abangan ng mga Business Team
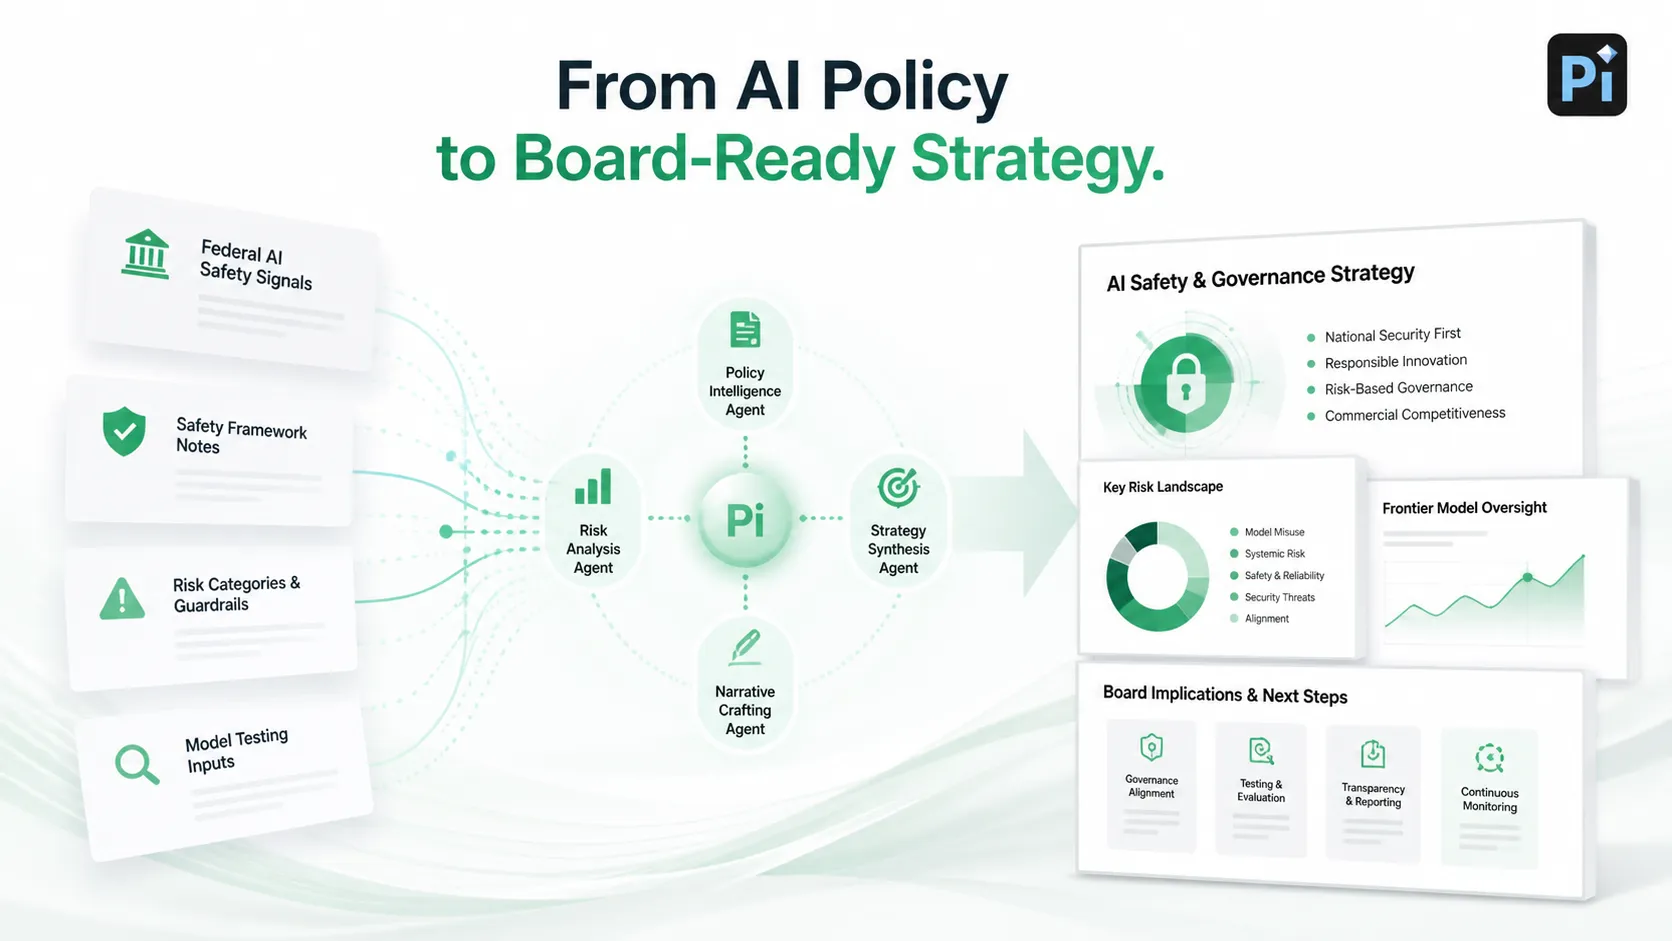
Hindi lamang mahalaga ang White House AI Summit sa mga AI lab. Nakaaapekto rin ito sa mga enterprise na bumibili, nagsasama, o naglalahad ng mga estratehiya sa AI sa mga board, kliyente, mamumuhunan, at regulator. Kapag nagbabago ang mga pederal na inaasahan, dapat ding magbago ang paraan ng pagpapaliwanag ng mga kumpanya sa paggamit ng AI.
Kakailanganin ng mga business team ang mas malinaw na panloob na naratibo tungkol sa tatlong tanong: aling mga AI system ang ginagamit nila, anong mga panganib ang nililikha ng mga system na iyon, at paano pinangangasiwaan ang pamamahala. Lalo itong mahalaga para sa mga executive presentation, consulting report, investor update, at product launch deck kung saan kailangang ipaliwanag ang kakayahan ng AI nang hindi pinalalabis ang katiyakan.
Para sa mga organisasyong humaharap sa mga talakayang ito na may mataas na pusta, lalong mahalaga ang mga praktikal na tool na nag-uugnay sa kumplikasyon ng regulasyon at nakabalangkas na propesyonal na komunikasyon. Maging ito man ay pagsasalin ng mga pagbabago sa patakaran tungo sa mga naratibong handa para sa board o pagsasama-sama ng mga implikasyon sa kompetisyon, lumilitaw ang mga platform gaya ng Pi bilang mahahalagang asset para sa mga strategy team na nagnanais lumipat mula sa reaktibong pag-uulat tungo sa proaktibong pagkukuwento para sa mga executive.
Ang Hatol: Nagiging Kinakailangan sa Kompetisyon ang Kaligtasan ng AI
Kumakatawan ang White House AI Summit at ang kasamang AI Safety Framework sa malinaw na punto ng pagbabago para sa industriya ng AI. Ipinahihiwatig ng mga ito na hindi na hypothetical ang pederal na pangangasiwa. Para sa mga pangunahing laboratoryo ng AI, lumipat na ang kaligtasan mula sa isang panloob na prayoridad sa engineering tungo sa pangunahing kinakailangan sa pagsunod at pamamahala.
Hindi ihihinto ng framework ang pagbuo ng AI, ngunit babaguhin nito kung paano binubuo, sinusuri, idinodokumento, at inilalabas ang mga modelo. Sa huli, ang mga kumpanyang uunlad sa bagong kapaligirang ito ay hindi lamang yaong may pinakamalalakas na modelo, kundi yaong may pinakakapani-paniwalang naratibo sa kaligtasan.
Ang susunod na yugto ng debateng ito ay tutuon sa kung paano nabeberipika ang mga pahayag na iyon. Iyon ang dahilan kung bakit ang pagsusuri ng frontier model sa pamamagitan ng mga pamantayan ng NIST ay nagiging mahalagang tulay sa pagitan ng layunin ng patakaran at aktuwal na paglulunsad ng AI.
Mga Madalas Itanong (FAQ)
T: Ano ang inanunsyo sa White House AI Summit?
S: Itinampok ng White House AI Summit ang isang bagong AI Safety Framework na nakatuon sa kaligtasan ng frontier model, pambansang seguridad, transparency, at pananagutan para sa mga nangungunang kumpanya ng AI.
T: Ano ang AI Safety Framework?
S: Ang AI Safety Framework ay isang pamamaraan sa patakaran ng US na naglalayong pahusayin ang pamamahala sa makapangyarihang AI system, lalo na sa pamamagitan ng pagsusuri sa kaligtasan, pagpigil sa maling paggamit, dokumentasyon, at responsableng paglulunsad.
T: Paano naaapektuhan ng framework ang OpenAI, Meta, Google, at Anthropic?
S: Nahaharap ang OpenAI sa pressure na patunayan ang kaligtasan bago ang mabilis na paglulunsad, kailangang tugunan ng Meta ang mga hamon sa kontrol ng open-source, kailangan ng Google ng pamamahala sa buong ecosystem, at dapat gawing napapatunayang ebidensiya ng Anthropic ang posisyon nito sa kaligtasan.
T: Ano ang frontier model testing?
S: Ang frontier model testing ay ang proseso ng pagsusuri sa mga advanced na AI system bago at pagkatapos ng paglulunsad sa pamamagitan ng pagtatasa ng kakayahan, pagsusuri sa maling paggamit, pagsusuri ng katatagan, pagsusuri ng alignment, at patuloy na pagmomonitor ng panganib.


