qu’est-ce que l’apprentissage automatique
Si vous vous demandez ce qu’est l’apprentissage automatique, la réponse la plus simple est la suivante : l’apprentissage automatique est un moyen pour les ordinateurs d’apprendre des modèles à partir de données et d’utiliser ces modèles pour faire des prédictions, des recommandations ou prendre des décisions. Au lieu d’écrire chaque règle à la main, les personnes fournissent au système des exemples, et le système apprend à partir de ceux-ci.
Le glossaire du NIST définit l’apprentissage automatique comme des systèmes informatiques qui s’adaptent et apprennent à partir des données afin d’améliorer leur précision. Cela semble technique, mais l’idée au quotidien est familière : plus le système voit d’exemples utiles, mieux il peut reconnaître les modèles.
qu’est-ce que l’apprentissage automatique en termes simples
L’apprentissage automatique est une branche de l’intelligence artificielle. IBM, Google Cloud, Microsoft Azure et AWS l’expliquent tous de manière similaire : l’apprentissage automatique utilise des données et des algorithmes pour entraîner des systèmes capables de faire des prédictions ou de trouver des modèles sans être explicitement programmés pour chaque cas.
Imaginez que vous apprenez à un enfant à reconnaître les chiens. Vous ne listez pas toutes les formes d’oreilles, longueurs de queue et couleurs de pelage possibles. Vous montrez des exemples. Avec le temps, l’enfant apprend le modèle. L’apprentissage automatique fonctionne dans un esprit similaire, mais avec des données, des mathématiques et des algorithmes.
Comment fonctionne l’apprentissage automatique
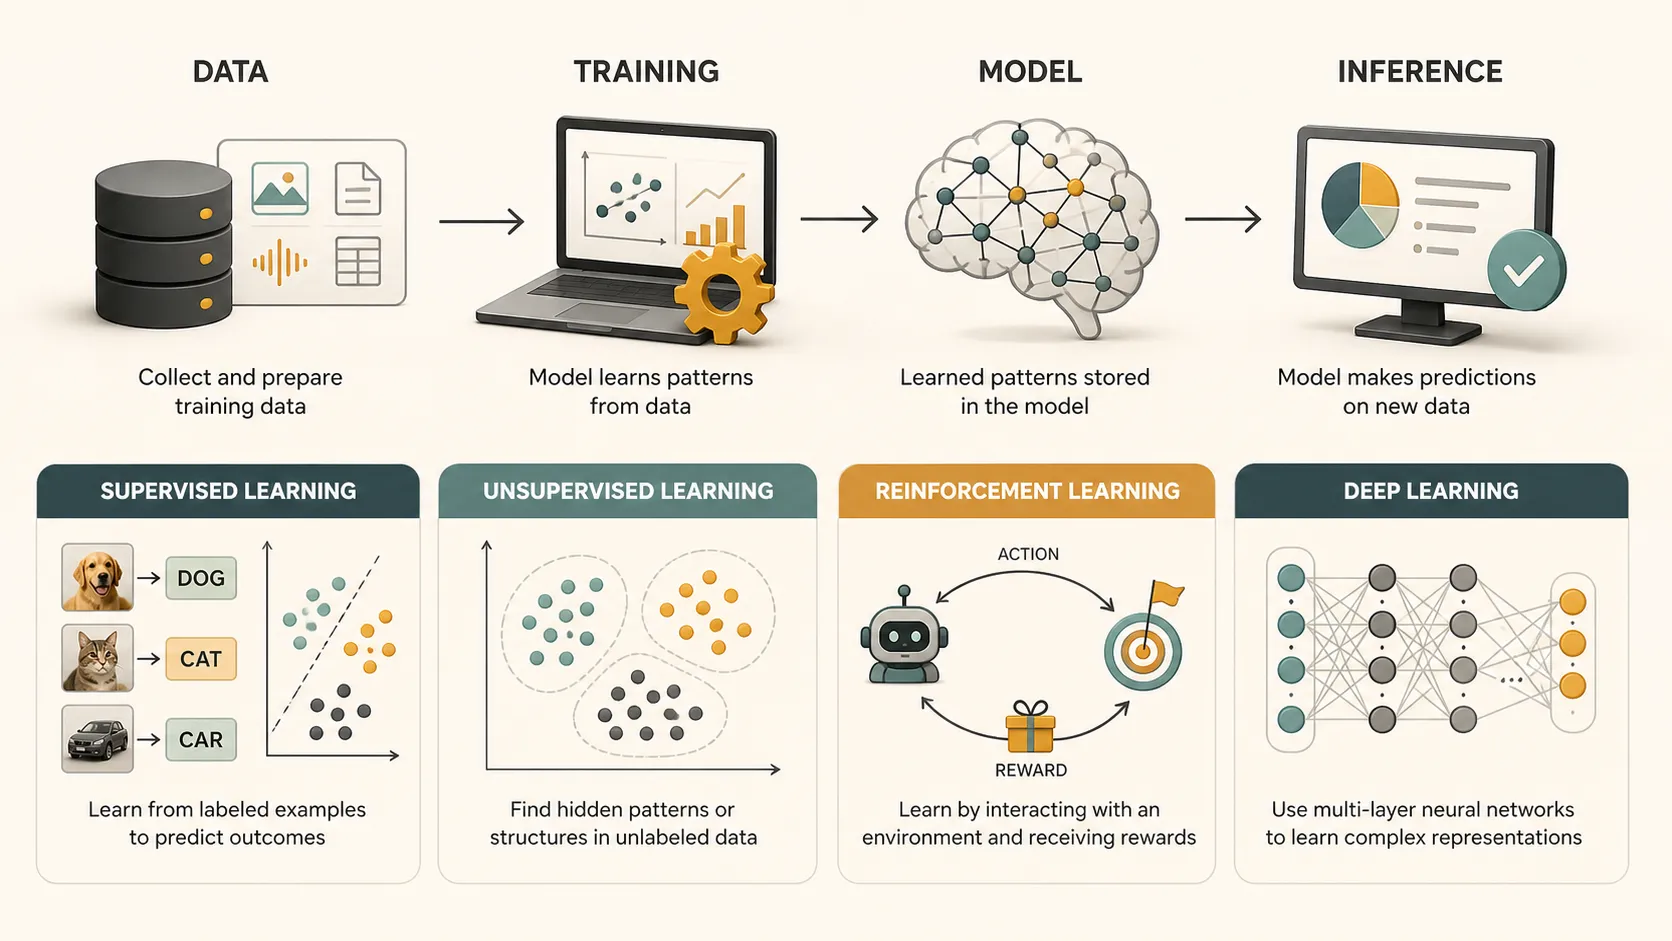
La plupart des projets d’apprentissage automatique suivent un flux de base : collecter les données, les préparer, entraîner un modèle, le tester, puis utiliser le modèle sur de nouvelles entrées. Le guide AWS sur la création d’une application d’apprentissage automatique décrit cela comme un processus itératif : définir le problème, préparer les données, créer des caractéristiques utiles, entraîner le modèle, l’évaluer et l’utiliser pour effectuer des prédictions.
Un filtre antipourriel est un exemple simple. Le système apprend à partir d’e-mails étiquetés « spam » et « non spam ». Pendant l’entraînement, il repère des modèles : liens suspects, phrases répétées, comportement de l’expéditeur ou mise en forme. Lors de l’inférence, il applique ce qu’il a appris à un nouvel e-mail et prédit s’il s’agit de spam.
Le mot important est « prédit ». L’apprentissage automatique ne comprend pas le monde comme une personne. Il trouve des modèles statistiques. Cela peut être puissant, mais cela signifie aussi que la qualité des données est extrêmement importante.
Types courants d’apprentissage automatique
L’apprentissage automatique n’est pas une seule méthode. Il comprend plusieurs approches majeures :
| Type | à quoi sert l’apprentissage automatique ici ? | Exemple |
|---|---|---|
| Apprentissage supervisé | Apprentissage à partir d’exemples étiquetés | Prédire les prix des maisons à partir de ventes passées |
| Apprentissage non supervisé | Trouver des modèles sans étiquettes | Regrouper les clients selon leur comportement |
| Apprentissage par renforcement | Apprentissage par récompenses et pénalités | Entraîner un agent à jouer à un jeu |
| Apprentissage profond | Utiliser des réseaux neuronaux à plusieurs couches | Reconnaissance d’images ou transcription vocale |
Stanford CS229 enseigne l’apprentissage automatique à travers des sujets fondamentaux tels que l’apprentissage supervisé, l’apprentissage non supervisé, les réseaux neuronaux et l’apprentissage par renforcement. Le cours accéléré sur l’apprentissage automatique de Google est également utile aux débutants, car il explique les concepts à l’aide d’exemples pratiques. Pour les personnes qui souhaitent une documentation pratique, le guide utilisateur de scikit-learn et les bases de l’apprentissage automatique avec TensorFlow constituent de solides références techniques.
Apprentissage automatique vs IA vs apprentissage profond
Les gens confondent souvent l’IA, l’apprentissage automatique et l’apprentissage profond. Ils sont liés, mais ne sont pas identiques.
L’intelligence artificielle est le domaine général : créer des systèmes capables d’exécuter des tâches associées à l’intelligence humaine, telles que le raisonnement, le langage, la perception, l’apprentissage ou la prise de décision. L’apprentissage automatique est une manière de créer des systèmes d’IA. L’apprentissage profond est un type d’apprentissage automatique qui utilise des réseaux neuronaux comportant de nombreuses couches.
La relation est donc simple : l’IA est la grande catégorie. L’apprentissage automatique se situe au sein de l’IA. L’apprentissage profond se situe au sein de l’apprentissage automatique.
Une calculatrice suit des règles fixes, ce n’est donc pas de l’apprentissage automatique. Un système de recommandation qui s’améliore en apprenant du comportement des utilisateurs relève de l’apprentissage automatique. Un grand modèle de langage qui utilise des réseaux neuronaux profonds relève de l’apprentissage profond.
Exemples concrets d’apprentissage automatique
L’apprentissage automatique fait déjà partie de la vie quotidienne. Les services de streaming l’utilisent pour recommander des vidéos. Les banques l’utilisent pour détecter les transactions inhabituelles. Les services de messagerie l’utilisent pour filtrer le spam. Les outils de traduction l’utilisent pour convertir les langues. Les moteurs de recherche l’utilisent pour comprendre les signaux de pertinence et de classement.
Dans le domaine de la santé, la FDA tient une liste de dispositifs médicaux dotés d’IA, dont beaucoup utilisent des techniques d’IA ou d’apprentissage automatique pour l’imagerie, le diagnostic ou l’aide clinique. C’est un bon rappel que l’apprentissage automatique peut être utile, mais que les systèmes à forts enjeux nécessitent des tests et une supervision.
La science est un autre exemple marquant. AlphaFold utilise l’IA pour prédire les structures des protéines, aidant les chercheurs à étudier la biologie plus efficacement. Cela montre que l’apprentissage automatique ne sert pas seulement aux publicités, aux applications et aux tableaux de bord ; il peut aussi soutenir la découverte scientifique.
Pourquoi la qualité des données est importante
Un modèle d’apprentissage automatique n’est bon que dans la mesure où les données et les hypothèses qui le sous-tendent le sont. Si les données d’entraînement sont incomplètes, biaisées, obsolètes ou mal étiquetées, le modèle peut apprendre de mauvais modèles.
Par exemple, un modèle de recrutement entraîné sur des données de recrutement passées biaisées peut reproduire ces modèles. Un modèle médical entraîné principalement sur une population peut être moins performant pour une autre. Un modèle de recommandation peut devenir trop étroit et continuer à montrer aux utilisateurs davantage de la même chose.
Un bon travail d’apprentissage automatique inclut le nettoyage des données, les tests, la validation, la surveillance et la révision humaine. Cela implique aussi de poser des questions inconfortables : qui est représenté dans les données ? Qui manque ? Que se passe-t-il si le modèle se trompe ?
Expliquer visuellement l’apprentissage automatique avec Pi
L’apprentissage automatique peut sembler abstrait, car le travail important est souvent invisible : préparation des données, entraînement du modèle, évaluation, déploiement et boucles de rétroaction. Une explication visuelle aide les personnes à voir le processus.
Avec Pi, vous pouvez transformer des concepts d’apprentissage automatique en présentation : un flux de travail des données au modèle, une comparaison entre apprentissage supervisé et non supervisé, un graphique montrant la précision du modèle ou une explication basée sur des icônes de l’entraînement et de l’inférence. Pi peut également personnaliser les thèmes, les couleurs, les mises en page, les icônes, les graphiques et les visuels générés par IA, ce qui rend les idées techniques plus faciles à présenter aux étudiants, aux clients, aux fondateurs ou aux équipes internes.
Risques et utilisation responsable
Les systèmes d’apprentissage automatique peuvent faire des erreurs. Ils peuvent amplifier les biais, exposer des informations privées, créer des résultats injustes ou devenir difficiles à expliquer. C’est pourquoi une IA responsable est importante.
Le cadre de gestion des risques liés à l’IA du NIST donne aux organisations un moyen de réfléchir aux risques liés à une IA digne de confiance. Les principes de l’OCDE sur l’IA mettent l’accent sur les valeurs centrées sur l’humain, l’équité, la transparence, la robustesse, la sécurité et la responsabilité.
Pour les débutants, le message à retenir est simple : l’apprentissage automatique ne doit pas être jugé uniquement sur sa précision. Il doit aussi être jugé sur son équité, sa sécurité, le respect de la vie privée, son explicabilité et son impact dans le monde réel.
Le verdict
L’apprentissage automatique est la pratique qui consiste à apprendre aux ordinateurs à repérer des modèles dans les données et à appliquer ces modèles à de nouvelles situations. C’est l’un des principaux moteurs de l’IA moderne, des recommandations et de la détection des fraudes aux outils médicaux et à la recherche scientifique.
Le concept est simple, mais sa mise en pratique exige de la rigueur. Un bon apprentissage automatique nécessite de bonnes données, des objectifs clairs, des tests, une surveillance et une utilisation responsable. Les meilleurs modèles ne sont pas seulement ingénieux. Ils sont utiles, fiables et adaptés aux personnes qu’ils affectent.
Questions fréquemment posées (FAQ)
Q : Qu’est-ce que l’apprentissage automatique ?
R : L’apprentissage automatique est une branche de l’IA dans laquelle les ordinateurs apprennent des modèles à partir de données et utilisent ces modèles pour faire des prédictions, des recommandations ou prendre des décisions.
Q : L’apprentissage automatique est-il la même chose que l’intelligence artificielle ?
R : Non. L’IA est le domaine plus large. L’apprentissage automatique est une méthode utilisée pour créer des systèmes d’IA. L’apprentissage profond est une catégorie plus restreinte au sein de l’apprentissage automatique.
Q : Quels sont les exemples courants d’apprentissage automatique ?
R : Parmi les exemples courants figurent les systèmes de recommandation, les filtres antipourriel, la détection des fraudes, la reconnaissance vocale, la classification d’images, les outils de traduction et certains systèmes d’IA médicaux.
Q : Faut-il savoir coder pour apprendre l’apprentissage automatique ?
R : Vous pouvez comprendre les idées de base sans coder, mais la création de véritables modèles d’apprentissage automatique exige généralement des compétences en programmation, statistiques, traitement des données et tests.


