Kimi K3 开放日:2.8万亿参数,现已开放权重
2026年7月27日,Moonshot AI 举办了 Kimi K3 Open Day,并宣布了三项相互关联的发布:Kimi K3 模型权重、官方技术公告,以及三项基础设施技术:MoonEP、FlashKDA和AgentEnv。此次活动将Kimi K3定位为不仅是一款新的大规模模型,更是一项涵盖模型访问、架构和部署基础设施的发布。
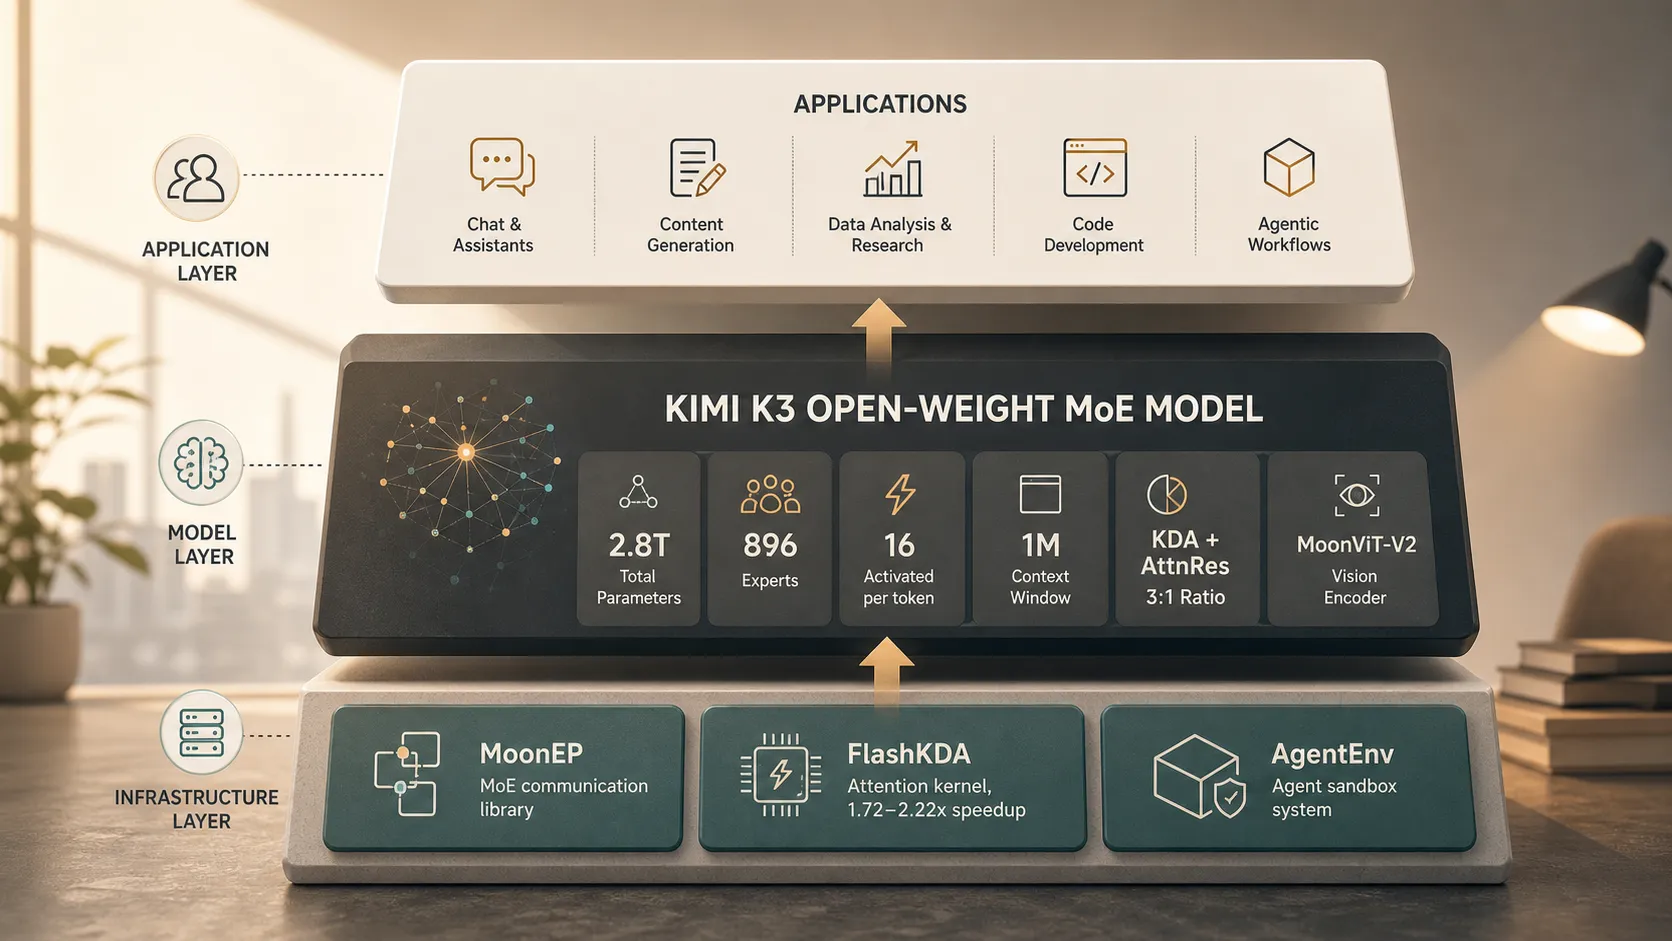
核心规格很明确:Kimi K3 是一款拥有 2.8 万亿参数的开放权重模型,基于专家混合(MoE)架构构建。Moonshot AI 披露了主要技术细节,包括896 个专家、每个 token 激活 16 个专家、100 万 token 上下文窗口、KDA + AttnRes 按 3:1 比例、MoonViT-V2,以及据称扩展效率提升 2.5 倍。
开放权重这一术语很重要。开放权重意味着已训练的模型权重会在规定条款下提供。这并不自动意味着该模型完全开源;完全开源通常意味着可更广泛地访问源代码、训练数据、工具和复现流程。不过,开放权重访问可以改变开发者和组织部署、检查和围绕大型 AI 模型进行构建的方式。
Moonshot AI 对这种方法的价值总结道:“开放权重模型……降低了获取智能的门槛,推动创新,并让用户对数据、隐私和所有权拥有更大的控制权。”
开放日活动:三项核心发布
Kimi K3 Open Day 聚焦于三类发布内容。
首先,Moonshot AI 发布了Kimi K3 模型权重。这是核心的开放权重公告。对于构建者而言,相比仅托管的 API,获得权重可以实现更灵活的部署,尤其是在团队需要控制基础设施、延迟、隐私或数据驻留时。
其次,Moonshot AI 发布了 Kimi K3 技术报告。这一点很重要,因为不能仅凭参数数量来评估大型模型公告。架构、路由策略、长上下文设计、多模态能力和效率声明,决定了模型在实践中是否有用。
第三,Moonshot AI 发布了MoonEP、FlashKDA和AgentEnv。这些基础设施技术面向专家通信、注意力性能和智能体执行。它们的加入表明,Kimi K3 Open Day 不仅是一次模型发布,也是一项帮助更高效使用超大开放权重模型的基础设施发布。
模型:关键规格
Kimi K3 是一款拥有 2.8 万亿参数的 MoE 模型。在专家混合架构中,每个 token 仅激活模型的一部分。路由器会选择一部分专家,使系统能够结合极大的总容量与低于同等规模稠密模型的激活计算量。
据 Moonshot AI 介绍,Kimi K3 拥有896 个专家,其中每个 token 激活 16 个专家。这一设计是模型效率特征的核心。它让模型保持庞大的整体容量,同时在推理期间采用选择性激活。
| 规格 | Kimi K3 官方详情 |
|---|---|
| 总参数量 | 2.8 万亿 |
| 架构 | 专家混合(MoE) |
| 专家配置 | 896 个专家 / 每个 token 激活 16 个 |
| 上下文窗口 | 100 万 token |
| 注意力设计 | KDA + AttnRes,比例为 3:1 |
| 视觉架构 | MoonViT-V2 |
| 扩展效率 | 提升 2.5 倍 |
100 万 token 上下文窗口是最具实用性的规格之一。长上下文可以支持整篇文档分析、大型代码库审查、多文件推理、法律或金融文档工作流,以及更长的智能体任务,而无需将每个输入强行拆分为小片段。
Kimi K3还采用KDA + AttnRes 按 3:1 的比例,这是一种与其长上下文策略相关的混合注意力设计。该模型采用MoonViT-V2作为其视觉架构,表明其具备原生多模态能力,而非纯文本系统。Moonshot AI 还报告了扩展效率提升 2.5 倍,这表明 Kimi K3 的设计不仅面向规模,也面向更实用的训练和推理经济性。
基础设施发布:MoonEP、FlashKDA和AgentEnv。
开放权重模型仍需要强大的周边系统。大型 MoE 模型依赖于高效通信、快速注意力内核和安全的执行环境。Moonshot AI 的基础设施发布直接满足了这些需求。
MoonEP:MoE 专家通信
MoonEP是一个用于 MoE 专家并行的通信库。在 MoE 系统中,token 会被路由至不同专家,而这些专家可能分布在多个设备上。这会带来通信挑战,可能限制吞吐量并增加延迟。
对于拥有896 个专家且每个 token 激活 16 个专家的 Kimi K3 而言,专家路由是一个重要的系统问题。MoonEP 旨在改善分布式专家通信,并减少大规模 MoE 部署中的瓶颈。
FlashKDA:更快的长上下文注意力
FlashKDA是一个针对 KDA 优化的注意力内核。对于长上下文工作负载而言,它的作用尤为重要,因为预填充计算可能变得昂贵。Moonshot AI 报告称,与 flash-linear-attention 基线相比,FlashKDA 在 Nvidia H20 GPU 上的预填充性能实现了1.72 倍至 2.22 倍加速。
这很重要,因为只有能够高效提供服务时,100 万 token 上下文窗口才有用。更快的注意力内核可以让长文档分析、代码审查、研究工作流和多步推理在生产环境中更加实用。
AgentEnv:AI 智能体沙箱
AgentEnv是与 KVCache.ai 共同开发的智能体沙箱系统。它为需要执行步骤、测试操作、分叉状态、恢复先前状态或运行并行分支的智能体提供隔离的沙箱环境。
智能体工作流通常不止包含文本生成。它们可能使用文件、工具、代码执行和多步决策。沙箱在支持实验的同时,有助于将智能体行为与外部系统隔离开来。当智能体需要在生成最终结果前探索多条路径时,AgentEnv 的快照、恢复和分叉功能非常有用。
开放权重为何重要
开放权重访问改变了模型提供商与构建者之间的关系。封闭式托管 API 可以很强大,但基础设施、托管、数据流和运营限制仍由提供商控制。开放权重模型让具备条件的团队拥有更多空间来部署、适配、优化并将模型集成到自己的系统中。
对于企业而言,最大优势是部署和数据控制。敏感文档、内部代码、法律记录、客户信息和财务材料可能需要私有基础设施。开放权重访问可以支持本地或私有云部署,在这些场景中,数据治理、隐私和所有权是核心要求。
对于开发者而言,开放权重访问能够实现更深入的技术集成。团队可以优化推理栈、测试适配方法,并围绕模型的优势构建工作流。Kimi K3 的 MoE 规模、100 万 token 上下文、MoonViT-V2 视觉能力和基础设施发布,为专业应用奠定了基础。
与开源的区别仍然至关重要。开放权重并不会自动提供训练数据、源代码流程或完整的复现方案。不过,对于需要模型访问、私有部署或更强性能与隐私控制的团队而言,它仍能降低实际门槛。
结论:模型与基础设施的联合发布
Kimi K3 Open Day 最适合被理解为跨越三个层面的协调发布:模型访问、技术披露和部署基础设施。拥有 2.8 万亿参数的 MoE 模型是此次公告的核心,但技术报告和基础设施工具对于理解其更广泛的意义同样至关重要。
官方规格相当可观:总参数量 2.8T、896 个专家且每个 token 激活 16 个、100 万 token 上下文窗口、KDA + AttnRes 按 3:1 比例、MoonViT-V2,以及据称扩展效率提升 2.5 倍。MoonEP、FlashKDA 和 AgentEnv 表明,Moonshot AI 同时也在解决高效运行大型开放权重模型所需的系统问题。
Kimi K3并未被描述为完全开源;它是开放权重模型。即便如此,通过发布权重、技术细节和配套基础设施,Moonshot AI 使 Kimi K3 成为大规模开放权重 AI 发展中的一个重要事件。
常见问题(FAQ)
问:什么是 Kimi K3?
答:Kimi K3 是 Moonshot AI 推出的一款拥有 2.8 万亿参数的开放权重专家混合 AI 模型,于 2026 年 7 月 27 日在 Kimi K3 Open Day 上宣布。
问:开放权重是什么意思?
答:开放权重意味着已训练的模型权重可在规定的许可条款下访问。它不同于开源;开源通常意味着可以更广泛地访问源代码、数据和复现流程。
问:与 Kimi K3 一同发布了哪些基础设施技术?
答:Moonshot AI 发布了MoonEP、FlashKDA和AgentEnv。MoonEP 支持 MoE 通信,FlashKDA 加速 KDA 注意力,AgentEnv 则为 AI 智能体提供沙箱系统。
问:Kimi K3 最重要的规格是什么?
答:Kimi K3 的总参数量为 2.8T,拥有 896 个专家且每个 token 激活 16 个专家,具备 100 万 token 上下文窗口,采用按 3:1 比例的 KDA + AttnRes、MoonViT-V2,以及 2.5 倍的扩展效率提升。


