什么是机器学习
如果你在问什么是机器学习,最简单的答案是:机器学习是一种让计算机从数据中学习模式,并利用这些模式进行预测、推荐或决策的方法。人们不必手动编写每一条规则,而是向系统提供示例,让系统从中学习。
NIST 术语表将机器学习定义为能够适应并从数据中学习以提高准确性的计算机系统。这听起来很技术化,但日常概念其实很熟悉:系统看到的有用示例越多,就越能识别模式。
用简单的话说,什么是机器学习
机器学习是人工智能的一个分支。IBM、Google Cloud、Microsoft Azure和AWS都以类似方式解释它:机器学习利用数据和算法来训练系统,使其能够在无需针对每种情况进行显式编程的情况下做出预测或发现模式。
想象一下教孩子识别狗。你不会列出所有可能的耳朵形状、尾巴长度和毛色。你会展示示例。随着时间推移,孩子会学会这种模式。机器学习的原理类似,只不过使用的是数据、数学和算法。
机器学习的工作原理
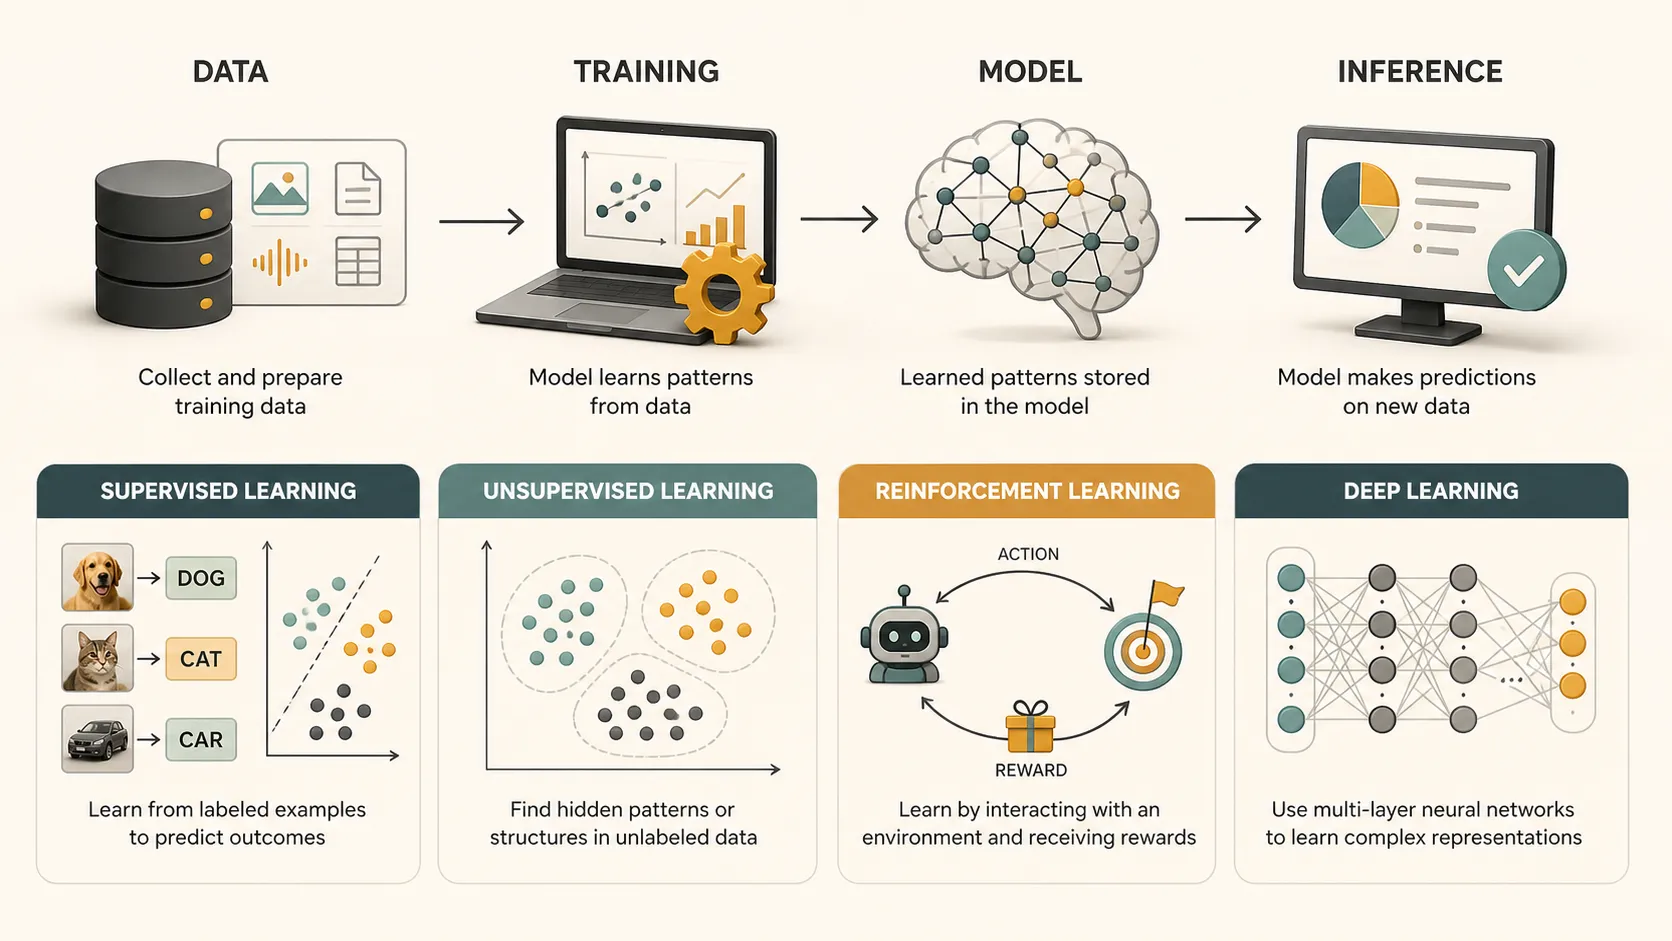
大多数机器学习项目都遵循一个基本流程:收集数据、准备数据、训练模型、测试模型,然后将模型用于新的输入。AWS 的构建机器学习应用程序指南将其描述为一个迭代过程:定义问题、准备数据、创建有用特征、训练模型、评估模型,并将其用于预测。
垃圾邮件过滤器是一个简单示例。系统从标记为“垃圾邮件”和“非垃圾邮件”的电子邮件中学习。在训练期间,它会注意到一些模式:可疑链接、重复短语、发件人行为或格式。在推理期间,它会将所学内容应用于新邮件,并预测它是否为垃圾邮件。
重要的词是“预测”。机器学习不像人一样理解世界。它寻找统计模式。这可能非常强大,但也意味着数据质量至关重要。
机器学习的常见类型
机器学习并非单一方法。它包括几种主要方法:
| 类型 | 这里的机器学习用于什么? | 示例 |
|---|---|---|
| 监督学习 | 从带标签的示例中学习 | 根据过去的销售记录预测房价 |
| 无监督学习 | 在没有标签的情况下发现模式 | 按行为对客户进行分组 |
| 强化学习 | 通过奖励和惩罚进行学习 | 训练游戏智能体 |
| 深度学习 | 使用分层神经网络 | 图像识别或语音转写 |
Stanford CS229通过监督学习、无监督学习、神经网络和强化学习等核心主题讲授机器学习。Google 的机器学习速成课程也很适合初学者,因为它通过实际示例解释这些概念。对于希望获得实践文档的人来说,scikit-learn 用户指南和TensorFlow 机器学习基础是很好的技术参考资料。
机器学习、AI 与深度学习的区别
人们经常混淆 AI、机器学习和深度学习。它们彼此相关,但并不相同。
人工智能是一个广泛领域:构建能够执行与人类智能相关任务的系统,例如推理、语言、感知、学习或决策。机器学习是构建 AI 系统的一种方式。深度学习是一种使用多层神经网络的机器学习类型。
因此,它们之间的关系很简单:AI 是大类别。机器学习属于 AI。深度学习属于机器学习。
计算器遵循固定规则,因此它不是机器学习。通过学习用户行为而不断改进的推荐系统是机器学习。使用深度神经网络的大型语言模型属于深度学习。
机器学习的实际示例
机器学习已成为日常生活的一部分。流媒体服务利用它推荐视频。银行利用它检测异常交易。电子邮件服务利用它过滤垃圾邮件。翻译工具利用它转换语言。搜索引擎利用它理解相关性和排序信号。
在医疗保健领域,FDA 维护了一份启用 AI 的医疗设备清单,其中许多设备在影像、诊断或临床支持中使用 AI 或机器学习技术。这提醒我们,机器学习可以很有用,但高风险系统需要测试和监督。
科学是另一个有力示例。AlphaFold利用 AI 预测蛋白质结构,帮助研究人员更高效地研究生物学。它表明机器学习不仅用于广告、应用程序和仪表板;它也可以支持科学发现。
数据质量为何重要
机器学习模型的好坏取决于其背后的数据和假设。如果训练数据不完整、有偏见、过时或标注不佳,模型就可能学到错误的模式。
例如,基于带有偏见的历史招聘数据训练的招聘模型,可能会重复这些模式。主要基于某一人群训练的医疗模型,对另一人群的表现可能较差。推荐模型可能变得过于狭窄,不断向用户展示更多相同的内容。
良好的机器学习工作包括数据清洗、测试、验证、监控和人工审查。它还意味着提出一些令人不适的问题:数据中代表了谁?缺少了谁?如果模型出错会怎样?
使用 Pi 直观地解释机器学习
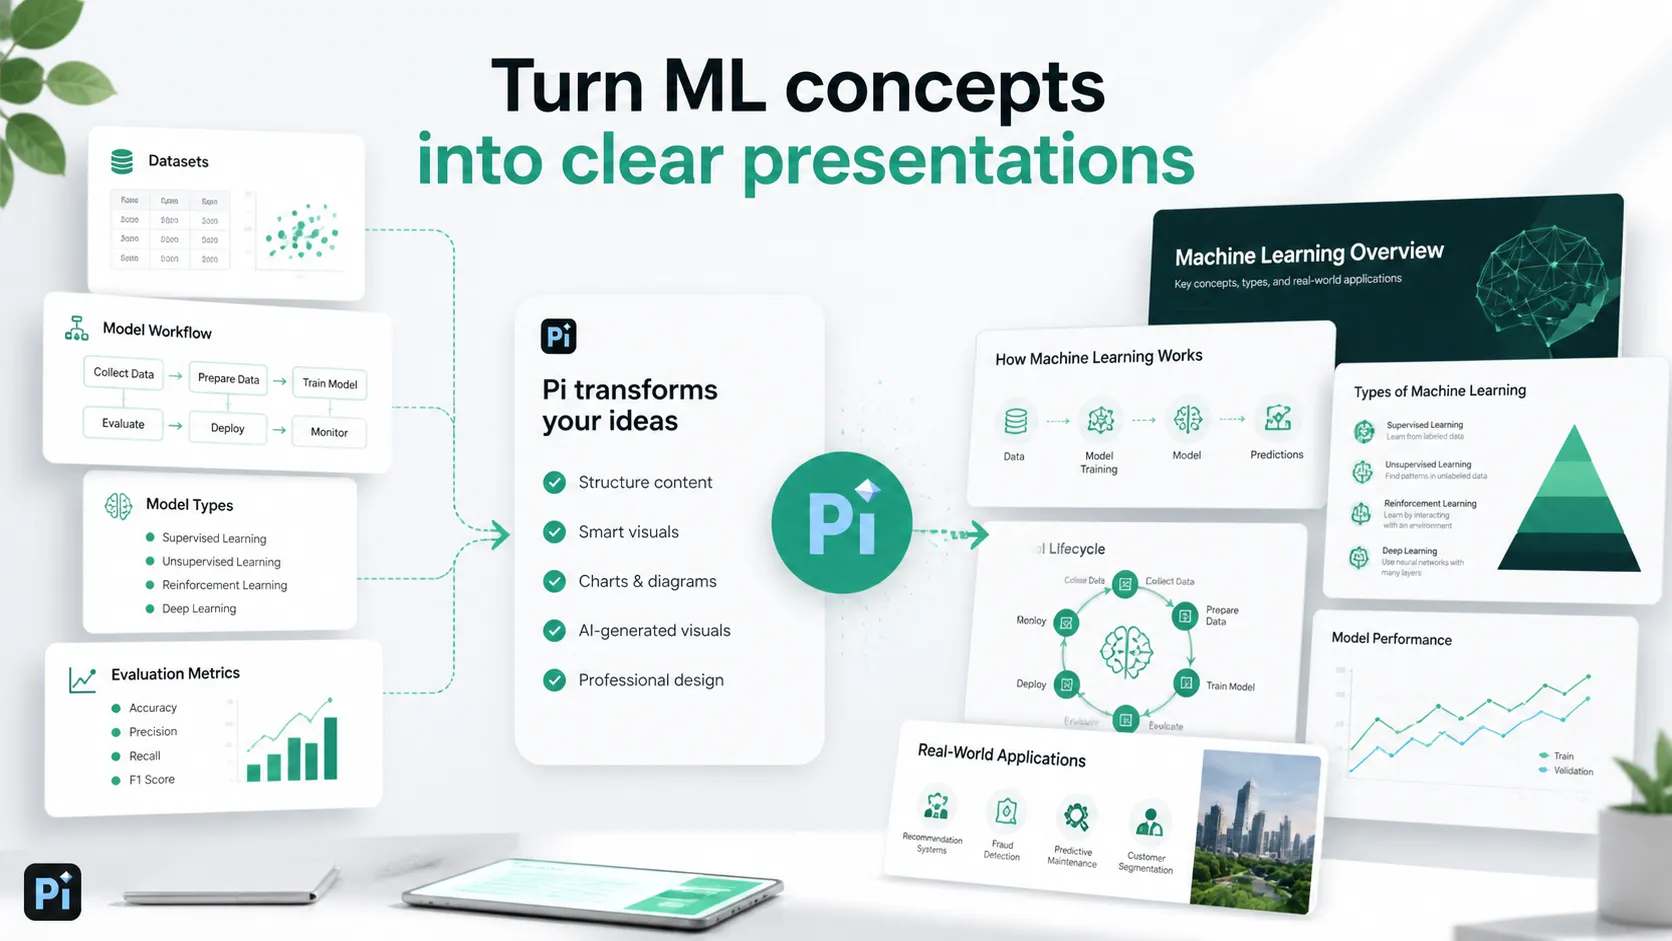
机器学习可能让人感到抽象,因为重要工作往往不可见:数据准备、模型训练、评估、部署和反馈循环。可视化解释有助于人们了解这一过程。
借助Pi,你可以将机器学习概念转化为演示文稿:从数据到模型的工作流程、监督学习与无监督学习的对比、展示模型准确率的图表,或基于图标的训练与推理说明。Pi 还可以自定义主题、颜色、布局、图标、图表和 AI 生成的视觉素材,让技术概念更容易向学生、客户、创始人或内部团队展示。
风险与负责任的使用
机器学习系统可能会犯错。它们可能放大偏见、泄露私人信息、造成不公平的结果,或变得难以解释。这就是负责任的 AI 很重要的原因。
NIST AI 风险管理框架为组织提供了一种思考可信 AI 风险的方法。OECD AI 原则强调以人为本的价值观、公平性、透明度、稳健性、安全性和问责制。
对于初学者来说,结论很简单:机器学习不应只按准确率来评判,还应按公平性、安全性、隐私性、可解释性和现实影响来评判。
结论
机器学习是教导计算机从数据中学习模式,并将这些模式应用于新情境的实践。它是现代 AI 背后的主要引擎之一,应用范围从推荐和欺诈检测到医疗工具和科学研究。
概念很简单,但实践需要谨慎。好的机器学习需要高质量数据、明确目标、测试、监控和负责任的使用。最好的模型不只是聪明;它们还应当有用、可靠,并适合受其影响的人群。
常见问题(FAQ)
问:什么是机器学习?
答:机器学习是 AI 的一个分支,计算机从数据中学习模式,并利用这些模式进行预测、推荐或决策。
问:机器学习和人工智能相同吗?
答:不相同。AI 是更广泛的领域。机器学习是用于构建 AI 系统的一种方法。深度学习是机器学习中的一个更小类别。
问:机器学习有哪些常见示例?
答:常见示例包括推荐系统、垃圾邮件过滤器、欺诈检测、语音识别、图像分类、翻译工具以及一些医疗 AI 系统。
问:学习机器学习需要编程吗?
答:无需编程也能理解基本概念,但构建真正的机器学习模型通常需要编程、统计学、数据处理和测试技能。


