白宫 AI 峰会:新安全框架解读
8月4日,白宫 AI 峰会将美国联邦政府对人工智能的方针重新置于全球政策辩论的中心。焦点不只是华盛顿希望加强监管,而是新的 AI 安全框架似乎旨在界定最强大的 AI 系统如何在满足更高的国家安全、透明度和公共问责要求的同时继续扩展规模。
对于 OpenAI、Meta、Google 和 Anthropic而言,信息很明确:前沿 AI 不再只是一场产品竞赛,正在成为一场治理竞赛。构建最强大模型的公司将越来越需要证明,这些模型在大规模部署之前是如何被测试、监控、记录和控制的。
8月4日白宫 AI 峰会发生了什么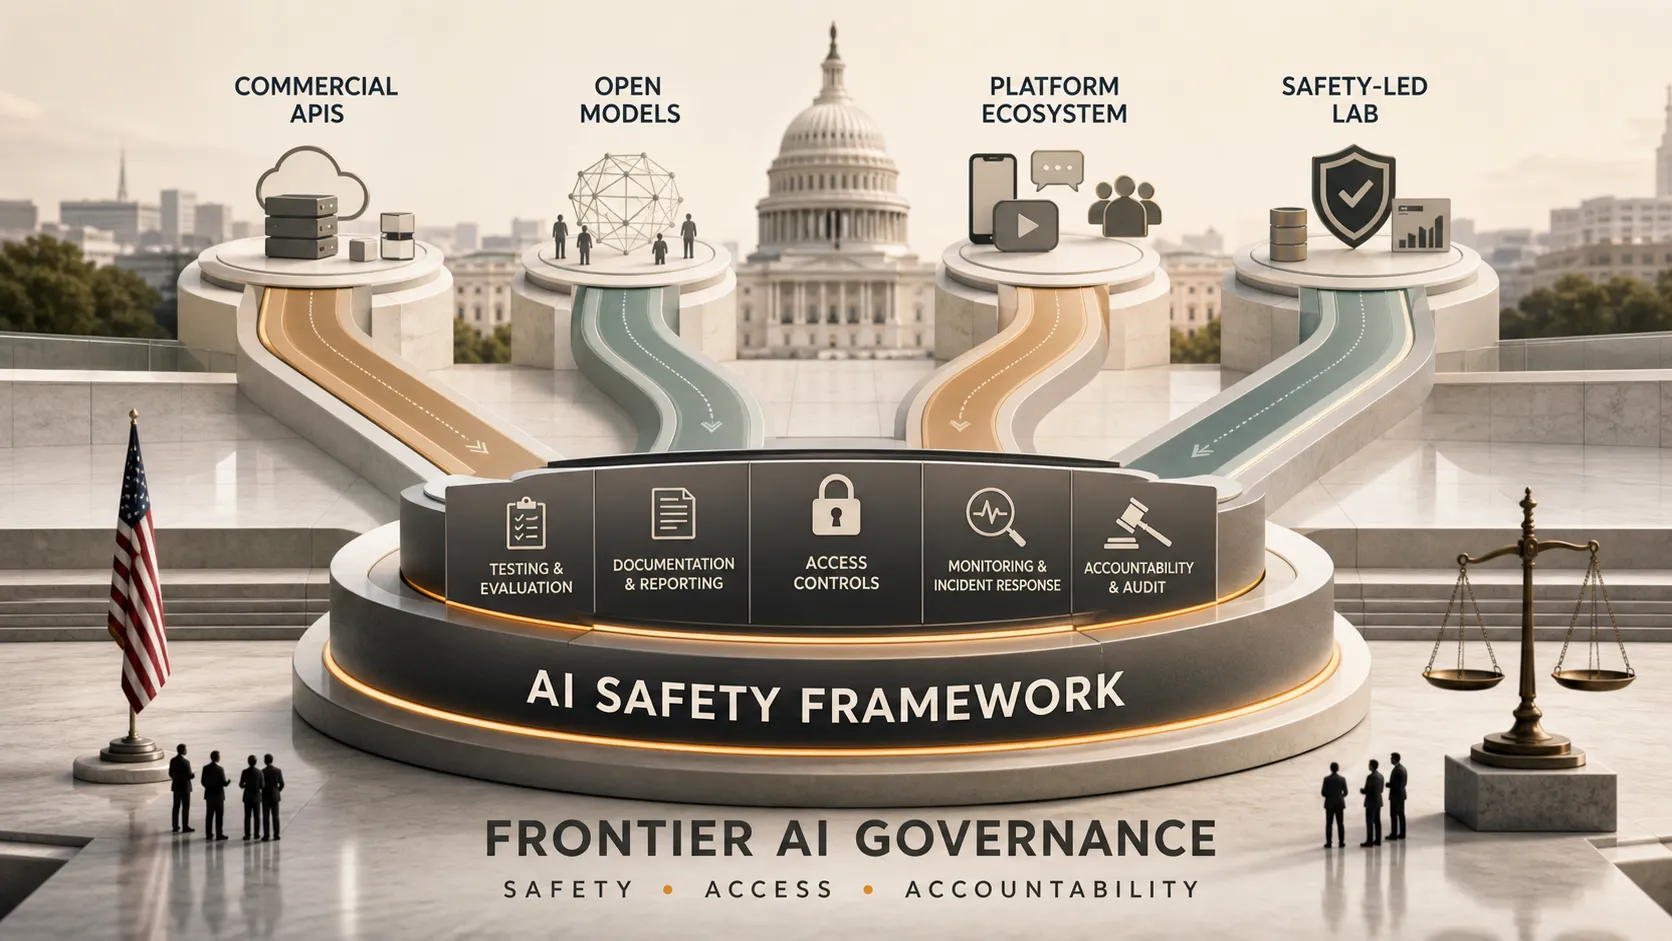
8月4日的 AI 峰会汇集了联邦政府围绕 AI 安全、行业责任和美国竞争优势的优先事项。白宫没有将 AI 监管视为一套单一规则,而是将安全定位为前沿模型开发的战略运营层。
AI 安全框架最好被理解为一种政策信号:随着模型能力增强并得到更广泛部署,领先的 AI 公司将被期望展现更强的安全保障。这并不意味着每项原则都会立即具有法律约束力。但这确实表明,自愿承诺、联邦指导方针、采购预期和监管标准正开始趋于一致。
这很重要,因为 AI 系统正从实验性工具进入关键的业务、政府和安全工作流程。政策问题不再是是否应对 AI 进行治理,而是如何在不损害创新或商业竞争力的前提下对其进行治理。
AI 安全框架试图解决什么问题
AI 安全框架旨在应对一个现实问题:最先进的模型能够创造巨大的经济价值,但它们也可能带来传统软件治理机制未被设计用来管理的风险。
核心关切包括不可预测的前沿模型能力、涉及网络行动或欺诈的滥用、模型训练透明度有限、高影响力工作流程中的问责薄弱,以及与先进 AI 全球竞争相关的国家安全风险。
该框架推动行业采用更高标准的证据。公司仅声称模型是安全的并不足够;它们必须展示如何评估安全性、识别出哪些风险、采取了哪些缓解措施,以及系统发布后将如何受到监控。
美国方针与《欧盟 AI 法案》有何不同
美国框架不应与《欧盟 AI 法案》混淆。欧盟模式明确以权利为基础,重点关注基本权利、风险类别以及不同 AI 使用场景中的合规义务。
相比之下,美国方针与国家安全、商业竞争力、前沿模型安全以及对大型科技公司的问责关系更为密切。华盛顿似乎并未构建广泛的、权利优先的监管架构,而是聚焦于强大 AI 公司能够继续构建、部署和出口先进系统的条件。
这对 OpenAI、Meta、Google 和 Anthropi意味着什么
新框架对各大 AI 公司的影响各不相同,因为它们的商业模式、分发渠道和安全理念并不相同。
| 公司 | 核心风险敞口 | 战略挑战 |
|---|---|---|
| OpenAI | 商业前沿模型和企业部署 | 在快速扩展产品之前证明安全性 |
| Meta | Llama 等开源和可下载模型 | 在公开发布后实施安全控制 |
| 覆盖搜索、云服务、Workspace、Android 和广告的 AI | 在庞大生态系统中协调治理 | |
| Anthropic | 以安全为导向的前沿模型开发 | 将安全定位转化为可验证的证据 |
OpenAI 可能面临与部署节奏最直接相关的压力。其商业模式依赖于将前沿能力转化为被广泛采用的产品、API 和企业工作流程。在 AI 安全框架下,更快的发布将需要更充分的文档、更具说服力的模型评估,以及更清晰的证据证明商业需求并未超过安全规范。
Meta 面临不同且可能更棘手的困境。其 Llama 战略使开放模型成为一项重要竞争优势。然而,偏向受控访问、可追溯部署和受监控风险缓解的联邦框架,与开源分发并不完全契合。一旦模型被第三方下载、微调和修改,Meta 对下游行为的控制就会减少。问题不在于开放模型能否安全,而在于去中心化之后,能否按照联邦预期证明其安全性。
Google 面临的挑战是规模。AI 已嵌入搜索、生产力软件、云基础设施、广告工具、移动系统和开发者产品之中。这种广度赋予 Google 巨大的战略力量,但也成倍增加了合规复杂性。某一产品领域的安全失误可能成为整个生态系统的声誉和监管问题。
Anthropic 在框架讨论中拥有更强的叙事优势,因为安全始终是其品牌的核心。但 Anthropic 同样将面临更高门槛。仅有安全优先的文化已不再足够。政策制定者将要求可重复的测试流程、可审计的文档,以及明确证据证明,随着模型能力提升,其治理实践依然有效。
为什么该框架改变了 AI 商业模式
AI 安全框架并非只是增加文书工作。它改变了公司必须如何看待速度、分发和信任。
在生成式 AI 竞争的前一阶段,市场奖励快速发布、模型基准测试、开发者采用和用户增长。在下一阶段,这些优势仍然重要,但将与基于证据的治理并行。前沿模型的发布可能越来越需要安全报告、红队测试结果、风险缓解措施、升级政策和部署后监控计划。
这为大型科技公司 AI 监管带来了新的运营现实。产品团队、政策团队、法务团队和安全团队需要在开发周期更早阶段协同工作。安全不再能被视为模型训练结束时的一项审查;它必须成为模型路线图本身的一部分。
业务团队接下来应关注什么
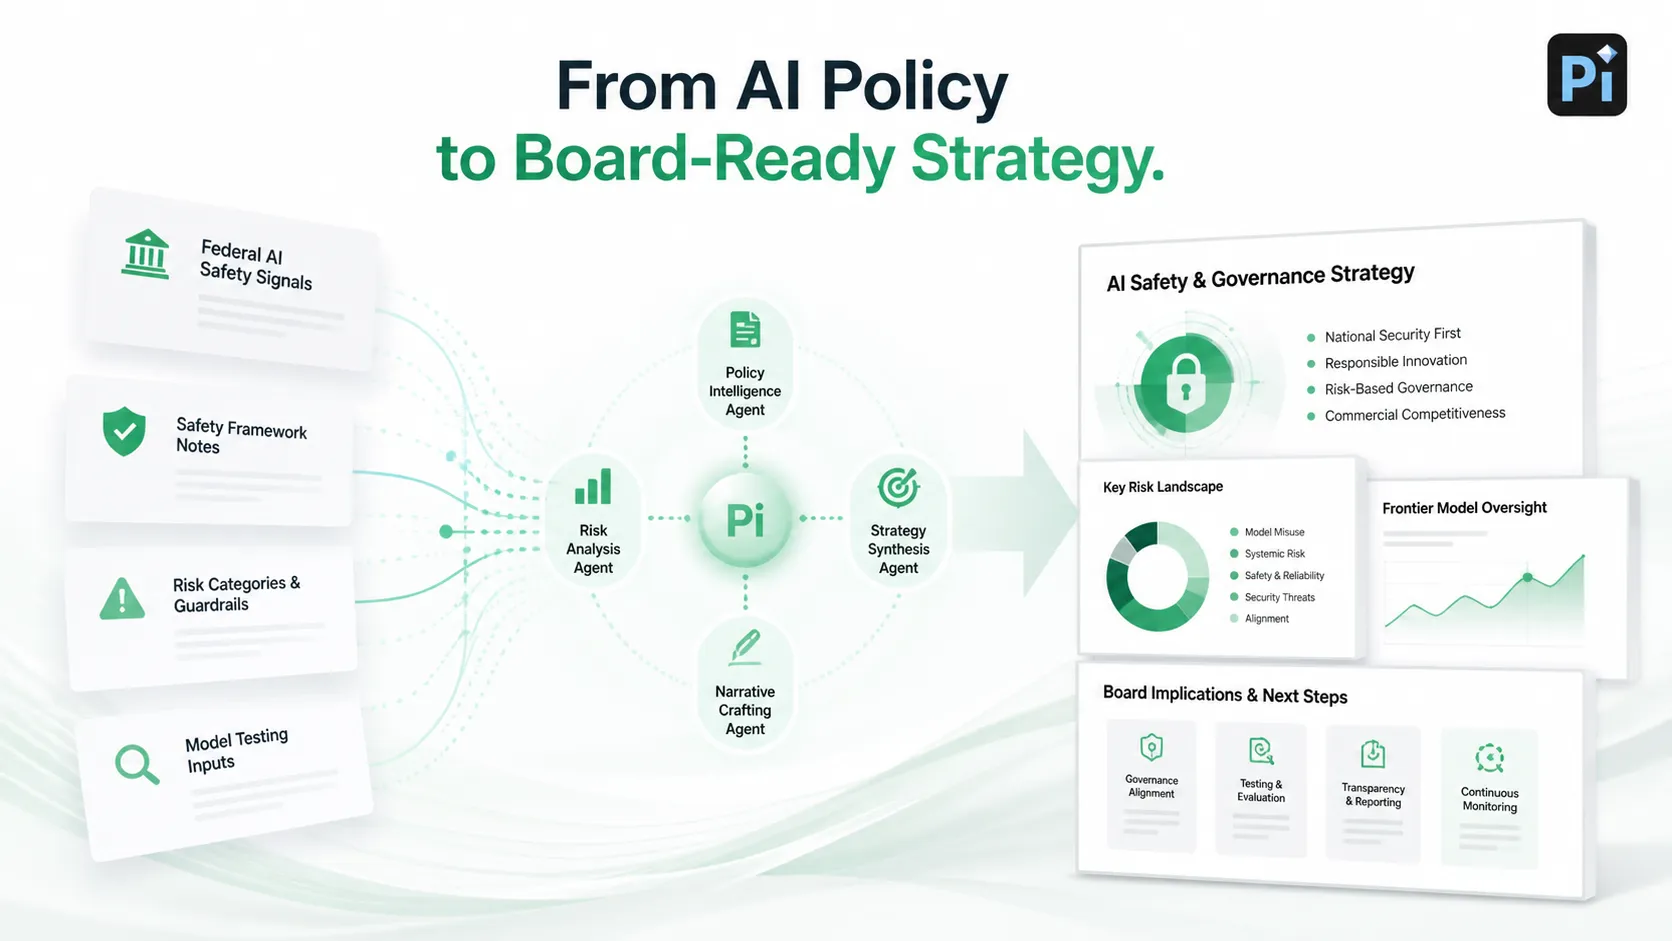
白宫 AI 峰会不仅与 AI 实验室有关。它也会影响购买、整合 AI,或向董事会、客户、投资者和监管机构展示 AI 战略的企业。当联邦预期发生变化时,公司阐释 AI 采用方式也必须随之改变。
业务团队需要围绕三个问题建立更清晰的内部叙事:他们使用哪些 AI 系统、这些系统带来哪些风险,以及治理如何处理。这对于高管演示、咨询报告、投资者更新和产品发布材料尤其重要;在这些场景中,必须解释 AI 能力,同时避免夸大确定性。
对于应对这些高风险讨论的组织而言,能够将监管复杂性与结构化专业沟通相衔接的实用工具正变得愈发关键。无论是将政策变化转化为适合董事会的叙事,还是综合竞争影响,Pi 等平台正成为战略团队的宝贵资产,帮助它们从被动报告转向主动的高管叙事。
结论:AI 安全正成为竞争要求
白宫 AI 峰会及其配套的 AI 安全框架标志着 AI 行业一个明确的转折点。它们表明联邦监管已不再是假设。对于主要 AI 实验室而言,安全已从内部工程优先事项转变为核心合规和治理要求。
该框架不会阻止 AI 发展,但会重塑模型的构建、测试、记录和发布方式。归根结底,在这一新环境中蓬勃发展的公司,不会只是拥有最强模型的公司,而是拥有最可信安全叙事的公司。
这场辩论的下一阶段将聚焦于如何验证这些主张。这就是为什么 通过 NIST 标准进行前沿模型测试i正成为连接政策意图与现实世界 AI 部署的关键桥梁。
常见问题(FAQ)
问:白宫 AI 峰会宣布了什么?
答:白宫 AI 峰会重点介绍了一项新的 AI 安全框架,聚焦于前沿模型安全、国家安全、透明度以及对领先 AI 公司的问责。
问:什么是 AI 安全框架?
答:AI 安全框架是一种美国政策方针,旨在改善对强大 AI 系统的治理,尤其是通过安全测试、防止滥用、文档记录和负责任部署。
问:该框架如何影响 OpenAI、Meta、Google 和 Anthropic?
答:OpenAI 面临在快速部署前证明安全性的压力;Meta 必须应对开源控制方面的挑战;Google 需要实现覆盖整个生态系统的治理;Anthropic 则必须将其安全定位转化为可验证的证据。
问:什么是前沿模型测试?
答:前沿模型测试是指在部署前后,通过能力评估、滥用测试、稳健性检查、对齐评估和持续风险监控,对先进 AI 系统进行评估的过程。


