Über LLMs hinaus: Was TypeSafe Jev für System-One-KI bedeutet
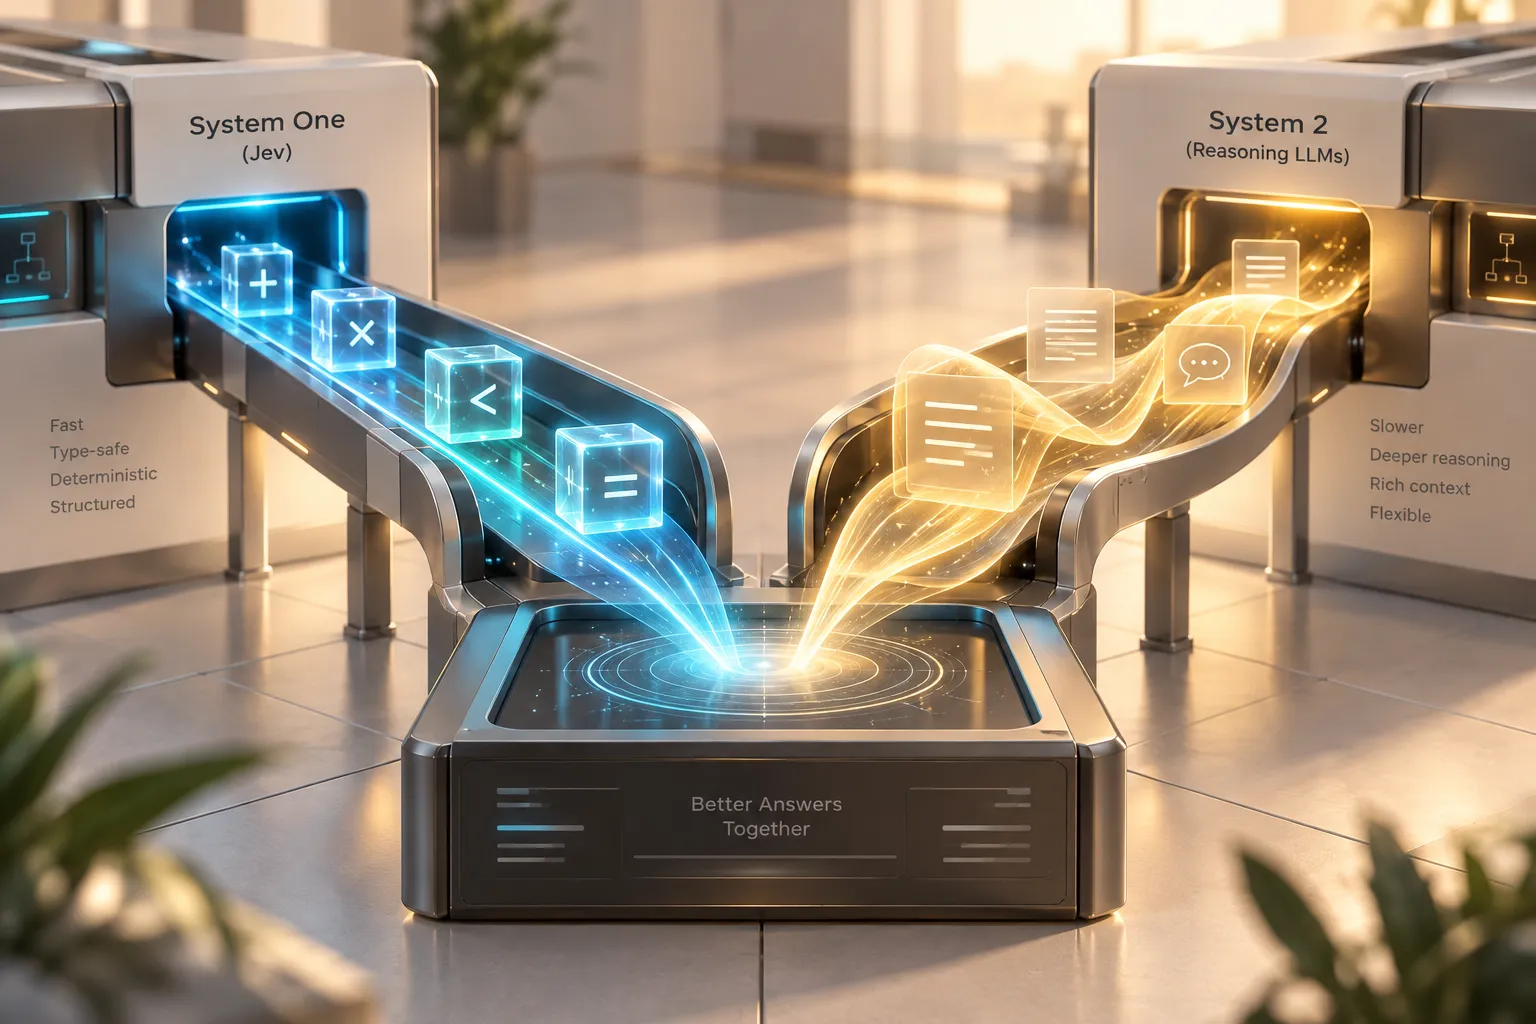
In der Verhaltensökonomie machte der Nobelpreisträger Daniel Kahneman die Welt mit System 1 (schnelle, instinktive, parallele Entscheidungen) und System 2 (langsames, bewusstes, analytisches Denken) vertraut.
Seit Jahren ist der Boom der generativen KI darauf fixiert, massive System-2-Engines zu entwickeln: riesige Reasoning-LLMs wie Claude 3.5, GPT-4 und Gemini 1.5, die Aufsätze schreiben, Code erstellen und komplexe mehrstufige Probleme lösen.
Die Softwareentwicklung steht jedoch vor einem stillen Engpass: Die meisten Vorgänge in modernen Apps erfordern weder komplexes Denken noch natürlichsprachlichen Fließtext. Sie erfordern ultraschnelle, strukturierte Entscheidungen – etwa das Weiterleiten eines Tickets, das Zuweisen eines Konfidenzwerts oder das Erkennen von Spam. Für diese Aufgaben ein riesiges Chat-LLM einzusetzen, ist wie einen Philosophen damit zu beauftragen, einen Lichtschalter umzulegen: langsam, teuer und anfällig dafür, JSON-Parser zu beeinträchtigen.
Hier kommt Jev ins Spiel, das Flaggschiff-System-One-Modell von TypeSafe AI.
Wenn Sie Software mit KI entwickeln, finden Sie hier eine vollständige Übersicht darüber, was System-One-Modelle sind, wie Jev funktioniert und warum dieser Wandel die Integration von KI in Ihren Produktions-Stack grundlegend neu gestalten könnte.
Was ist ein System-One-Modell?
Ein System-One-Modell ist ein KI-Modell, das speziell für schnelle, begrenzte und typisierte Entscheidungsfindung statt für offene Textgenerierung entwickelt wurde.
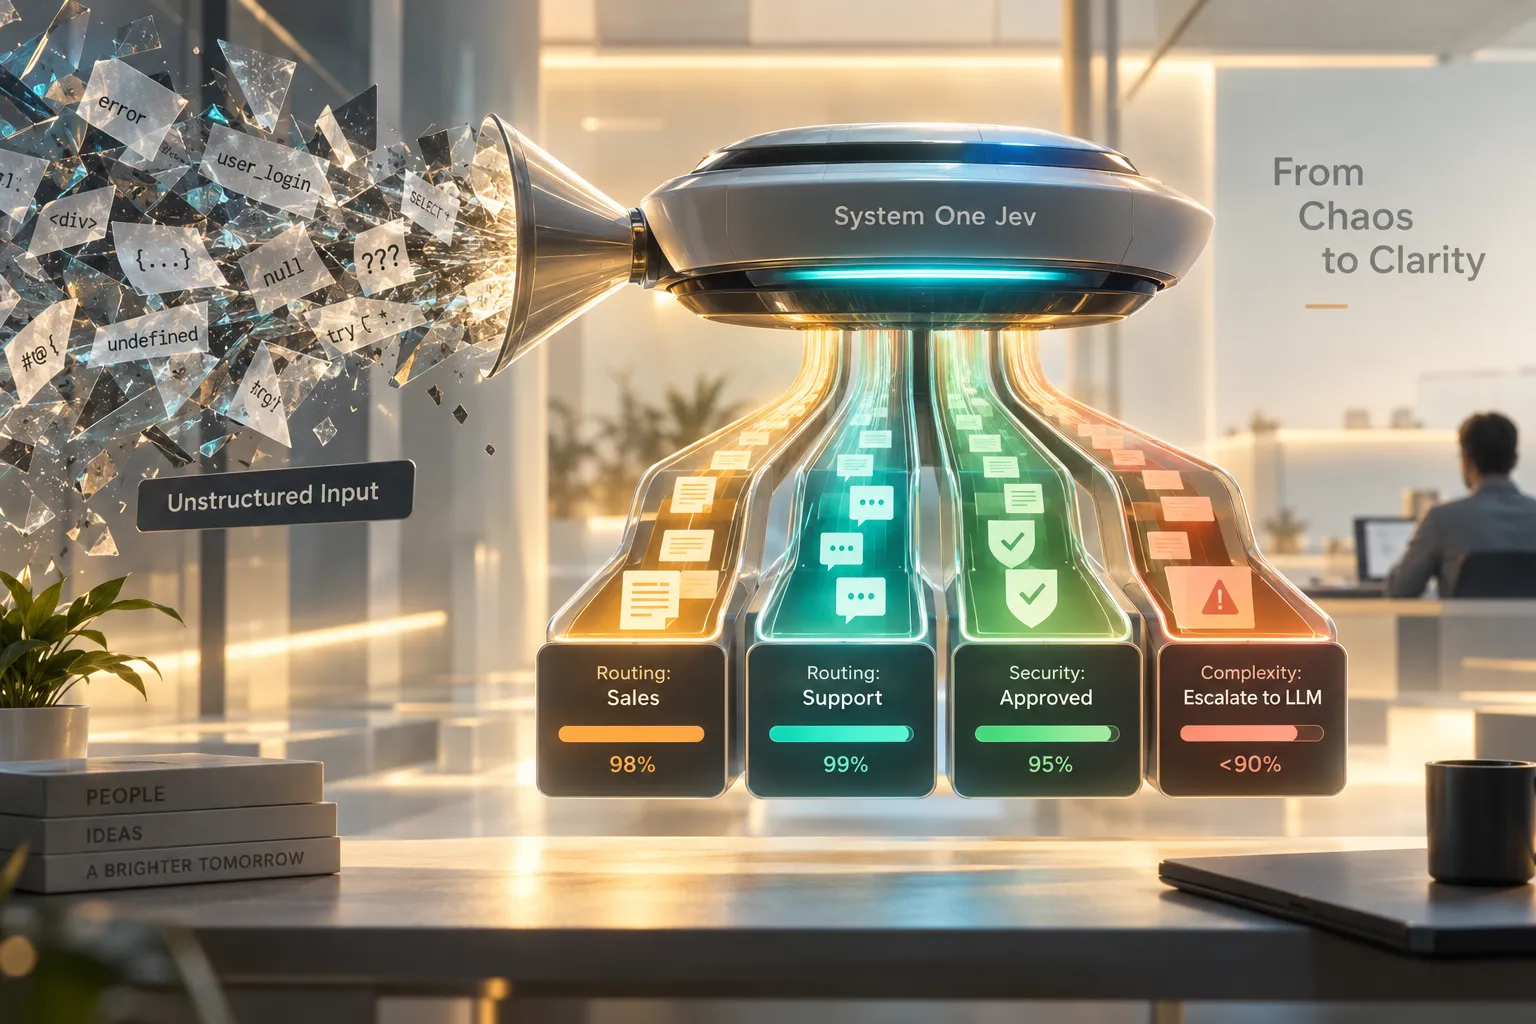
Anstatt rohen Text Token für Token zu generieren, akzeptiert ein System-One-Modell unstrukturierten Programmzustand (z. B. Textprotokolle, Benutzereingaben oder JSON-Objekte) und bewertet definierte Auswahlmöglichkeiten in einem einzigen parallelen Durchlauf.
[Unstrukturierte Eingabe / Zustand] ---> [ System-One-Modell (Jev) ] ---> [ Typsichere Entscheidung + Wahrscheinlichkeit ]
Anstatt Fließtext auszugeben, liefert es typsichere Primitive wie:
- Auswahl: Kategoriale Auswahl aus einer definierten Menge von Optionen (bis zu 255 Optionen).
- Bewertung: Numerische Bewertungen anhand definierter Metriken.
- Boolesch (Noul): Kalibrierte Ja/Nein-Wahrscheinlichkeiten.
Was unterscheidet TypeSafe Jev von Standard-LLMs?
Um zu verstehen, warum die Akzeptanz von Jev unter Entwicklern stark zugenommen hat, betrachten Sie den Vergleich mit Standard-Frontier-LLMs wie GPT-4o oder Claude:
| Merkmal | Standard-Chat-/Reasoning-LLMs | System-One-Modelle (Jev) |
| Ausgabetyp | Unstrukturierte Zeichenketten (Fließtext, JSON-Text) | Streng typisierte Werte (Auswahl, Bewertung, Boolesch) |
| Sampling-Mechanismus | Autoregressiv (Token für Token) | Einziger paralleler Durchlauf |
| Latenz | 1 bis 10+ Sekunden | 70 ms – 500 ms |
| Konfidenzbewertung | Häufig übermäßig selbstsicher oder unkalibriert | Kalibrierte Wahrscheinlichkeiten pro Ausgabe |
| Typfehler / Schema-Brüche | Risiko fehlerhafter Ausgaben/fehlgeschlagener JSON-Analyse | 0 % Typfehlerrate (konstruktionsbedingt) |
| Primärer Anwendungsfall | Inhaltserstellung, Chatten, Agenten-Reasoning | Ticket-Routing, Spam-Erkennung, Agenten-Gating |
Wesentliche Vorteile der Jev-System-One-Architektur
1. Keine Halluzinationen und Typfehler
Da System-One-Modelle keine frei formulierten Sätze generieren, vermeiden sie Formatierungsfehler. Softwareanwendungen benötigen keine komplexe Wiederholungslogik oder defensive JSON-Analyse – die Ausgabe folgt strikt dem im Code deklarierten Schema.
2. Integrierte kalibrierte Konfidenz
Herkömmliche LLMs sind dafür bekannt, selbstbewusst falsche Antworten zu geben. Jev wird mit Techniken wie Reinforcement Learning for Calibrated Decisions (RLCD) trainiert und liefert neben jeder Entscheidung eine mathematische Wahrscheinlichkeit.
Dadurch können Entwickler klare Logik-Gates erstellen:
- Konfidenz > 95 %: Automatisch ausführen.
- Konfidenz < 80 %: Zur menschlichen Prüfung weiterleiten oder an ein leistungsstärkeres System-2-Modell (wie Claude oder GPT-4) eskalieren.
3. Latenz- und Kosteneffizienz
Durch den Wegfall des Overheads der autoregressiven Textgenerierung laufen System-One-Modelle bis zu 40- bis 100-mal schneller als herkömmliche Chat-LLMs. Die Kosten für Eingabe-Tokens sinken drastisch, während der übliche Overhead der Ausgabeerzeugung vollständig entfällt.
Praxisnahe Anwendungsfälle: Wo System One in Ihre Architektur passt
Jev und System-One-Modelle sollen LLMs wie ChatGPT oder Claude nicht ersetzen – sie sind dafür konzipiert, vor oder neben ihnen als schnelle, deterministische Entscheidungsebene zu arbeiten.
                     ┌────────────────────────┐
                     │ Eingehende Benutzeranfrage │
                     └───────────┬────────────┘
                                 │
                                 ▼
                     ┌────────────────────────┐
                     │  System One (Jev API)  │
                     └───────────┬────────────┘
                                 │
          ┌──────────────────────┴──────────────────────┐
          │ Hohe Konfidenz (>90 %)                      │ Niedrige Konfidenz (<90 %)
          ▼                                             ▼
┌──────────────────┐                           ┌──────────────────┐
│ Automatisierte   │                           │ System 2 (LLM)   │
│ Weiterleitung oder│                          │ / Eskalation an  │
│ Tool-Ausführung  │                           │ Menschen         │
└──────────────────┘                           └──────────────────┘
Wichtige Anwendungen:
- Support-Ticket- & Lead-Routing: Eingehende Tickets sofort kategorisieren (z. B. {billing, technical, sales}) und die Dringlichkeit bewerten, ohne unübersichtliche Textantworten analysieren zu müssen.
- Autorisierung von KI-Agenten-Tools: Entscheiden, ob ein Tool-Aufruf anhand von Sicherheitsregeln automatisch genehmigt werden soll, wodurch Verzögerungen in autonomen Schleifen entfallen.
- Kaskadierende RAG-Pipelines: Bewerten, ob der abgerufene Kontext von Vektordokumenten relevant ist, bevor er an ein kostspieliges generatives Modell gesendet wird.
- Moderation & Schutzmechanismen: Eingehende Benutzeranfragen oder Modellausgaben in weniger als 100 ms auf Richtlinienverstöße prüfen.
Einschränkungen: Was Jev NICHT kann
Um effektiv mit System-One-Modellen zu arbeiten, ist es entscheidend, ihre Grenzen zu verstehen:
- Keine Freitextgenerierung: Jev kann keine E-Mails entwerfen, Code schreiben, lange Dokumente in Fließtext zusammenfassen oder chatten.
- Kein internes Weltwissen: Jev stützt sich vollständig auf den ihm übergebenen Zustand; es kann nicht im Web suchen oder eigenständig komplexe interne Wissensabfragen durchführen.
- Erfordert vordefiniertes Schema: Sie müssen die exakt begrenzte Menge an Auswahlmöglichkeiten oder Bewertungskriterien kennen, bevor Sie den API-Aufruf durchführen.
Das Fazit: Die Dual-Modell-Architektur ist da
Die Einführung von Jev durch TypeSafe markiert einen wichtigen Wandel im KI-Engineering. Die Ära, in der für jeden Schritt einer Anwendung ein einziges riesiges, teures LLM verwendet wird, geht zu Ende.
Stattdessen entwickeln sich produktionsreife Anwendungen hin zu einer Hybridarchitektur:
- System One (Jev): Übernimmt schnelle Klassifizierung mit hohem Volumen, Tool-Auswahl, Routing und Filterung bei geringer Latenz.
- System 2 (GPT/Claude/Gemini): Übernimmt Langformgenerierung, komplexes Denken und offene Analysen.
Indem sie Mikroentscheidungen an System-One-Modelle delegieren, können Entwickler KI-Systeme entwickeln, die schneller, drastisch günstiger und mathematisch zuverlässig sind.
Während sich Backend-Architekturen hin zu Modellen mit geringer Latenz wie Jev entwickeln, um Datenflüsse zu optimieren, sollte auch die Frontend-Präsentation und Berichterstellung kein Engpass sein. Erfahren Sie, wie Presentation Intelligence (PI) Teams dabei unterstützt, wirkungsvolle Pitch-Decks und Berichte sofort zu erstellen, zu strukturieren und zu automatisieren.


