Was ist maschinelles Lernen
Wenn Sie fragen, was maschinelles Lernen ist, lautet die einfachste Antwort: Maschinelles Lernen ist eine Methode, mit der Computer Muster aus Daten lernen und diese Muster nutzen, um Vorhersagen, Empfehlungen oder Entscheidungen zu treffen. Statt jede Regel von Hand zu schreiben, geben Menschen dem System Beispiele, und das System lernt daraus.
Das Glossar des NIST definiert maschinelles Lernen als Computersysteme, die sich anpassen und aus Daten lernen, um ihre Genauigkeit zu verbessern. Das klingt technisch, aber die alltägliche Idee ist vertraut: Je mehr nützliche Beispiele das System sieht, desto besser kann es Muster erkennen.
was ist maschinelles Lernen einfach erklärt
Maschinelles Lernen ist ein Teilbereich der künstlichen Intelligenz. IBM, Google Cloud, Microsoft Azure und AWS erklären es alle auf ähnliche Weise: Maschinelles Lernen nutzt Daten und Algorithmen, um Systeme zu trainieren, die Vorhersagen treffen oder Muster finden können, ohne für jeden Fall ausdrücklich programmiert zu werden.
Stellen Sie sich vor, Sie bringen einem Kind bei, Hunde zu erkennen. Sie zählen nicht jede mögliche Ohrenform, Schwanzlänge und Fellfarbe auf. Sie zeigen Beispiele. Mit der Zeit lernt das Kind das Muster. Maschinelles Lernen funktioniert in einem ähnlichen Sinne, aber mit Daten, Mathematik und Algorithmen.
Wie maschinelles Lernen funktioniert
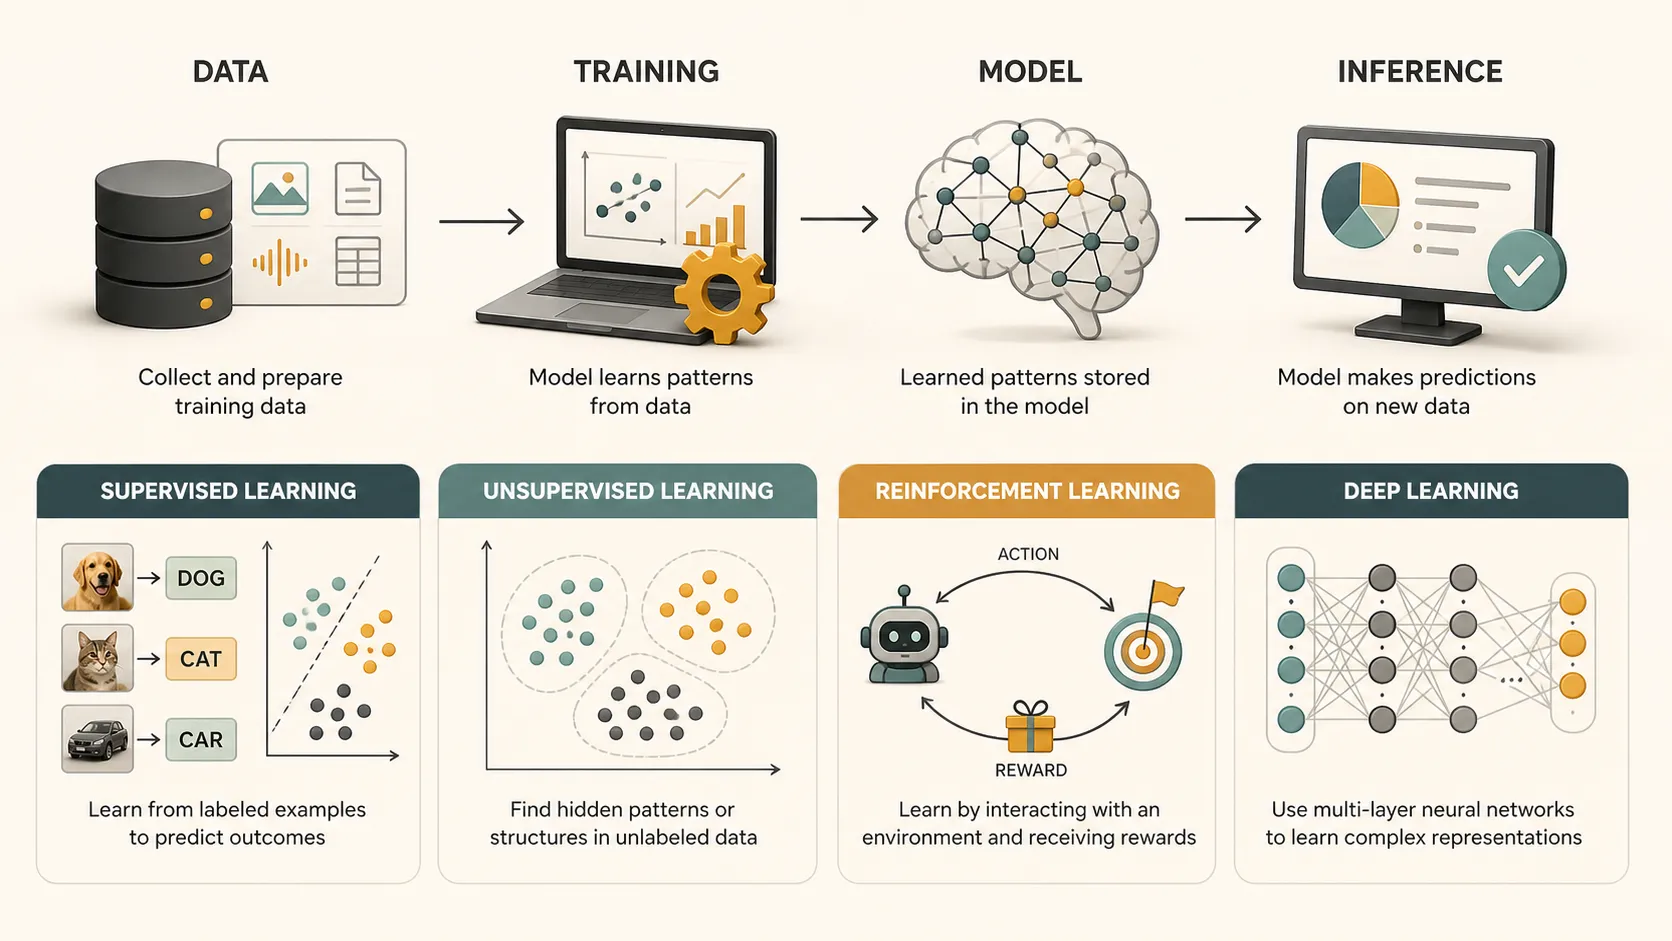
Die meisten Projekte des maschinellen Lernens folgen einem grundlegenden Ablauf: Daten sammeln, sie aufbereiten, ein Modell trainieren, es testen und das Modell dann auf neue Eingaben anwenden. Der AWS-Leitfaden zum Erstellen einer Anwendung für maschinelles Lernen beschreibt dies als iterativen Prozess: das Problem definieren, die Daten vorbereiten, nützliche Merkmale erstellen, das Modell trainieren, es bewerten und es für Vorhersagen einsetzen.
Ein Spamfilter ist ein einfaches Beispiel. Das System lernt aus E-Mails, die als „Spam“ und „kein Spam“ gekennzeichnet sind. Während des Trainings erkennt es Muster: verdächtige Links, wiederholte Formulierungen, das Verhalten des Absenders oder die Formatierung. Bei der Inferenz wendet es das Gelernte auf eine neue E-Mail an und sagt voraus, ob sie Spam ist.
Das wichtige Wort ist „sagt voraus“. Maschinelles Lernen versteht die Welt nicht wie ein Mensch. Es findet statistische Muster. Das kann leistungsfähig sein, bedeutet aber auch, dass die Qualität der Daten enorm wichtig ist.
Gängige Arten des maschinellen Lernens
Maschinelles Lernen ist nicht nur eine einzige Methode. Es umfasst mehrere wichtige Ansätze:
| Typ | wofür wird maschinelles Lernen hier eingesetzt? | Beispiel |
|---|---|---|
| Überwachtes Lernen | Lernen aus gelabelten Beispielen | Vorhersage von Hauspreisen anhand vergangener Verkäufe |
| Unüberwachtes Lernen | Muster ohne Labels finden | Kunden nach Verhalten gruppieren |
| Bestärkendes Lernen | Lernen durch Belohnungen und Strafen | Training eines Agenten zum Spielen von Spielen |
| Deep Learning | Verwendung mehrschichtiger neuronaler Netzwerke | Bilderkennung oder Sprachtranskription |
Stanford CS229 vermittelt maschinelles Lernen anhand zentraler Themen wie überwachtem Lernen, unüberwachtem Lernen, neuronalen Netzwerken und bestärkendem Lernen. Der Machine Learning Crash Course von Google ist ebenfalls für Einsteiger nützlich, da er die Konzepte mit praktischen Beispielen erklärt. Für Menschen, die praxisnahe Dokumentation wünschen, sind der scikit-learn User Guide und die Grundlagen des maschinellen Lernens mit TensorFlow gute technische Referenzen.
Maschinelles Lernen vs. KI vs. Deep Learning
Menschen verwechseln oft KI, maschinelles Lernen und Deep Learning. Sie sind miteinander verwandt, aber nicht identisch.
Künstliche Intelligenz ist das breite Feld: Systeme zu entwickeln, die Aufgaben ausführen können, die mit menschlicher Intelligenz verbunden sind, etwa Schlussfolgern, Sprache, Wahrnehmung, Lernen oder Entscheidungsfindung. Maschinelles Lernen ist eine Möglichkeit, KI-Systeme zu entwickeln. Deep Learning ist eine Art des maschinellen Lernens, die neuronale Netzwerke mit vielen Schichten verwendet.
Die Beziehung ist also einfach: KI ist die große Kategorie. Maschinelles Lernen ist ein Teil von KI. Deep Learning ist ein Teil des maschinellen Lernens.
Ein Taschenrechner folgt festen Regeln und ist daher kein maschinelles Lernen. Ein Empfehlungssystem, das sich durch das Lernen aus dem Nutzerverhalten verbessert, ist maschinelles Lernen. Ein großes Sprachmodell, das tiefe neuronale Netzwerke nutzt, ist Deep Learning.
Praxisbeispiele für maschinelles Lernen
Maschinelles Lernen ist bereits Teil des Alltags. Streamingdienste nutzen es, um Videos zu empfehlen. Banken nutzen es, um ungewöhnliche Transaktionen zu erkennen. E-Mail-Dienste nutzen es, um Spam zu filtern. Übersetzungstools nutzen es, um Sprache zu übersetzen. Suchmaschinen nutzen es, um Relevanz- und Ranking-Signale zu verstehen.
Im Gesundheitswesen führt die FDA eine Liste von KI-gestützten Medizinprodukten, von denen viele KI- oder maschinelle Lernverfahren für Bildgebung, Diagnostik oder klinische Unterstützung einsetzen. Das erinnert daran, dass maschinelles Lernen nützlich sein kann, Systeme mit hohen Risiken jedoch Tests und Aufsicht benötigen.
Die Wissenschaft ist ein weiteres starkes Beispiel. AlphaFold nutzt KI, um Proteinstrukturen vorherzusagen, und hilft Forschenden dadurch, die Biologie effizienter zu untersuchen. Es zeigt, dass maschinelles Lernen nicht nur für Werbung, Apps und Dashboards gedacht ist; es kann auch wissenschaftliche Entdeckungen unterstützen.
Warum Datenqualität wichtig ist
Ein Modell für maschinelles Lernen ist nur so gut wie die Daten und Annahmen, auf denen es basiert. Wenn die Trainingsdaten unvollständig, verzerrt, veraltet oder schlecht gelabelt sind, kann das Modell falsche Muster lernen.
Ein Einstellungsmodell, das mit verzerrten Daten aus früheren Einstellungen trainiert wurde, kann diese Muster beispielsweise wiederholen. Ein medizinisches Modell, das hauptsächlich mit Daten einer Bevölkerungsgruppe trainiert wurde, kann bei einer anderen schlechter abschneiden. Ein Empfehlungsmodell kann zu eng werden und Nutzern immer mehr vom Gleichen zeigen.
Gute Arbeit im maschinellen Lernen umfasst Datenbereinigung, Tests, Validierung, Überwachung und menschliche Prüfung. Sie bedeutet auch, unbequeme Fragen zu stellen: Wer ist in den Daten vertreten? Wer fehlt? Was passiert, wenn das Modell falsch liegt?
Maschinelles Lernen mit Pi visuell erklären
Maschinelles Lernen kann abstrakt wirken, weil die wichtige Arbeit oft unsichtbar ist: Datenaufbereitung, Modelltraining, Bewertung, Bereitstellung und Feedbackschleifen. Visuelle Erklärungen helfen Menschen, den Prozess zu verstehen.
Mit Pi können Sie Konzepte des maschinellen Lernens in eine Präsentation umwandeln: einen Daten-zu-Modell-Workflow, einen Vergleich von überwachtem und unüberwachtem Lernen, ein Diagramm zur Modellgenauigkeit oder eine symbolbasierte Erklärung von Training und Inferenz. Pi kann außerdem Designs, Farben, Layouts, Symbole, Diagramme und KI-generierte Visualisierungen anpassen, wodurch sich technische Ideen Studierenden, Kunden, Gründern oder internen Teams leichter vermitteln lassen.
Risiken und verantwortungsvoller Einsatz
Systeme des maschinellen Lernens können Fehler machen. Sie können Verzerrungen verstärken, private Informationen preisgeben, ungerechte Ergebnisse erzeugen oder schwer zu erklären sein. Deshalb ist verantwortungsvolle KI wichtig.
Das NIST AI Risk Management Framework bietet Organisationen eine Möglichkeit, über Risiken vertrauenswürdiger KI nachzudenken. Die OECD-KI-Prinzipien betonen menschenzentrierte Werte, Fairness, Transparenz, Robustheit, Sicherheit und Rechenschaftspflicht.
Für Einsteiger ist die Erkenntnis einfach: Maschinelles Lernen sollte nicht nur nach Genauigkeit beurteilt werden. Es sollte auch nach Fairness, Sicherheit, Datenschutz, Erklärbarkeit und Auswirkungen in der realen Welt bewertet werden.
Das Fazit
Maschinelles Lernen ist die Praxis, Computern beizubringen, Muster aus Daten zu lernen und diese Muster auf neue Situationen anzuwenden. Es ist einer der wichtigsten Motoren moderner KI – von Empfehlungen und Betrugserkennung bis hin zu medizinischen Werkzeugen und wissenschaftlicher Forschung.
Das Konzept ist einfach, doch die praktische Umsetzung erfordert Sorgfalt. Gutes maschinelles Lernen braucht gute Daten, klare Ziele, Tests, Überwachung und verantwortungsvollen Einsatz. Die besten Modelle sind nicht nur clever. Sie sind nützlich, zuverlässig und für die von ihnen betroffenen Menschen angemessen.
Häufig gestellte Fragen (FAQ)
F: Was ist maschinelles Lernen?
A: Maschinelles Lernen ist ein Teilbereich der KI, bei dem Computer Muster aus Daten lernen und diese Muster nutzen, um Vorhersagen, Empfehlungen oder Entscheidungen zu treffen.
F: Ist maschinelles Lernen dasselbe wie künstliche Intelligenz?
A: Nein. KI ist das breitere Feld. Maschinelles Lernen ist eine Methode, mit der KI-Systeme entwickelt werden. Deep Learning ist eine kleinere Kategorie innerhalb des maschinellen Lernens.
F: Was sind gängige Beispiele für maschinelles Lernen?
A: Gängige Beispiele sind Empfehlungssysteme, Spamfilter, Betrugserkennung, Spracherkennung, Bildklassifizierung, Übersetzungstools und einige medizinische KI-Systeme.
F: Braucht man Programmierkenntnisse, um maschinelles Lernen zu lernen?
A: Die Grundideen lassen sich ohne Programmierkenntnisse verstehen, aber das Erstellen echter Modelle für maschinelles Lernen erfordert in der Regel Programmierung, Statistik, Datenverarbeitung und Testkenntnisse.


