Más allá de los LLM: lo que TypeSafe Jev significa para la IA de Sistema Uno
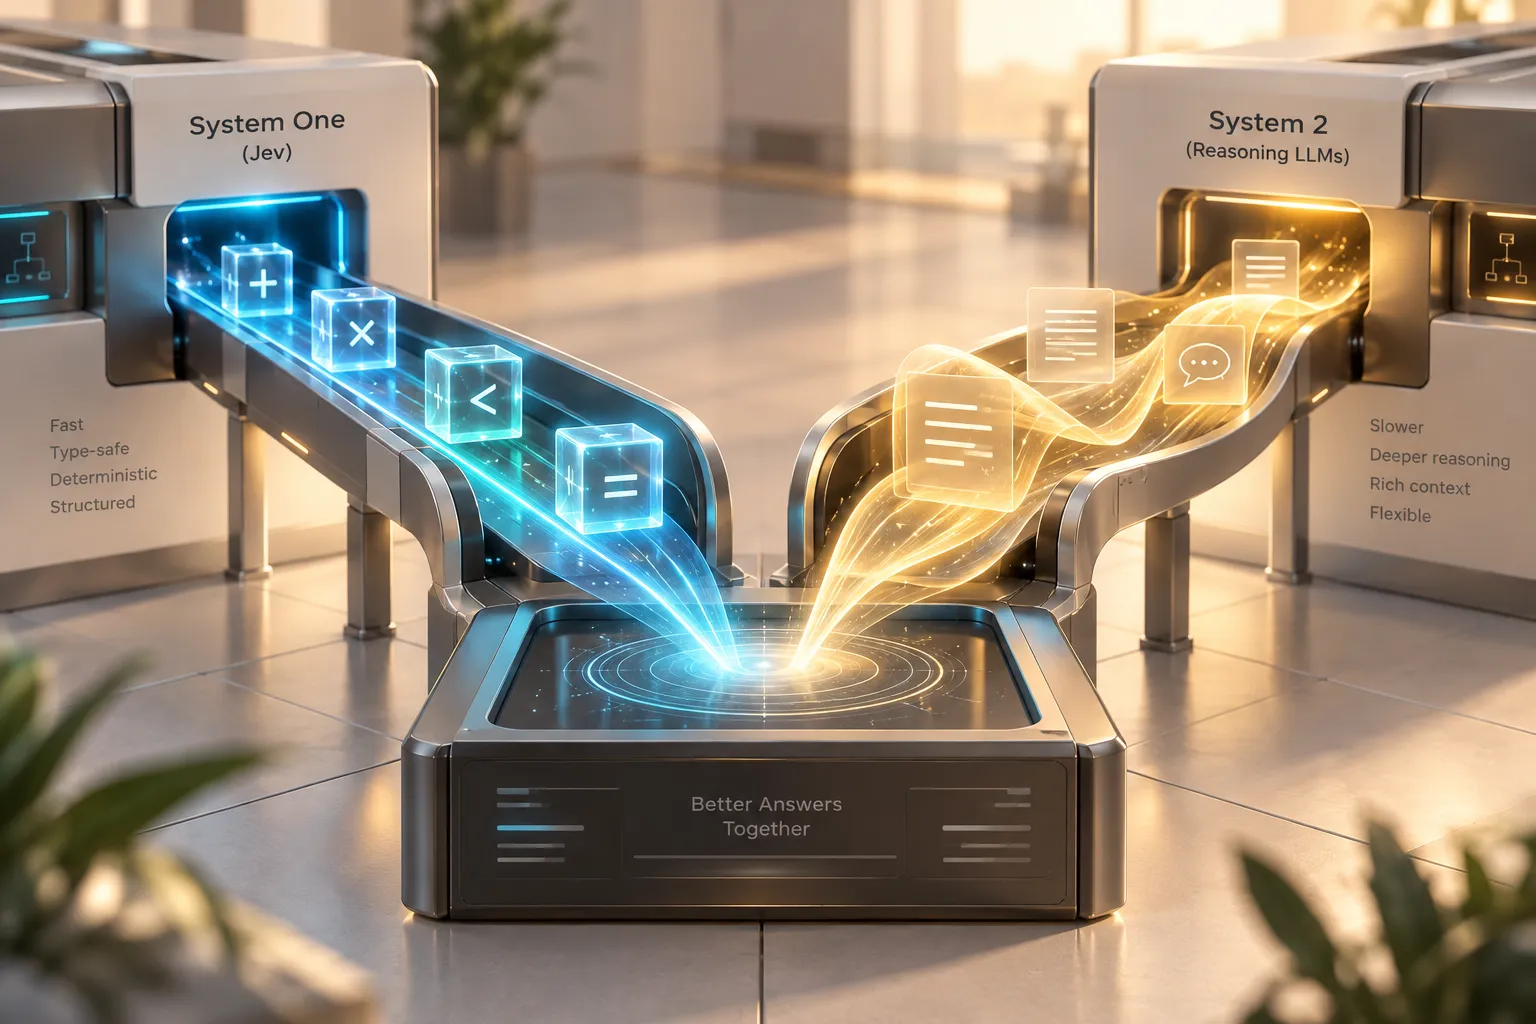
En economía conductual, el ganador del Premio Nobel Daniel Kahneman presentó al mundo el Sistema 1 (decisiones rápidas, instintivas y paralelas) y el Sistema 2 (razonamiento lento, deliberado y analítico).
Durante años, el auge de la IA generativa se ha obsesionado con construir enormes motores de Sistema 2: gigantescos LLM de razonamiento como Claude 3.5, GPT-4 y Gemini 1.5 que redactan ensayos, componen código y resuelven problemas complejos de varios pasos.
Sin embargo, el desarrollo de software enfrenta un cuello de botella silencioso: la mayoría de las operaciones dentro de las apps modernas no requieren razonamiento complejo ni prosa en lenguaje natural. Requieren decisiones estructuradas y ultrarrápidas, como enrutar un ticket, asignar una puntuación de confianza o detectar spam. Usar un LLM conversacional gigante para estas tareas es como contratar a un filósofo para accionar un interruptor de luz: es lento, costoso y propenso a romper los analizadores de JSON.
Presentamos Jev, el modelo insignia Sistema Uno lanzado por TypeSafe AI.
Si desarrollas software con IA, aquí tienes un desglose completo de qué son los modelos de Sistema Uno, cómo funciona Jev y por qué este cambio podría rediseñar fundamentalmente la forma en que la IA encaja en tu stack de producción.
¿Qué es un modelo de Sistema Uno?
Un modelo de Sistema Uno es un modelo de IA diseñado específicamente para la toma de decisiones tipada, delimitada y de alta velocidad, en lugar de la generación de texto de final abierto.
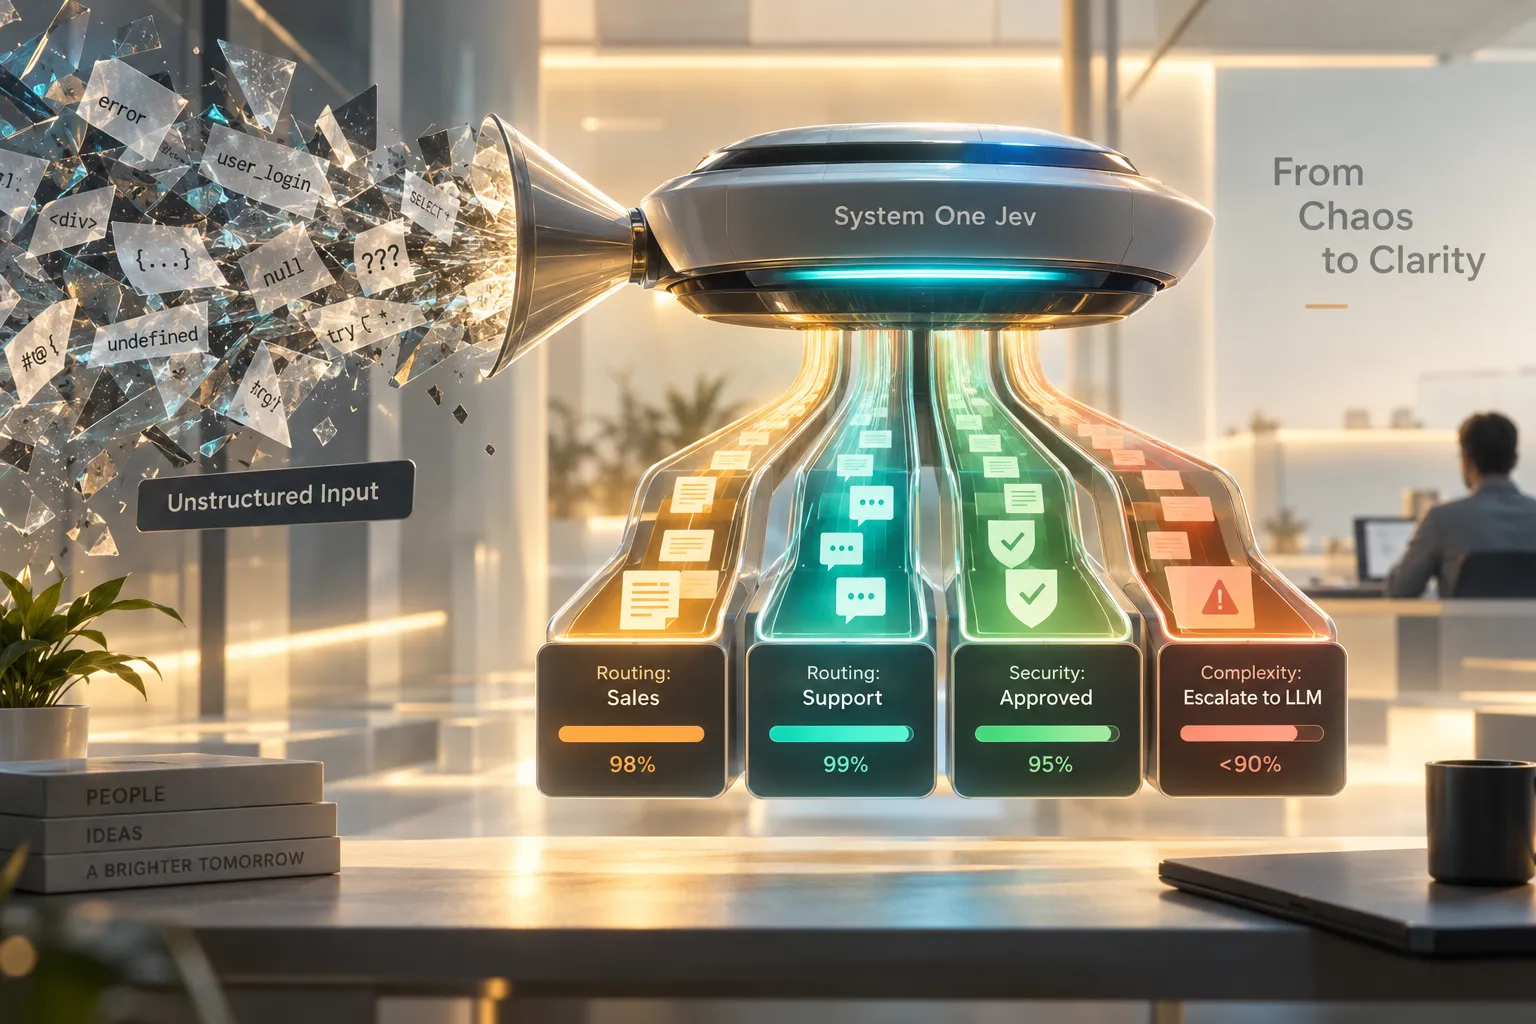
En lugar de generar texto sin procesar token por token, un modelo de Sistema Uno acepta estado de programa no estructurado (p. ej., registros de texto, entrada del usuario u objetos JSON) y evalúa opciones definidas en una única pasada paralela.
[Entrada / estado no estructurado] ---> [ Modelo de Sistema Uno (Jev) ] ---> [ Decisión con seguridad de tipos + probabilidad ]
En lugar de generar prosa, devuelve primitivas con seguridad de tipos como:
- Opción: selección categórica de un conjunto definido de opciones (hasta 255 opciones).
- Puntuación: calificaciones numéricas según métricas definidas.
- Booleano (Noul): probabilidades calibradas de sí/no.
¿Qué hace que TypeSafe Jev sea diferente de los LLM estándar?
Para entender por qué la adopción de Jev por parte de los desarrolladores ha aumentado, considera cómo se compara con LLM de frontera estándar como GPT-4o o Claude:
| Característica | LLM estándar de chat/razonamiento | Modelos de Sistema Uno (Jev) |
| Tipo de salida | Cadenas no estructuradas (prosa, texto JSON) | Valores estrictamente tipados (opción, puntuación, booleano) |
| Mecanismo de muestreo | Autorregresivo (token por token) | Una única pasada paralela |
| Latencia | De 1 a más de 10 segundos | 70 ms – 500 ms |
| Puntuación de confianza | A menudo con exceso de confianza o sin calibrar | Probabilidades calibradas por salida |
| Errores de tipo / ruptura de esquema | Riesgo de salida malformada/fallas al analizar JSON | Tasa de errores de tipo del 0 % (por construcción) |
| Caso de uso principal | Generación de contenido, chat, razonamiento de agentes | Enrutamiento de tickets, detección de spam, control de agentes |
Ventajas clave de la arquitectura Sistema Uno de Jev
1. Cero alucinaciones y errores de tipo
Dado que los modelos de Sistema Uno no generan oraciones de forma libre, eliminan los errores de formato. Las aplicaciones de software no necesitan lógica de reintento compleja ni análisis defensivo de JSON: la salida sigue estrictamente el esquema declarado en el código.
2. Confianza calibrada integrada
Los LLM tradicionales son conocidos por dar respuestas incorrectas con confianza. Jev se entrena mediante técnicas como Aprendizaje por refuerzo para decisiones calibradas (RLCD), proporcionando una probabilidad matemática junto a cada decisión.
Esto permite a los desarrolladores crear compuertas lógicas claras:
- Confianza > 95 %: ejecutar automáticamente.
- Confianza < 80 %: enviar a revisión humana o escalar a un modelo de Sistema 2 más potente (como Claude o GPT-4).
3. Eficiencia de latencia y costos
Al eliminar la sobrecarga de la generación de texto autorregresiva, los modelos de Sistema Uno funcionan hasta entre 40 y 100 veces más rápido que los LLM conversacionales tradicionales. Los costos de los tokens de entrada disminuyen drásticamente, mientras que la sobrecarga estándar de generación de salida se elimina por completo.
Casos de uso reales: dónde encaja Sistema Uno en tu arquitectura
Jev y los modelos de Sistema Uno no están destinados a reemplazar LLM como ChatGPT o Claude; están diseñados para ubicarse delante de ellos o junto a ellos como una capa de decisiones rápida y determinista.
                     ┌────────────────────────┐
                     │ Solicitud entrante del usuario │
                     └───────────┬────────────┘
                                 │
                                 ▼
                     ┌────────────────────────┐
                     │  Sistema Uno (API de Jev)  │
                     └───────────┬────────────┘
                                 │
          ┌──────────────────────┴──────────────────────┐
          │ Alta confianza (>90%)                      │ Baja confianza (<90%)
          ▼                                             ▼
┌──────────────────┐                           ┌──────────────────┐
│ Ruta automatizada │                           │ Sistema 2 (LLM)   │
│ o ejecución de herramientas│                           │ / Escalamiento humano│
└──────────────────┘                           └──────────────────┘
Aplicaciones clave:
- Enrutamiento de tickets de soporte y leads: categorización instantánea de tickets entrantes (p. ej., {facturación, técnico, ventas}) y puntuación de urgencia sin analizar respuestas de texto desordenadas.
- Autorización de herramientas para agentes de IA: decidir si una llamada a una herramienta debe aprobarse automáticamente según reglas de seguridad, eliminando demoras en bucles autónomos.
- Canalizaciones RAG en cascada: evaluar si el contexto de documentos vectoriales recuperados es relevante antes de enviarlo a un modelo generativo costoso.
- Moderación y barreras de seguridad: analizar solicitudes entrantes de usuarios o salidas de modelos en busca de infracciones de políticas en menos de 100 ms.
Limitaciones: lo que Jev NO puede hacer
Para desarrollar eficazmente con modelos de Sistema Uno, es esencial comprender sus límites:
- Sin generación de texto libre: Jev no puede redactar correos electrónicos, escribir código, resumir documentos extensos en prosa ni conversar.
- Sin conocimiento interno del mundo: Jev depende por completo del estado que se le proporciona; no puede navegar por la web ni realizar por sí solo una recuperación compleja de conocimiento interno.
- Requiere un esquema predefinido: debes conocer el conjunto delimitado exacto de opciones o criterios de puntuación antes de realizar la llamada a la API.
El veredicto: la arquitectura de doble modelo ya está aquí
El lanzamiento de Jev de TypeSafe marca un cambio clave en la ingeniería de IA. La era de usar un único LLM masivo y costoso para cada paso de una aplicación está desapareciendo.
En cambio, las aplicaciones de grado de producción están avanzando hacia una arquitectura híbrida:
- Sistema Uno (Jev): gestiona clasificación rápida y de alto volumen, selección de herramientas, enrutamiento y filtrado con baja latencia.
- Sistema 2 (GPT/Claude/Gemini): se encarga de la generación de textos extensos, el razonamiento complejo y el análisis de final abierto.
Al delegar las microdecisiones a los modelos de Sistema Uno, los desarrolladores pueden crear sistemas de IA más rápidos, mucho más económicos y matemáticamente confiables.
Mientras las arquitecturas de backend avanzan hacia modelos de baja latencia como Jev para agilizar los datos, la presentación y los informes de frontend tampoco deberían ser un cuello de botella. Descubre cómo Inteligencia de Presentaciones (PI) ayuda a los equipos a crear, estructurar y automatizar al instante presentaciones comerciales e informes de alto impacto.


