Au-delà des LLM : ce que TypeSafe Jev signifie pour l’IA du système un
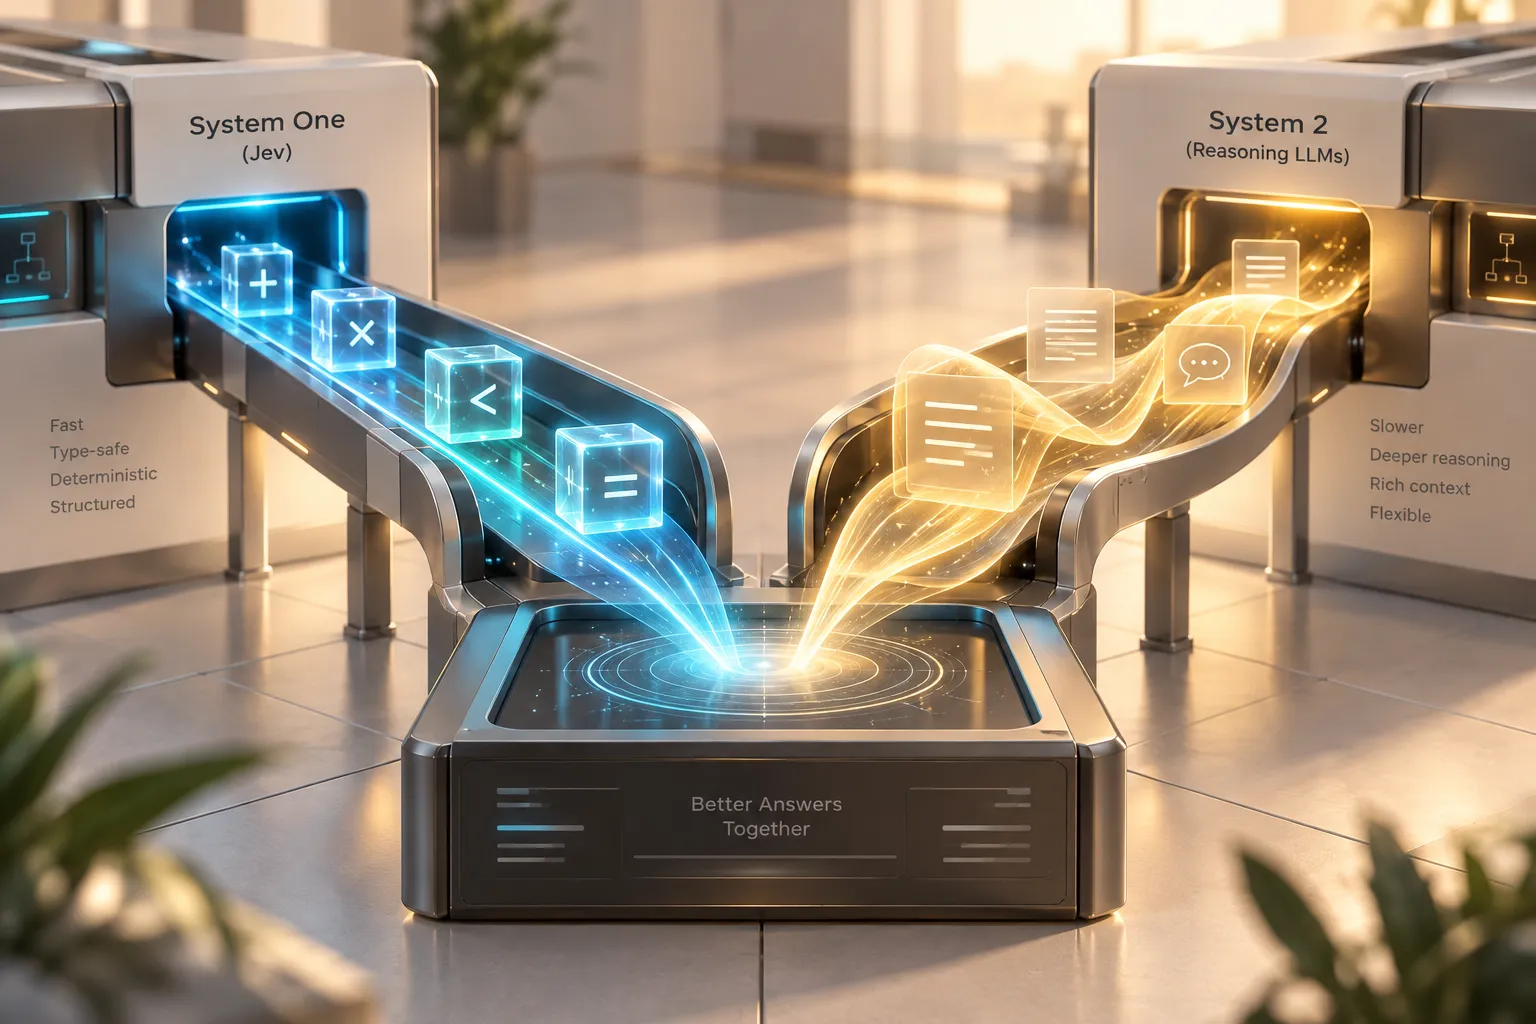
En économie comportementale, le lauréat du prix Nobel Daniel Kahneman a fait connaître au monde le Système 1 (décisions rapides, instinctives et parallèles) et le Système 2 (raisonnement lent, délibéré et analytique).
Depuis des années, le boom de l’IA générative est obsédé par la construction d’immenses moteurs de Système 2 : de grands LLM de raisonnement comme Claude 3.5, GPT-4 et Gemini 1.5, qui rédigent des essais, composent du code et résolvent des problèmes complexes en plusieurs étapes.
Cependant, le développement logiciel fait face à un goulot d’étranglement silencieux : la plupart des opérations au sein des applications modernes ne nécessitent pas de raisonnement complexe ni de prose en langage naturel. Elles nécessitent des décisions structurées et ultrarapides — comme acheminer un ticket, attribuer un score de confiance ou détecter le spam. Utiliser un immense LLM conversationnel pour ces tâches revient à embaucher un philosophe pour actionner un interrupteur : c’est lent, coûteux et susceptible de casser les analyseurs JSON.
Découvrez Jev, le modèle Système Un phare publié par TypeSafe AI.
Si vous développez des logiciels avec l’IA, voici une analyse complète de ce que sont les modèles Système Un, du fonctionnement de Jev et des raisons pour lesquelles ce changement pourrait fondamentalement réarchitecturer la façon dont l’IA s’intègre à votre stack de production.
Qu’est-ce qu’un modèle Système Un ?
Un modèle Système Un est un modèle d’IA conçu spécifiquement pour une prise de décision rapide, bornée et typée, plutôt que pour la génération de texte ouverte.
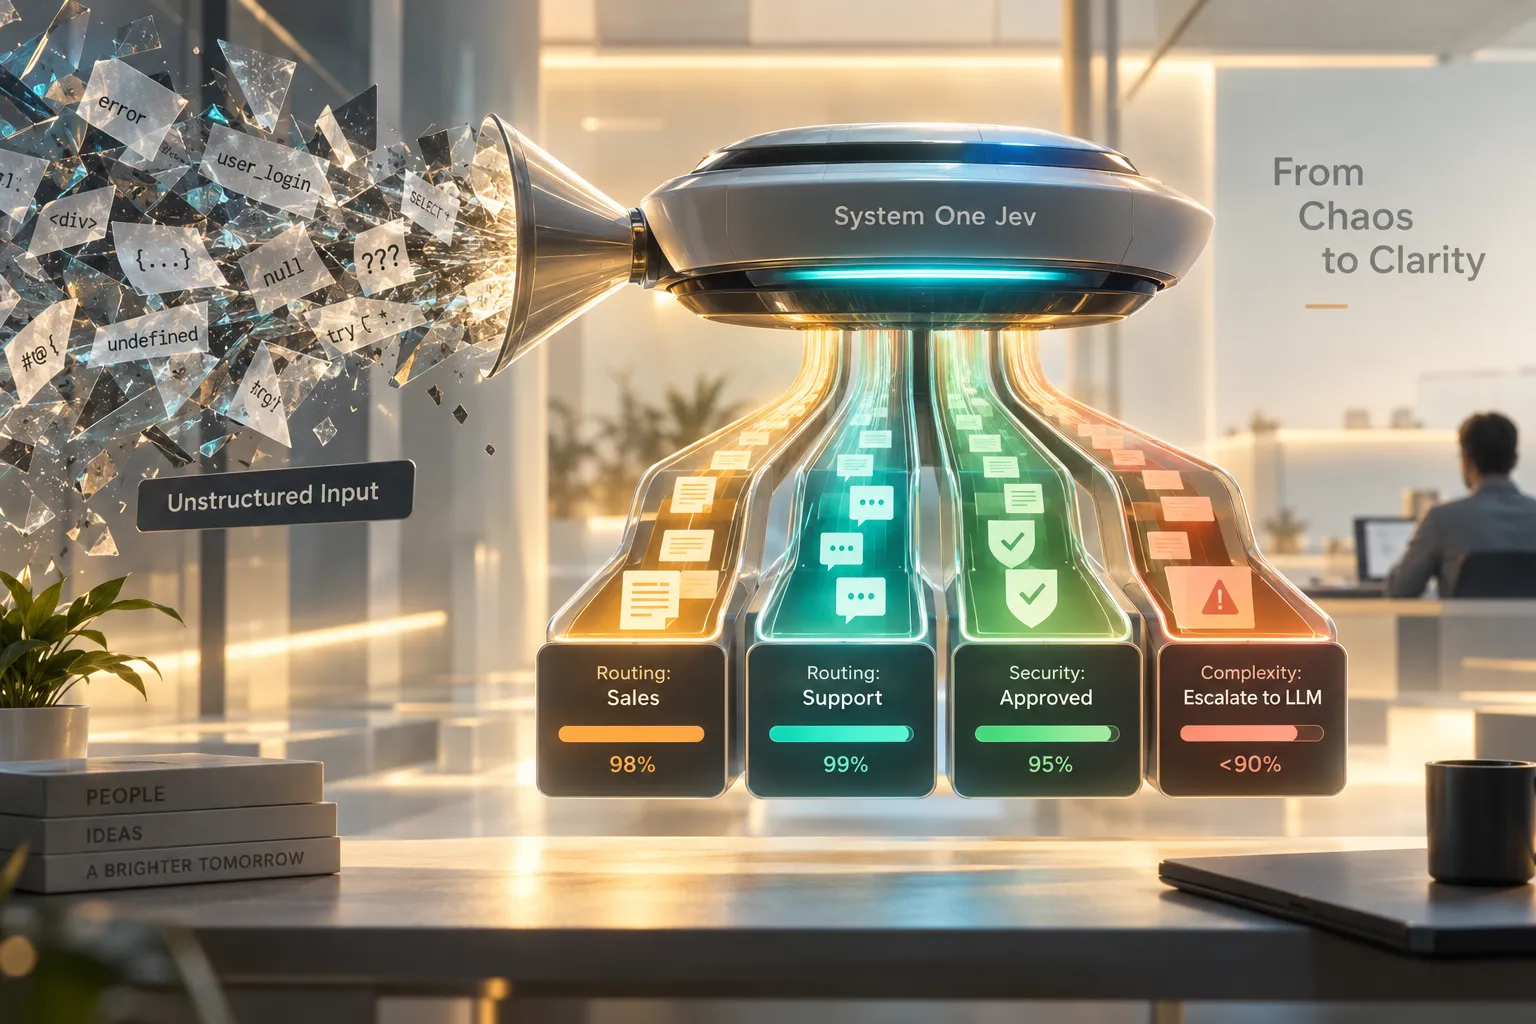
Au lieu de générer du texte brut jeton par jeton, un modèle Système Un accepte un état de programme non structuré (p. ex., des journaux texte, des entrées utilisateur ou des objets JSON) et évalue des choix définis en un seul passage parallèle.
[Entrée / état non structuré] ---> [ Modèle Système Un (Jev) ] ---> [ Décision typée + probabilité ]
Au lieu de produire de la prose, il renvoie des primitives typées telles que :
- Choix : sélection catégorielle parmi un ensemble défini d’options (jusqu’à 255 options).
- Score : évaluations numériques selon des métriques définies.
- Booléen (Noul) : probabilités oui/non calibrées.
Qu’est-ce qui distingue TypeSafe Jev des LLM standard ?
Pour comprendre pourquoi l’adoption de Jev par les développeurs a explosé, examinons sa comparaison avec des LLM de pointe standard comme GPT-4o ou Claude :
| Fonctionnalité | LLM de chat/raisonnement standard | Modèles Système Un (Jev) |
| Type de sortie | Chaînes non structurées (prose, texte JSON) | Valeurs strictement typées (choix, score, booléen) |
| Mécanisme d’échantillonnage | Autorégressif (jeton par jeton) | Un seul passage parallèle |
| Latence | 1 à plus de 10 secondes | 70 ms – 500 ms |
| Évaluation de la confiance | Souvent trop confiante ou non calibrée | Probabilités calibrées par sortie |
| Erreurs de type / rupture de schéma | Risque de sortie mal formée / d’échecs d’analyse JSON | Taux d’erreur de type de 0 % (par construction) |
| Cas d’utilisation principal | Génération de contenu, conversation, raisonnement d’agent | Acheminement des tickets, détection du spam, contrôle des agents |
Principaux avantages de l’architecture Jev Système Un
1. Zéro hallucination et erreur de type
Comme les modèles Système Un ne génèrent pas de phrases en forme libre, ils éliminent les erreurs de formatage. Les applications logicielles n’ont pas besoin d’une logique complexe de nouvelle tentative ni d’une analyse JSON défensive : la sortie respecte strictement le schéma déclaré dans le code.
2. Confiance calibrée intégrée
Les LLM traditionnels sont réputés pour fournir avec assurance des réponses erronées. Jev est entraîné à l’aide de techniques telles que l’apprentissage par renforcement pour les décisions calibrées (RLCD), qui fournit une probabilité mathématique avec chaque décision.
Cela permet aux développeurs de créer des portes logiques simples :
- Confiance > 95 % : exécuter automatiquement.
- Confiance < 80 % : transmettre à une révision humaine ou escalader vers un modèle Système 2 plus puissant (comme Claude ou GPT-4).
3. Efficacité en matière de latence et de coût
En éliminant la surcharge liée à la génération de texte autorégressive, les modèles Système Un fonctionnent jusqu’à 40 à 100 fois plus vite que les LLM conversationnels traditionnels. Les coûts des jetons d’entrée chutent drastiquement, tandis que la surcharge standard de génération de sortie est entièrement supprimée.
Cas d’utilisation réels : où le Système Un s’intègre dans votre architecture
Jev et les modèles Système Un ne sont pas conçus pour remplacer des LLM comme ChatGPT ou Claude : ils sont conçus pour se placer devant ou à leurs côtés en tant que couche de décision rapide et déterministe.
                     ┌────────────────────────┐
                     │ Requête utilisateur entrante │
                     └───────────┬────────────┘
                                 │
                                 ▼
                     ┌────────────────────────┐
                     │ Système Un (API Jev)    │
                     └───────────┬────────────┘
                                 │
          ┌──────────────────────┴──────────────────────┐
          │ Confiance élevée (>90 %)                     │ Confiance faible (<90 %)
          ▼                                             ▼
┌──────────────────┐                           ┌──────────────────┐
│ Routage automatisé│                          │ Système 2 (LLM)  │
│ ou exécution d’outil│                        │ / escalade humaine│
└──────────────────┘                           └──────────────────┘
Applications clés :
- Acheminement des tickets de support et des prospects : catégoriser instantanément les tickets entrants (p. ex., {facturation, technique, ventes}) et évaluer leur urgence sans analyser des réponses textuelles désordonnées.
- Autorisation d’outils pour agents IA : décider si un appel d’outil doit être approuvé automatiquement selon des règles de sécurité, en éliminant les délais dans les boucles autonomes.
- Pipelines RAG en cascade : évaluer si le contexte documentaire vectoriel récupéré est pertinent avant de l’envoyer à un modèle génératif coûteux.
- Modération et garde-fous : analyser les requêtes utilisateur entrantes ou les sorties de modèle afin de détecter les violations de politiques en moins de 100 ms.
Limites : ce que Jev NE PEUT PAS faire
Pour développer efficacement avec des modèles Système Un, il est essentiel de comprendre leurs limites :
- Pas de génération de texte libre : Jev ne peut pas rédiger d’e-mails, écrire du code, résumer de longs documents en prose ni converser.
- Pas de connaissance interne du monde : Jev repose entièrement sur l’état qui lui est transmis ; il ne peut pas naviguer sur le Web ni effectuer seul une récupération complexe de connaissances internes.
- Nécessite un schéma prédéfini : vous devez connaître l’ensemble borné exact de choix ou les critères de notation avant d’effectuer l’appel API.
Le verdict : l’architecture à deux modèles est arrivée
Le lancement de Jev par TypeSafe marque un changement majeur dans l’ingénierie de l’IA. L’époque où l’on utilisait un seul LLM massif et coûteux pour chaque étape d’une application s’estompe.
À la place, les applications de niveau production évoluent vers une architecture hybride :
- Système Un (Jev) : gère la classification rapide à fort volume, la sélection d’outils, l’acheminement et le filtrage avec une faible latence.
- Système 2 (GPT/Claude/Gemini) : prend le relais pour la génération de textes longs, le raisonnement complexe et l’analyse ouverte.
En déléguant les microdécisions aux modèles Système Un, les développeurs peuvent créer des systèmes d’IA plus rapides, radicalement moins coûteux et mathématiquement fiables.
Alors que les architectures backend évoluent vers des modèles à faible latence comme Jev pour rationaliser les données, la présentation et le reporting côté front-end ne devraient pas non plus constituer un goulot d’étranglement. Découvrez comment la Presentation Intelligence (PI) aide les équipes à créer, structurer et automatiser instantanément des présentations commerciales et des rapports à fort impact.


