मशीन लर्निंग क्या है
यदि आप पूछ रहे हैं कि मशीन लर्निंग क्या है, तो सबसे सरल उत्तर यह है: मशीन लर्निंग कंप्यूटरों के लिए डेटा से पैटर्न सीखने और उन पैटर्नों का उपयोग करके पूर्वानुमान, सिफारिशें या निर्णय लेने का एक तरीका है। हर नियम को हाथ से लिखने के बजाय, लोग सिस्टम को उदाहरण देते हैं और सिस्टम उनसे सीखता है।
NIST की शब्दावली मशीन लर्निंग को ऐसे कंप्यूटर सिस्टम के रूप में परिभाषित करती है जो सटीकता सुधारने के लिए डेटा से अनुकूलित होते हैं और सीखते हैं। यह तकनीकी लग सकता है, लेकिन रोज़मर्रा का विचार परिचित है: सिस्टम जितने अधिक उपयोगी उदाहरण देखता है, वह पैटर्नों को उतना ही बेहतर पहचान सकता है।
सरल शब्दों में मशीन लर्निंग क्या है
मशीन लर्निंग कृत्रिम बुद्धिमत्ता की एक शाखा है। IBM, Google Cloud, Microsoft Azure, और AWS सभी इसे समान तरीके से समझाते हैं: मशीन लर्निंग डेटा और एल्गोरिदम का उपयोग करके ऐसे सिस्टम को प्रशिक्षित करती है जो हर मामले के लिए स्पष्ट रूप से प्रोग्राम किए बिना पूर्वानुमान लगा सकते हैं या पैटर्न खोज सकते हैं।
कल्पना कीजिए कि आप किसी बच्चे को कुत्तों को पहचानना सिखा रहे हैं। आप कान के हर संभव आकार, पूँछ की लंबाई और फर के रंग की सूची नहीं बनाते। आप उदाहरण दिखाते हैं। समय के साथ, बच्चा पैटर्न सीख लेता है। मशीन लर्निंग भी इसी तरह काम करती है, लेकिन डेटा, गणित और एल्गोरिदम के साथ।
मशीन लर्निंग कैसे काम करती है
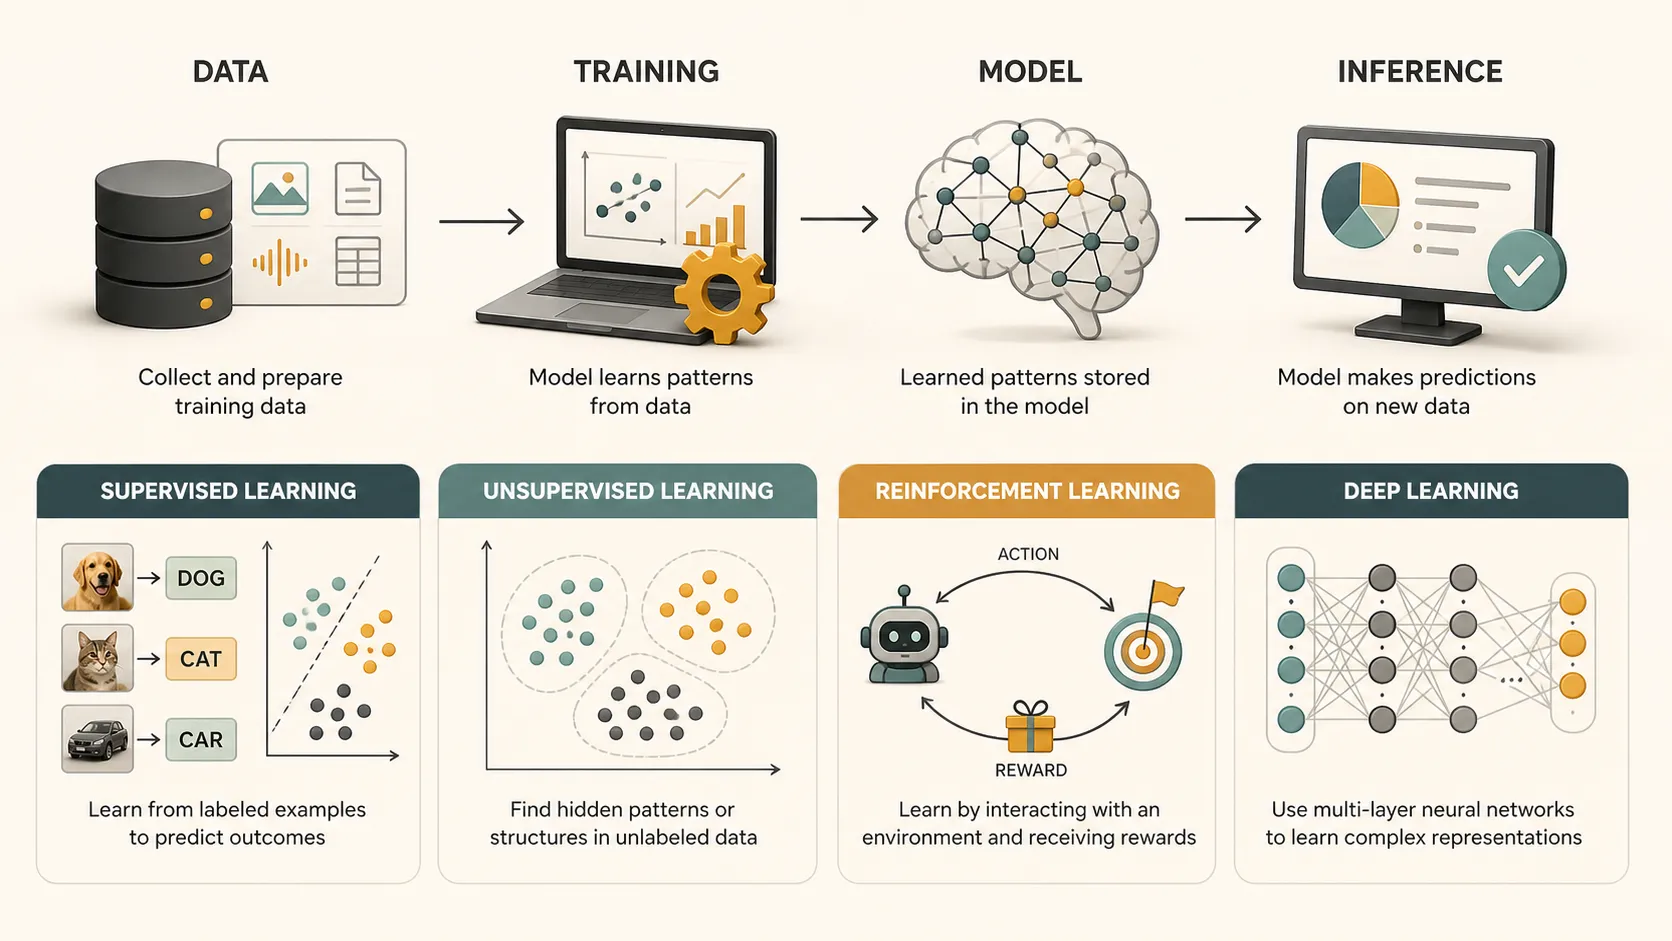
अधिकांश मशीन लर्निंग परियोजनाएँ एक बुनियादी प्रवाह का पालन करती हैं: डेटा एकत्र करना, उसे तैयार करना, मॉडल को प्रशिक्षित करना, उसका परीक्षण करना, और फिर नए इनपुट पर मॉडल का उपयोग करना। AWS की मशीन लर्निंग एप्लिकेशन बनाने संबंधी मार्गदर्शिका इसे एक पुनरावृत्त प्रक्रिया के रूप में बताती है: समस्या को परिभाषित करें, डेटा तैयार करें, उपयोगी फीचर बनाएँ, मॉडल को प्रशिक्षित करें, उसका मूल्यांकन करें और पूर्वानुमान के लिए उसका उपयोग करें।
स्पैम फ़िल्टर एक सरल उदाहरण है। सिस्टम “स्पैम” और “स्पैम नहीं” लेबल वाले ईमेल से सीखता है। प्रशिक्षण के दौरान, यह संदिग्ध लिंक, बार-बार आने वाले वाक्यांश, प्रेषक का व्यवहार या फ़ॉर्मैटिंग जैसे पैटर्न देखता है। अनुमान के दौरान, यह अपनी सीखी हुई बात को नए ईमेल पर लागू करता है और पूर्वानुमान लगाता है कि वह स्पैम है या नहीं।
महत्वपूर्ण शब्द है “पूर्वानुमान लगाता है।” मशीन लर्निंग किसी व्यक्ति की तरह दुनिया को नहीं समझती। यह सांख्यिकीय पैटर्न खोजती है। यह शक्तिशाली हो सकता है, लेकिन इसका अर्थ यह भी है कि डेटा की गुणवत्ता बेहद महत्वपूर्ण होती है।
मशीन लर्निंग के सामान्य प्रकार
मशीन लर्निंग कोई एकल विधि नहीं है। इसमें कई प्रमुख दृष्टिकोण शामिल हैं:
| प्रकार | यहाँ मशीन लर्निंग का उपयोग किस लिए किया जाता है? | उदाहरण |
|---|---|---|
| पर्यवेक्षित अधिगम | लेबल किए गए उदाहरणों से सीखना | पिछली बिक्री के आधार पर घर की कीमतों का पूर्वानुमान लगाना |
| अपर्यवेक्षित अधिगम | लेबल के बिना पैटर्न खोजना | ग्राहकों को व्यवहार के आधार पर समूहित करना |
| पुनर्बलन अधिगम | पुरस्कार और दंड के माध्यम से सीखना | गेम खेलने वाले एजेंट को प्रशिक्षित करना |
| डीप लर्निंग | परतदार न्यूरल नेटवर्क का उपयोग करना | छवि पहचान या भाषण प्रतिलेखन |
Stanford CS229 पर्यवेक्षित अधिगम, अपर्यवेक्षित अधिगम, न्यूरल नेटवर्क और पुनर्बलन अधिगम जैसे मुख्य विषयों के माध्यम से मशीन लर्निंग सिखाता है। Google का Machine Learning Crash Course शुरुआती लोगों के लिए भी उपयोगी है क्योंकि यह व्यावहारिक उदाहरणों के साथ अवधारणाओं को समझाता है। जो लोग व्यावहारिक दस्तावेज़ीकरण चाहते हैं, उनके लिए scikit-learn उपयोगकर्ता मार्गदर्शिका और TensorFlow मशीन लर्निंग की मूल बातें मजबूत तकनीकी संदर्भ हैं।
मशीन लर्निंग बनाम AI बनाम डीप लर्निंग
लोग अक्सर AI, मशीन लर्निंग और डीप लर्निंग को गड्डमड्ड कर देते हैं। वे संबंधित हैं, लेकिन एक जैसे नहीं हैं।
कृत्रिम बुद्धिमत्ता व्यापक क्षेत्र है: ऐसे सिस्टम बनाना जो मानव बुद्धिमत्ता से जुड़ी तर्क, भाषा, धारणा, सीखने या निर्णय लेने जैसी क्षमताओं वाले कार्य कर सकें। मशीन लर्निंग AI सिस्टम बनाने का एक तरीका है। डीप लर्निंग मशीन लर्निंग का एक प्रकार है जो कई परतों वाले न्यूरल नेटवर्क का उपयोग करता है।
इसलिए संबंध सरल है: AI बड़ी श्रेणी है। मशीन लर्निंग AI के भीतर आती है। डीप लर्निंग मशीन लर्निंग के भीतर आती है।
कैलकुलेटर निश्चित नियमों का पालन करता है, इसलिए वह मशीन लर्निंग नहीं है। उपयोगकर्ता के व्यवहार से सीखकर बेहतर होने वाली सिफारिश प्रणाली मशीन लर्निंग है। गहरे न्यूरल नेटवर्क का उपयोग करने वाला बड़ा भाषा मॉडल डीप लर्निंग है।
मशीन लर्निंग के वास्तविक उदाहरण
मशीन लर्निंग पहले से ही सामान्य जीवन का हिस्सा है। स्ट्रीमिंग सेवाएँ इसका उपयोग वीडियो सुझाने के लिए करती हैं। बैंक असामान्य लेनदेन का पता लगाने के लिए इसका उपयोग करते हैं। ईमेल सेवाएँ स्पैम फ़िल्टर करने के लिए इसका उपयोग करती हैं। अनुवाद उपकरण भाषा का अनुवाद करने के लिए इसका उपयोग करते हैं। सर्च इंजन प्रासंगिकता और रैंकिंग संकेतों को समझने के लिए इसका उपयोग करते हैं।
स्वास्थ्य सेवा में, FDA AI-सक्षम चिकित्सा उपकरणों की एक सूची रखता है, जिनमें से कई इमेजिंग, निदान या नैदानिक सहायता के लिए AI या मशीन लर्निंग तकनीकों का उपयोग करते हैं। यह एक अच्छा स्मरण है कि मशीन लर्निंग उपयोगी हो सकती है, लेकिन उच्च-दांव वाले सिस्टम को परीक्षण और निगरानी की आवश्यकता होती है।
विज्ञान एक और मजबूत उदाहरण है। AlphaFold प्रोटीन संरचनाओं का पूर्वानुमान लगाने के लिए AI का उपयोग करता है, जिससे शोधकर्ताओं को जीवविज्ञान का अधिक कुशलता से अध्ययन करने में मदद मिलती है। यह दिखाता है कि मशीन लर्निंग केवल विज्ञापनों, ऐप्स और डैशबोर्ड के लिए नहीं है; यह वैज्ञानिक खोज का भी समर्थन कर सकती है।
डेटा की गुणवत्ता क्यों महत्वपूर्ण है
मशीन लर्निंग मॉडल उतना ही अच्छा होता है जितना उसके पीछे का डेटा और धारणाएँ। यदि प्रशिक्षण डेटा अधूरा, पक्षपाती, पुराना या गलत तरीके से लेबल किया गया है, तो मॉडल गलत पैटर्न सीख सकता है।
उदाहरण के लिए, पक्षपाती पिछले भर्ती डेटा पर प्रशिक्षित भर्ती मॉडल उन पैटर्नों को दोहरा सकता है। मुख्यतः एक आबादी पर प्रशिक्षित चिकित्सा मॉडल किसी दूसरी आबादी के लिए खराब प्रदर्शन कर सकता है। सिफारिश मॉडल बहुत संकीर्ण हो सकता है और उपयोगकर्ताओं को बार-बार उसी तरह की चीज़ें दिखाता रह सकता है।
अच्छे मशीन लर्निंग कार्य में डेटा सफाई, परीक्षण, सत्यापन, निगरानी और मानवीय समीक्षा शामिल होती है। इसका अर्थ असहज प्रश्न पूछना भी है: डेटा में किसका प्रतिनिधित्व है? कौन छूट गया है? यदि मॉडल गलत हो जाए तो क्या होगा?
Pi के साथ मशीन लर्निंग को दृश्य रूप से समझाना
मशीन लर्निंग अमूर्त लग सकती है क्योंकि महत्वपूर्ण कार्य अक्सर अदृश्य होता है: डेटा तैयार करना, मॉडल प्रशिक्षण, मूल्यांकन, तैनाती और फीडबैक लूप। दृश्य व्याख्या लोगों को प्रक्रिया देखने में मदद करती है।
Pi के साथ, आप मशीन लर्निंग की अवधारणाओं को प्रस्तुति में बदल सकते हैं: डेटा-से-मॉडल कार्यप्रवाह, पर्यवेक्षित और अपर्यवेक्षित अधिगम की तुलना, मॉडल की सटीकता दिखाने वाला चार्ट, या प्रशिक्षण और अनुमान की आइकन-आधारित व्याख्या। Pi थीम, रंग, लेआउट, आइकन, चार्ट और AI-जनित दृश्यों को भी अनुकूलित कर सकता है, जिससे तकनीकी विचारों को छात्रों, ग्राहकों, संस्थापकों या आंतरिक टीमों के सामने प्रस्तुत करना आसान हो जाता है।
जोखिम और जिम्मेदार उपयोग
मशीन लर्निंग सिस्टम गलतियाँ कर सकते हैं। वे पक्षपात को बढ़ा सकते हैं, निजी जानकारी उजागर कर सकते हैं, अनुचित परिणाम उत्पन्न कर सकते हैं या उन्हें समझाना कठिन हो सकता है। यही कारण है कि जिम्मेदार AI महत्वपूर्ण है।
NIST AI जोखिम प्रबंधन फ्रेमवर्क संगठनों को भरोसेमंद AI के जोखिमों के बारे में सोचने का एक तरीका देता है। OECD AI सिद्धांत मानव-केंद्रित मूल्यों, निष्पक्षता, पारदर्शिता, मजबूती, सुरक्षा और जवाबदेही पर जोर देते हैं।
शुरुआती लोगों के लिए निष्कर्ष सरल है: मशीन लर्निंग का मूल्यांकन केवल सटीकता से नहीं होना चाहिए। इसका मूल्यांकन निष्पक्षता, सुरक्षा, गोपनीयता, व्याख्येयता और वास्तविक दुनिया पर प्रभाव के आधार पर भी होना चाहिए।
निष्कर्ष
मशीन लर्निंग कंप्यूटरों को डेटा से पैटर्न सीखने और उन पैटर्नों को नई परिस्थितियों में लागू करने का अभ्यास है। यह आधुनिक AI के प्रमुख इंजनों में से एक है, जो सिफारिशों और धोखाधड़ी पहचान से लेकर चिकित्सा उपकरणों और वैज्ञानिक अनुसंधान तक काम करता है।
अवधारणा सरल है, लेकिन व्यवहार में सावधानी की आवश्यकता होती है। अच्छी मशीन लर्निंग के लिए अच्छा डेटा, स्पष्ट लक्ष्य, परीक्षण, निगरानी और जिम्मेदार उपयोग चाहिए। सबसे अच्छे मॉडल केवल चतुर नहीं होते। वे उपयोगी, विश्वसनीय और उनसे प्रभावित लोगों के लिए उपयुक्त होते हैं।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
प्र: मशीन लर्निंग क्या है?
उ: मशीन लर्निंग AI की एक शाखा है जिसमें कंप्यूटर डेटा से पैटर्न सीखते हैं और उन पैटर्नों का उपयोग करके पूर्वानुमान, सिफारिशें या निर्णय लेते हैं।
प्र: क्या मशीन लर्निंग कृत्रिम बुद्धिमत्ता के समान है?
उ: नहीं। AI व्यापक क्षेत्र है। मशीन लर्निंग AI सिस्टम बनाने के लिए उपयोग की जाने वाली एक विधि है। डीप लर्निंग मशीन लर्निंग के भीतर की एक छोटी श्रेणी है।
प्र: मशीन लर्निंग के सामान्य उदाहरण क्या हैं?
उ: सामान्य उदाहरणों में सिफारिश प्रणालियाँ, स्पैम फ़िल्टर, धोखाधड़ी पहचान, आवाज़ पहचान, छवि वर्गीकरण, अनुवाद उपकरण और कुछ चिकित्सा AI सिस्टम शामिल हैं।
प्र: क्या मशीन लर्निंग सीखने के लिए कोडिंग की आवश्यकता है?
उ: आप कोडिंग के बिना मूल विचारों को समझ सकते हैं, लेकिन वास्तविक मशीन लर्निंग मॉडल बनाने के लिए आमतौर पर प्रोग्रामिंग, सांख्यिकी, डेटा प्रबंधन और परीक्षण कौशल की आवश्यकता होती है।


