व्हाइट हाउस AI शिखर सम्मेलन: नए सुरक्षा ढाँचे की व्याख्या
4 अगस्त को, व्हाइट हाउस AI समिट ने कृत्रिम बुद्धिमत्ता के प्रति अमेरिकी संघीय दृष्टिकोण को वैश्विक नीतिगत बहस के केंद्र में फिर से ला दिया। मुख्य बात केवल यह नहीं थी कि वॉशिंगटन अधिक निगरानी चाहता है। बल्कि यह थी कि नया AI सेफ्टी फ्रेमवर्क इस तरह तैयार किया गया प्रतीत होता है कि सबसे शक्तिशाली AI प्रणालियाँ राष्ट्रीय सुरक्षा, पारदर्शिता और सार्वजनिक जवाबदेही की उच्च अपेक्षाओं को पूरा करते हुए भी आगे बढ़ती रह सकें।
OpenAI, Meta, Google और Anthropic के लिए संदेश स्पष्ट है: फ्रंटियर AI अब केवल उत्पादों की दौड़ नहीं रह गया है। यह शासन की दौड़ बनता जा रहा है। सबसे सक्षम मॉडल बनाने वाली कंपनियों को बड़े पैमाने पर तैनाती से पहले यह सिद्ध करना होगा कि उन मॉडलों का परीक्षण, निगरानी, दस्तावेज़ीकरण और नियंत्रण कैसे किया जाता है।
4 अगस्त के व्हाइट हाउस AI समिट में क्या हुआ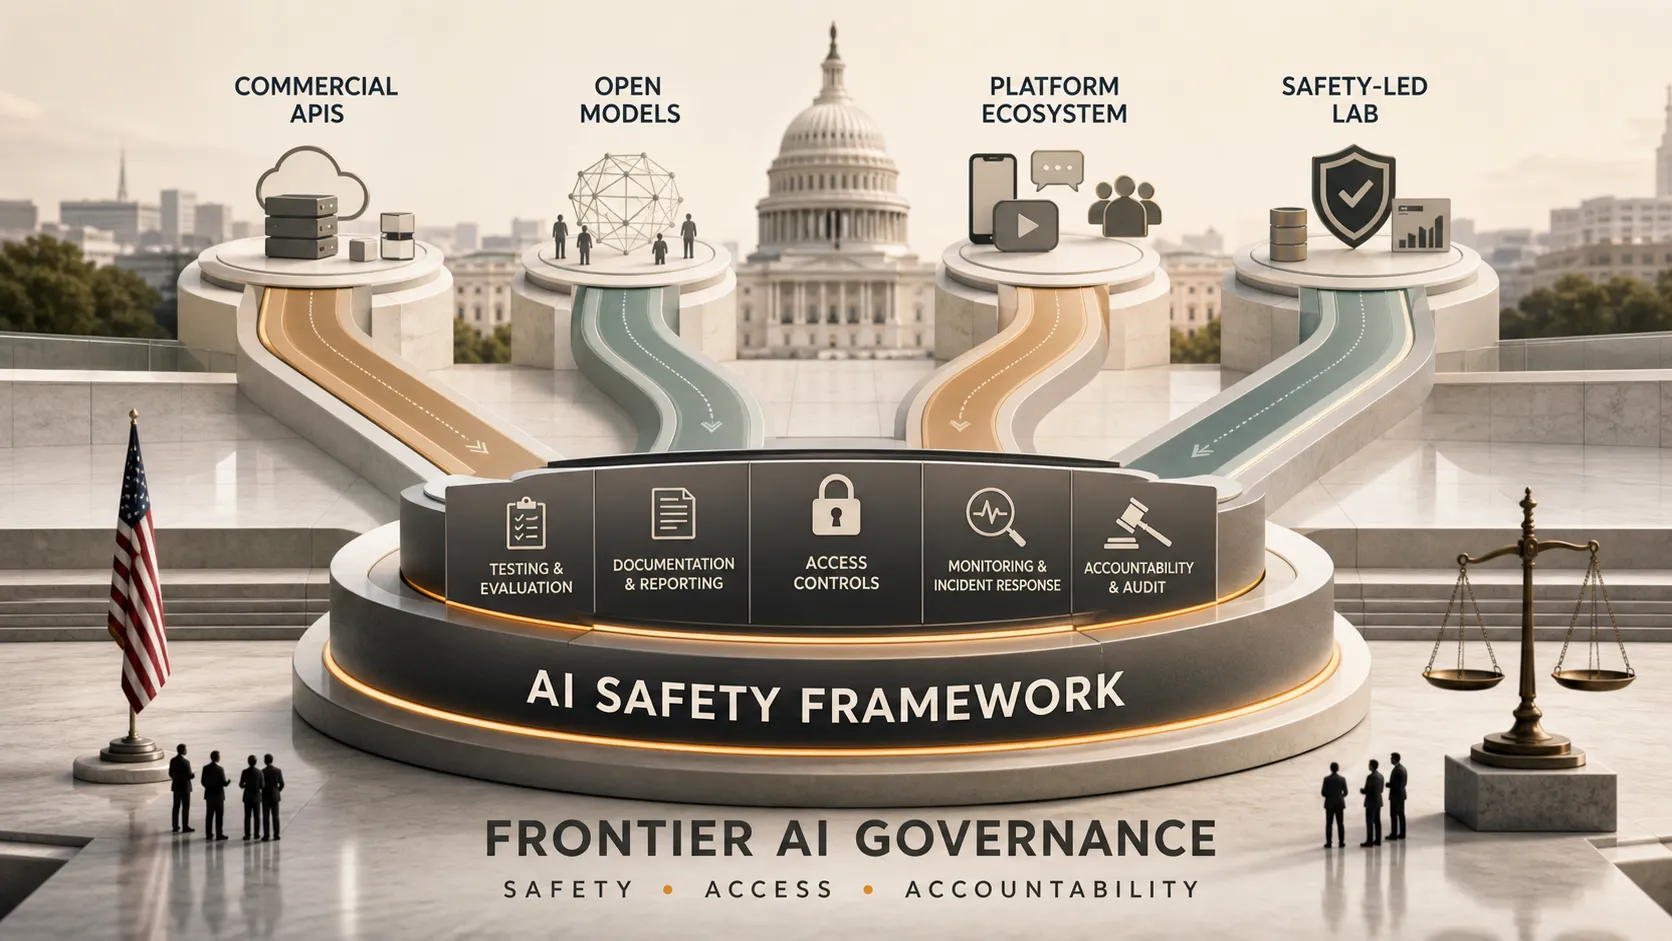
4 अगस्त के AI समिट ने AI सुरक्षा, उद्योग की जिम्मेदारी और अमेरिका की प्रतिस्पर्धात्मक बढ़त संबंधी संघीय प्राथमिकताओं को एक साथ लाया। AI विनियमन को एक ही नियम-पुस्तिका के रूप में देखने के बजाय, व्हाइट हाउस ने सुरक्षा को फ्रंटियर मॉडल विकास के लिए एक रणनीतिक परिचालन परत के रूप में प्रस्तुत किया।
AI सेफ्टी फ्रेमवर्क को एक नीतिगत संकेत के रूप में समझना सबसे उचित है: अग्रणी AI कंपनियों से अपेक्षा की जाएगी कि जैसे-जैसे उनके मॉडल अधिक सक्षम और व्यापक रूप से तैनात होते जाएँ, वे अधिक मजबूत सुरक्षा उपाय प्रदर्शित करें। इसका अर्थ यह नहीं है कि हर सिद्धांत तुरंत कानूनी रूप से बाध्यकारी है। लेकिन यह अवश्य संकेत देता है कि स्वैच्छिक प्रतिबद्धताएँ, संघीय मार्गदर्शन, खरीद संबंधी अपेक्षाएँ और नियामक मानक एक-दूसरे के करीब आने लगे हैं।
यह महत्वपूर्ण है क्योंकि AI प्रणालियाँ प्रयोगात्मक उपकरणों से आगे बढ़कर महत्वपूर्ण व्यावसायिक, सरकारी और सुरक्षा कार्यप्रवाहों में प्रवेश कर रही हैं। नीतिगत प्रश्न अब यह नहीं है कि AI का शासन होना चाहिए या नहीं, बल्कि यह है कि नवाचार या व्यावसायिक प्रतिस्पर्धात्मकता को कमजोर किए बिना इसका शासन कैसे किया जाए।
AI सेफ्टी फ्रेमवर्क किन समस्याओं का समाधान करना चाहता है
AI सेफ्टी फ्रेमवर्क एक व्यावहारिक समस्या का उत्तर है: सबसे उन्नत मॉडल अत्यधिक आर्थिक मूल्य उत्पन्न कर सकते हैं, लेकिन वे ऐसे जोखिम भी पैदा कर सकते हैं जिन्हें संभालने के लिए पारंपरिक सॉफ्टवेयर शासन नहीं बनाया गया था।
मुख्य चिंताओं में अप्रत्याशित फ्रंटियर मॉडल क्षमताएँ, साइबर ऑपरेशनों या धोखाधड़ी से जुड़ा दुरुपयोग, मॉडल प्रशिक्षण के बारे में सीमित पारदर्शिता, उच्च-प्रभाव वाले कार्यप्रवाहों में कमजोर जवाबदेही, और उन्नत AI में वैश्विक प्रतिस्पर्धा से जुड़े राष्ट्रीय सुरक्षा जोखिम शामिल हैं।
यह फ्रेमवर्क उद्योग को साक्ष्य के उच्चतर मानक की ओर प्रेरित करता है। कंपनियों के लिए केवल यह दावा करना पर्याप्त नहीं है कि कोई मॉडल सुरक्षित है। उन्हें दिखाना होगा कि उन्होंने सुरक्षा का मूल्यांकन कैसे किया, किन जोखिमों की पहचान हुई, कौन-से शमन उपाय जोड़े गए और रिलीज़ के बाद प्रणाली की निगरानी कैसे की जाएगी।
अमेरिकी दृष्टिकोण EU AI Act से कैसे अलग है
अमेरिकी फ्रेमवर्क को EU AI Act के साथ भ्रमित नहीं करना चाहिए। EU मॉडल स्पष्ट रूप से अधिकार-आधारित है, जिसमें मौलिक अधिकारों, जोखिम श्रेणियों और विभिन्न AI उपयोग मामलों में अनुपालन दायित्वों पर मजबूत ध्यान दिया गया है।
इसके विपरीत, अमेरिकी दृष्टिकोण राष्ट्रीय सुरक्षा, व्यावसायिक प्रतिस्पर्धात्मकता, फ्रंटियर मॉडल सुरक्षा और बिग टेक की जवाबदेही से अधिक निकटता से जुड़ा है। व्यापक अधिकार-प्रथम नियामक संरचना बनाने के बजाय, वॉशिंगटन उन शर्तों पर केंद्रित दिखाई देता है जिनके तहत शक्तिशाली AI कंपनियाँ उन्नत प्रणालियों का निर्माण, तैनाती और निर्यात जारी रख सकती हैं।
इसका OpenAI, Meta, Google, और Anthropic के लिए क्या अर्थ है
नया फ्रेमवर्क प्रत्येक प्रमुख AI कंपनी को अलग-अलग तरीके से प्रभावित करता है क्योंकि उनके व्यावसायिक मॉडल, वितरण चैनल और सुरक्षा दर्शन समान नहीं हैं।
| कंपनी | मुख्य जोखिम-सामना | रणनीतिक चुनौती |
|---|---|---|
| OpenAI | वाणिज्यिक फ्रंटियर मॉडल और एंटरप्राइज़ तैनाती | तेज़ उत्पाद विस्तार से पहले सुरक्षा सिद्ध करना |
| Meta | Llama जैसे ओपन-सोर्स और डाउनलोड किए जा सकने वाले मॉडल | सार्वजनिक रिलीज़ के बाद सुरक्षा नियंत्रण लागू करना |
| Search, Cloud, Workspace, Android और विज्ञापनों में AI | एक बड़े पारिस्थितिकी तंत्र में शासन का समन्वय | |
| Anthropic | सुरक्षा-केंद्रित फ्रंटियर मॉडल विकास | सुरक्षा-केंद्रित स्थिति को सत्यापनीय साक्ष्य में बदलना |
OpenAI को तैनाती की गति को लेकर सबसे प्रत्यक्ष दबाव का सामना करना पड़ सकता है। उसका व्यावसायिक मॉडल फ्रंटियर क्षमताओं को व्यापक रूप से अपनाए गए उत्पादों, API और एंटरप्राइज़ कार्यप्रवाहों में बदलने पर निर्भर करता है। AI सेफ्टी फ्रेमवर्क के तहत, तेज़ रिलीज़ के लिए अधिक मजबूत दस्तावेज़ीकरण, अधिक विश्वसनीय मॉडल मूल्यांकन और इस बात के स्पष्ट साक्ष्य की आवश्यकता होगी कि व्यावसायिक मांग सुरक्षा अनुशासन से आगे नहीं निकल रही है।
Meta के सामने एक अलग और संभावित रूप से अधिक कठिन दुविधा है। उसकी Llama रणनीति ने ओपन मॉडल को एक प्रमुख प्रतिस्पर्धात्मक लाभ बनाया है। फिर भी नियंत्रित पहुँच, पता लगाए जा सकने वाले परिनियोजन और निगरानी किए गए जोखिम शमन को प्राथमिकता देने वाला संघीय फ्रेमवर्क ओपन-सोर्स वितरण के साथ सहज नहीं बैठता। एक बार मॉडल डाउनलोड, फाइन-ट्यून और तृतीय पक्षों द्वारा संशोधित हो जाने पर, Meta का बाद के व्यवहार पर नियंत्रण कम हो जाता है। प्रश्न यह नहीं है कि ओपन मॉडल सुरक्षित हो सकते हैं या नहीं, बल्कि यह है कि विकेंद्रीकरण के बाद संघीय अपेक्षाओं के अनुरूप सुरक्षा प्रदर्शित की जा सकती है या नहीं।
Google की चुनौती पैमाना है। AI खोज, उत्पादकता सॉफ्टवेयर, क्लाउड अवसंरचना, विज्ञापन उपकरणों, मोबाइल प्रणालियों और डेवलपर उत्पादों में समाहित है। यह व्यापकता Google को अत्यधिक रणनीतिक शक्ति देती है, लेकिन अनुपालन की जटिलता भी कई गुना बढ़ाती है। किसी एक उत्पाद क्षेत्र में सुरक्षा विफलता पूरे पारिस्थितिकी तंत्र के लिए प्रतिष्ठा और नियामक समस्या बन सकती है।
Anthropic फ्रेमवर्क संबंधी चर्चा में अधिक मजबूत कथात्मक स्थिति से प्रवेश करता है क्योंकि सुरक्षा हमेशा उसके ब्रांड का केंद्र रही है। लेकिन Anthropic को भी एक ऊँची कसौटी का सामना करना होगा। केवल सुरक्षा-प्रथम संस्कृति अब अपने आप में पर्याप्त नहीं है। नीति-निर्माता दोहराए जा सकने वाली परीक्षण प्रक्रियाएँ, ऑडिट योग्य दस्तावेज़ीकरण और इस बात के स्पष्ट साक्ष्य चाहेंगे कि मॉडल क्षमताएँ बढ़ने पर शासन प्रथाएँ टिकाऊ बनी रहें।
फ्रेमवर्क AI व्यावसायिक मॉडल को क्यों बदलता है
AI सेफ्टी फ्रेमवर्क केवल कागजी काम नहीं बढ़ाता। यह बदलता है कि कंपनियों को गति, वितरण और विश्वास के बारे में कैसे सोचना चाहिए।
जनरेटिव AI प्रतिस्पर्धा के पिछले चरण में, बाज़ार ने त्वरित लॉन्च, मॉडल बेंचमार्क, डेवलपर अपनाने और उपयोगकर्ता वृद्धि को पुरस्कृत किया। अगले चरण में, ये लाभ अभी भी महत्वपूर्ण होंगे, लेकिन साक्ष्य-आधारित शासन के साथ रहेंगे। किसी फ्रंटियर मॉडल की रिलीज़ के लिए बढ़ते हुए सुरक्षा रिपोर्ट, रेड-टीम निष्कर्ष, जोखिम शमन, एस्केलेशन नीतियाँ और तैनाती-पश्चात निगरानी योजनाएँ आवश्यक हो सकती हैं।
यह बिग टेक AI विनियमन के लिए एक नई परिचालन वास्तविकता बनाता है। उत्पाद टीमों, नीति टीमों, कानूनी टीमों और सुरक्षा टीमों को विकास चक्र में पहले से मिलकर काम करना होगा। सुरक्षा को अब मॉडल प्रशिक्षण के अंत में की जाने वाली समीक्षा के रूप में नहीं देखा जा सकता। इसे स्वयं मॉडल रोडमैप का हिस्सा बनना होगा।
व्यावसायिक टीमों को आगे किन बातों पर नज़र रखनी चाहिए
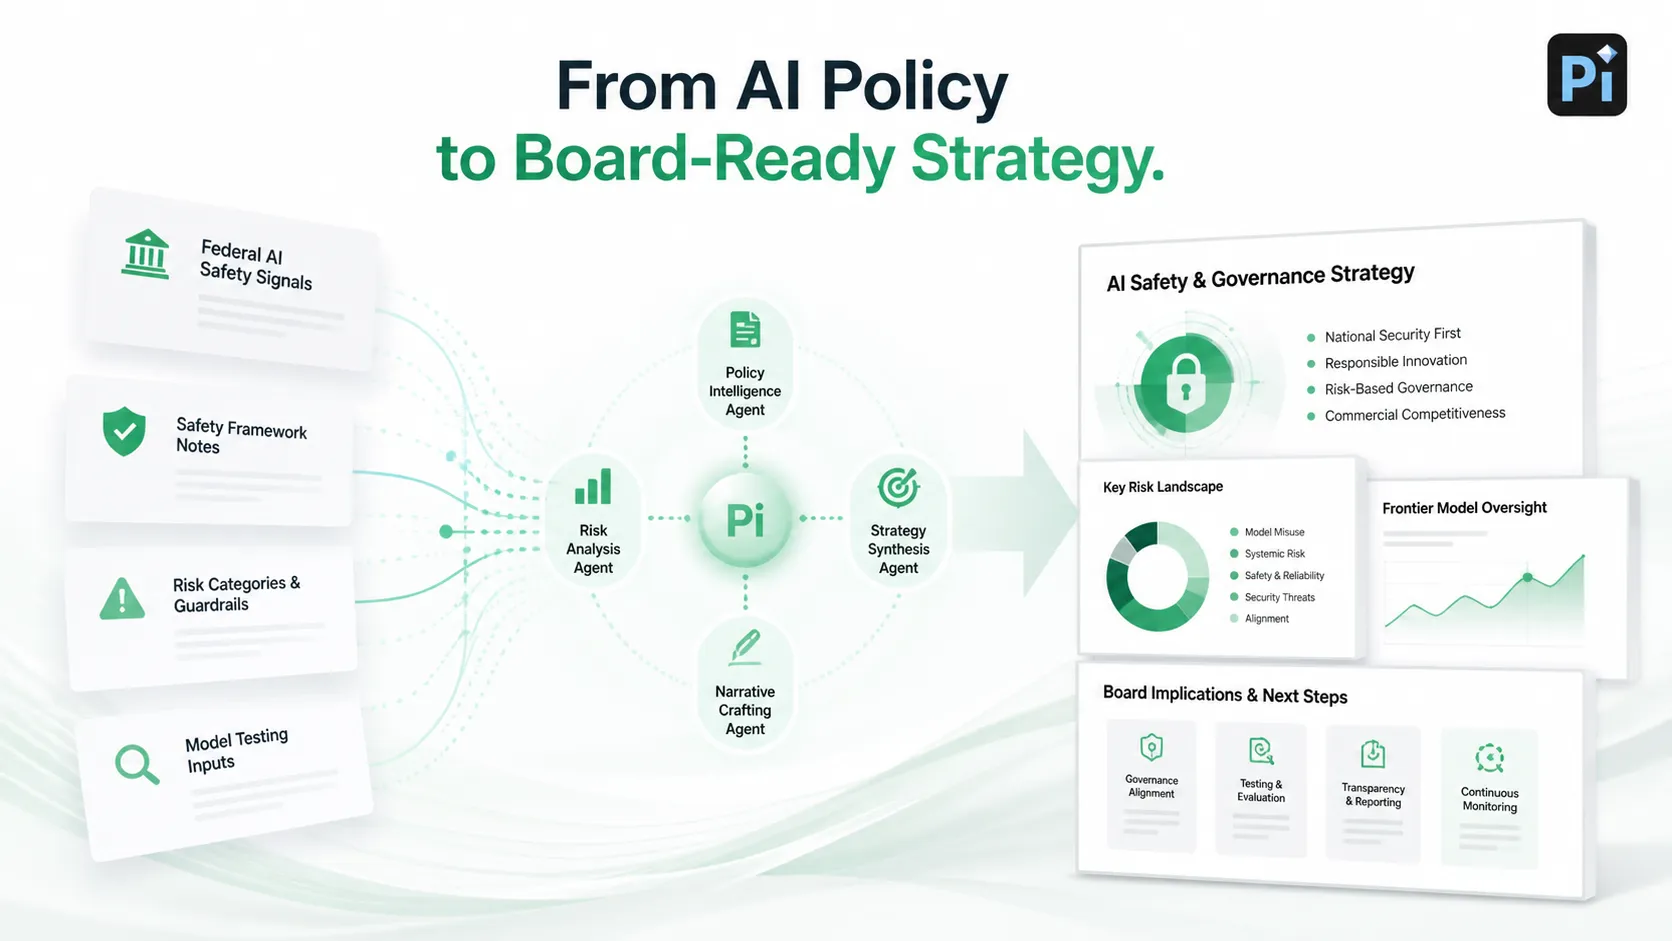
व्हाइट हाउस AI समिट केवल AI लैब्स के लिए प्रासंगिक नहीं है। यह उन एंटरप्राइज़ को भी प्रभावित करता है जो बोर्डों, ग्राहकों, निवेशकों और नियामकों के समक्ष AI खरीदते हैं, एकीकृत करते हैं या AI रणनीतियाँ प्रस्तुत करते हैं। जब संघीय अपेक्षाएँ बदलती हैं, तो कंपनियों को AI अपनाने की व्याख्या करने का तरीका भी बदलना होगा।
व्यावसायिक टीमों को तीन प्रश्नों के बारे में अधिक स्पष्ट आंतरिक विवरण चाहिए होगा: वे किन AI प्रणालियों का उपयोग करती हैं, वे प्रणालियाँ कौन-से जोखिम उत्पन्न करती हैं, और शासन कैसे संभाला जाता है। यह विशेष रूप से कार्यकारी प्रस्तुतियों, परामर्श रिपोर्टों, निवेशक अपडेट और उत्पाद लॉन्च डेक के लिए महत्वपूर्ण है, जहाँ AI क्षमता को निश्चितता को बढ़ा-चढ़ाकर बताए बिना समझाया जाना चाहिए।
इन उच्च-दांव वाली चर्चाओं को संभालने वाले संगठनों के लिए, नियामक जटिलता को संरचित पेशेवर संचार से जोड़ने वाले व्यावहारिक उपकरण तेजी से महत्वपूर्ण होते जा रहे हैं। चाहे नीतिगत बदलावों को बोर्ड-तैयार विवरणों में बदलना हो या प्रतिस्पर्धात्मक प्रभावों का संश्लेषण करना हो, Pi जैसे प्लेटफ़ॉर्म रणनीति टीमों के लिए मूल्यवान संसाधन के रूप में उभर रहे हैं, जो प्रतिक्रियात्मक रिपोर्टिंग से सक्रिय कार्यकारी कहानी-कथन की ओर बढ़ना चाहती हैं।
निष्कर्ष: AI सुरक्षा प्रतिस्पर्धात्मक आवश्यकता बन रही है
व्हाइट हाउस AI समिट और उसके साथ आया AI सेफ्टी फ्रेमवर्क AI उद्योग के लिए एक स्पष्ट मोड़ का प्रतिनिधित्व करते हैं। वे संकेत देते हैं कि संघीय निगरानी अब काल्पनिक नहीं रही। प्रमुख AI प्रयोगशालाओं के लिए, सुरक्षा आंतरिक इंजीनियरिंग प्राथमिकता से आगे बढ़कर एक मूल अनुपालन और शासन आवश्यकता बन गई है।
यह फ्रेमवर्क AI विकास को नहीं रोकेगा, लेकिन यह मॉडलों के निर्माण, परीक्षण, दस्तावेज़ीकरण और रिलीज़ के तरीके को पुनर्गठित करेगा। अंततः, इस नए वातावरण में वे कंपनियाँ सफल होंगी जिनके पास केवल सबसे शक्तिशाली मॉडल नहीं, बल्कि सबसे विश्वसनीय सुरक्षा विवरण होंगे।
इस बहस का अगला चरण इस बात पर केंद्रित होगा कि इन दावों का सत्यापन कैसे किया जाता है। यही कारण है कि NIST मानकों के माध्यम से फ्रंटियर मॉडल परीक्षणi नीति के उद्देश्य और वास्तविक दुनिया में AI तैनाती के बीच महत्वपूर्ण सेतु बनता जा रहा है।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
प्र: व्हाइट हाउस AI समिट में क्या घोषित किया गया था?
उ: व्हाइट हाउस AI समिट में एक नए AI सेफ्टी फ्रेमवर्क पर प्रकाश डाला गया, जो फ्रंटियर मॉडल सुरक्षा, राष्ट्रीय सुरक्षा, पारदर्शिता और अग्रणी AI कंपनियों की जवाबदेही पर केंद्रित है।
प्र: AI सेफ्टी फ्रेमवर्क क्या है?
उ: AI सेफ्टी फ्रेमवर्क एक अमेरिकी नीतिगत दृष्टिकोण है जिसका उद्देश्य शक्तिशाली AI प्रणालियों के शासन में सुधार करना है, विशेष रूप से सुरक्षा परीक्षण, दुरुपयोग की रोकथाम, दस्तावेज़ीकरण और जिम्मेदार तैनाती के माध्यम से।
प्र: फ्रेमवर्क OpenAI, Meta, Google और Anthropic को कैसे प्रभावित करता है?
उ: OpenAI पर त्वरित तैनाती से पहले सुरक्षा सिद्ध करने का दबाव है, Meta को ओपन-सोर्स नियंत्रण संबंधी चुनौतियों का समाधान करना होगा, Google को पूरे पारिस्थितिकी तंत्र में शासन की आवश्यकता है, और Anthropic को अपनी सुरक्षा-केंद्रित स्थिति को सत्यापनीय साक्ष्य में बदलना होगा।
प्र: फ्रंटियर मॉडल परीक्षण क्या है?
उ: फ्रंटियर मॉडल परीक्षण उन्नत AI प्रणालियों का तैनाती से पहले और बाद में क्षमता आकलन, दुरुपयोग परीक्षण, मजबूती जाँच, संरेखण मूल्यांकन और निरंतर जोखिम निगरानी के माध्यम से मूल्यांकन करने की प्रक्रिया है।


