Oltre gli LLM: cosa significa TypeSafe Jev per l'IA di Sistema Uno
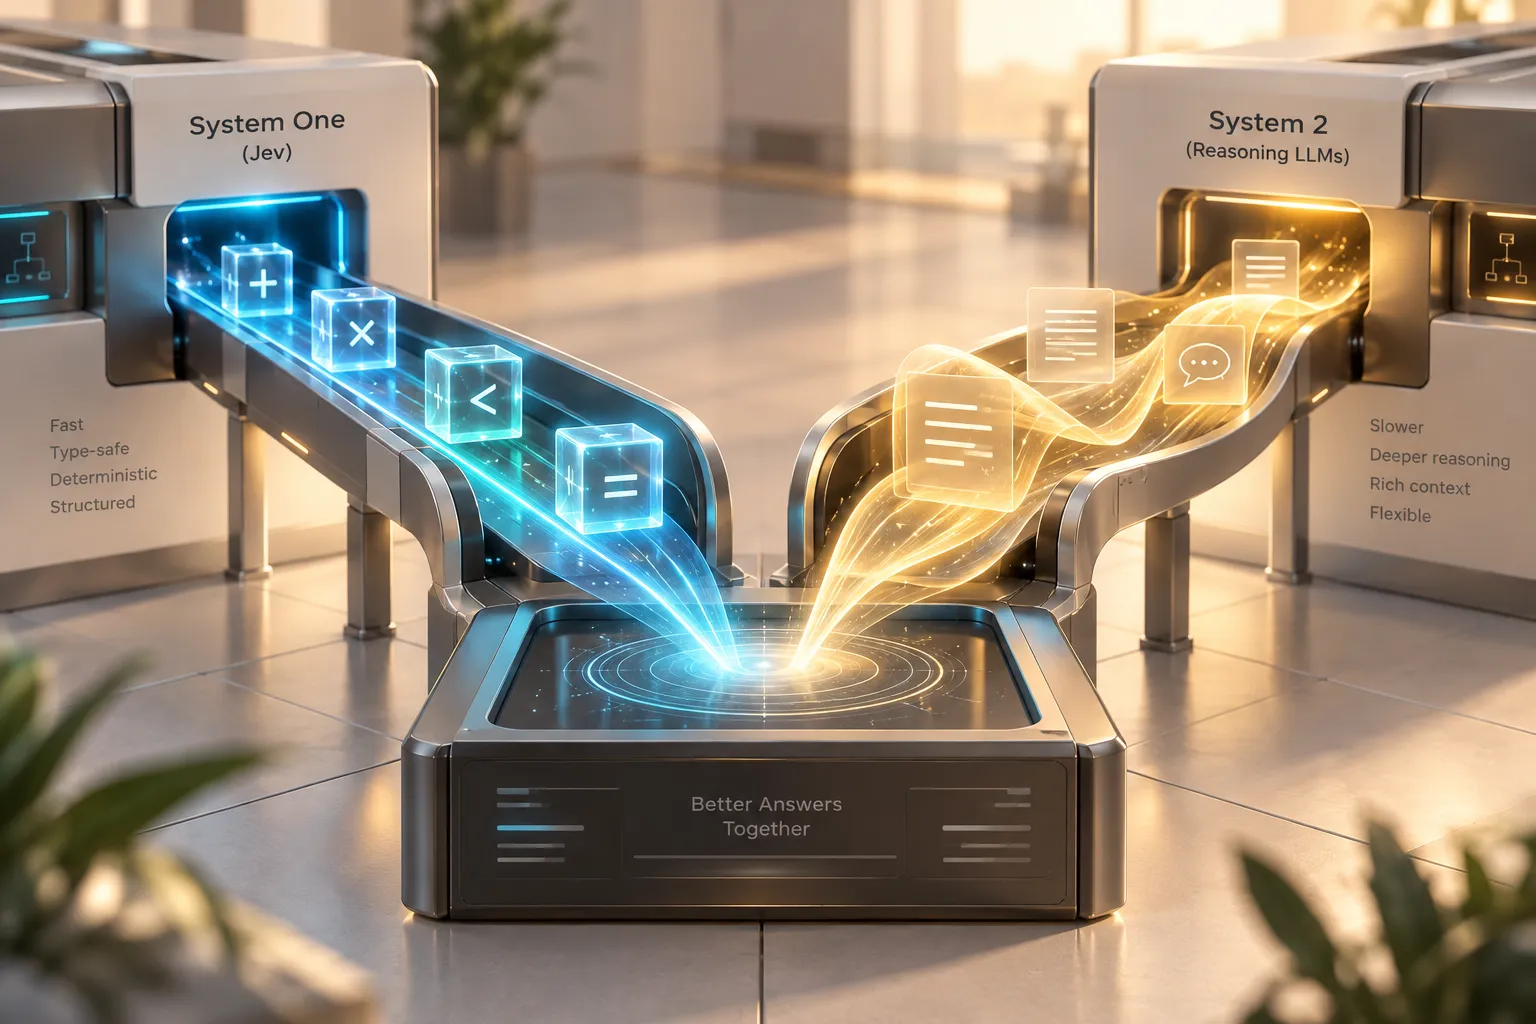
Nell'economia comportamentale, il premio Nobel Daniel Kahneman ha introdotto al mondo il Sistema 1 (decisioni rapide, istintive e parallele) e il Sistema 2 (ragionamento lento, deliberato e analitico).
Per anni, il boom dell'IA generativa si è concentrato sulla costruzione di enormi motori di Sistema 2: giganteschi LLM di ragionamento come Claude 3.5, GPT-4 e Gemini 1.5, che scrivono saggi, compongono codice e risolvono problemi complessi in più passaggi.
Tuttavia, lo sviluppo software affronta un collo di bottiglia silenzioso: la maggior parte delle operazioni nelle app moderne non richiede ragionamenti complessi né prosa in linguaggio naturale. Richiede decisioni ultrarapide e strutturate, come instradare un ticket, assegnare un punteggio di confidenza o rilevare spam. Usare un enorme LLM conversazionale per queste attività è come assumere un filosofo per azionare un interruttore: è lento, costoso e incline a rompere i parser JSON.
Ecco Jev, il modello Sistema Uno di punta rilasciato da TypeSafe AI.
Se sviluppi software con l'IA, ecco un'analisi completa di cosa sono i modelli Sistema Uno, come funziona Jev e perché questo cambiamento potrebbe ristrutturare radicalmente il modo in cui l'IA si integra nel tuo stack di produzione.
Che cos'è un modello Sistema Uno?
Un modello Sistema Uno è un modello di IA progettato specificamente per decisioni ad alta velocità, delimitate e tipizzate, anziché per la generazione di testo aperta.
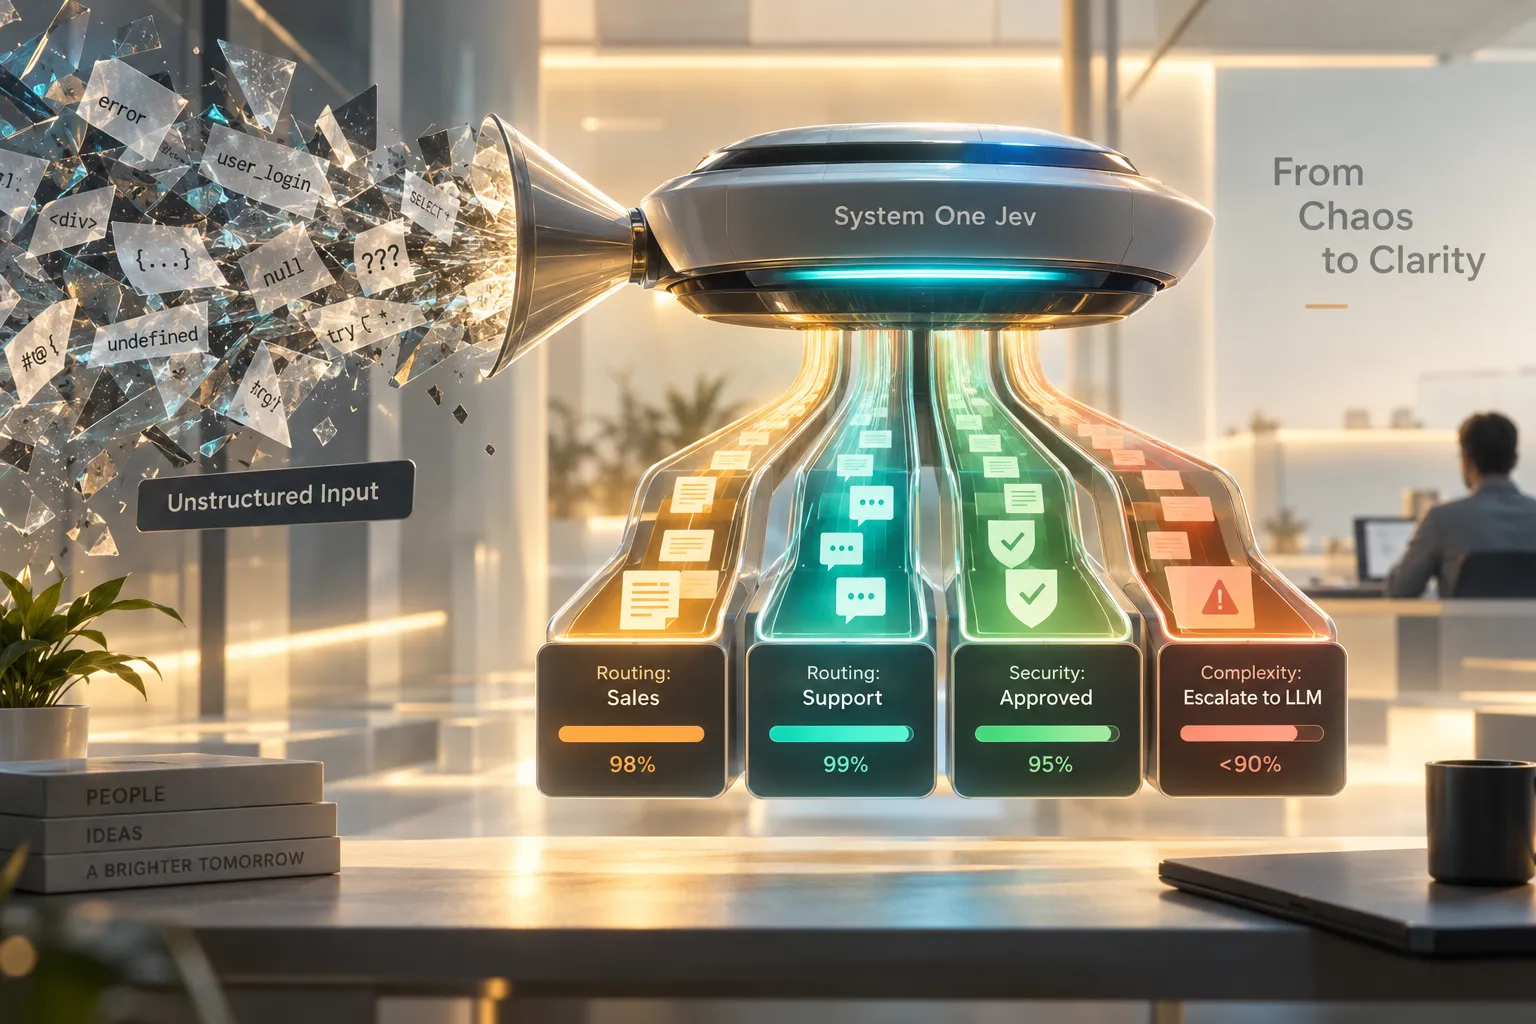
Invece di generare testo grezzo token per token, un modello Sistema Uno accetta uno stato di programma non strutturato (ad esempio log di testo, input utente o oggetti JSON) e valuta scelte definite in un singolo passaggio parallelo.
[Input / Stato non strutturato] ---> [ Modello Sistema Uno (Jev) ] ---> [ Decisione type-safe + Probabilità ]
Anziché produrre prosa, restituisce primitive type-safe come:
- Scelta: selezione categoriale da un insieme definito di opzioni (fino a 255 opzioni).
- Punteggio: valutazioni numeriche secondo metriche definite.
- Booleano (Noul): probabilità calibrate sì/no.
Cosa rende TypeSafe Jev diverso dagli LLM standard?
Per capire perché l'adozione di Jev da parte degli sviluppatori è aumentata rapidamente, considera come si confronta con gli LLM di frontiera standard come GPT-4o o Claude:
| Caratteristica | LLM standard per chat/ragionamento | Modelli Sistema Uno (Jev) |
| Tipo di output | Stringhe non strutturate (prosa, testo JSON) | Valori rigorosamente tipizzati (Scelta, Punteggio, Booleano) |
| Meccanismo di campionamento | Autoregressivo (token per token) | Singolo passaggio parallelo |
| Latenza | Da 1 a oltre 10 secondi | 70 ms – 500 ms |
| Punteggio di confidenza | Spesso eccessivamente sicuro o non calibrato | Probabilità calibrate per output |
| Errori di tipo / rottura dello schema | Rischio di output malformato/errori di parsing JSON | Tasso di errori di tipo dello 0% (per costruzione) |
| Caso d'uso principale | Generazione di contenuti, chat, ragionamento degli agenti | Instradamento dei ticket, rilevamento spam, controllo degli agenti |
Vantaggi principali dell'architettura Jev Sistema Uno
1. Zero allucinazioni ed errori di tipo
Poiché i modelli Sistema Uno non generano frasi in formato libero, eliminano gli errori di formattazione. Le applicazioni software non necessitano di complesse logiche di ripetizione o di parsing JSON difensivo: l'output segue rigorosamente lo schema dichiarato nel codice.
2. Confidenza calibrata integrata
Gli LLM tradizionali sono notoriamente inclini a fornire risposte errate con sicurezza. Jev viene addestrato con tecniche come Reinforcement Learning for Calibrated Decisions (RLCD), fornendo una probabilità matematica insieme a ogni decisione.
Ciò consente agli sviluppatori di creare logiche di controllo pulite:
- Confidenza > 95%: esegui automaticamente.
- Confidenza < 80%: inoltra alla revisione umana o passa a un modello Sistema 2 più potente (come Claude o GPT-4).
3. Efficienza di latenza e costi
Eliminando il sovraccarico della generazione di testo autoregressiva, i modelli Sistema Uno funzionano fino a 40x–100x più velocemente degli LLM conversazionali tradizionali. I costi dei token di input diminuiscono drasticamente, mentre il sovraccarico della generazione di output standard viene completamente eliminato.
Casi d'uso reali: dove il Sistema Uno si inserisce nella tua architettura
Jev e i modelli Sistema Uno non sono pensati per sostituire LLM come ChatGPT o Claude, ma sono progettati per operare davanti o accanto a essi come livello decisionale rapido e deterministico.
                     ┌────────────────────────┐
                     │ Richiesta utente in arrivo │
                     └───────────┬────────────┘
                                 │
                                 ▼
                     ┌────────────────────────┐
                     │  Sistema Uno (API Jev)  │
                     └───────────┬────────────┘
                                 │
          ┌──────────────────────┴──────────────────────┐
          │ Alta confidenza (>90%)                      │ Bassa confidenza (<90%)
          ▼                                             ▼
┌──────────────────┐                           ┌──────────────────┐
│ Instradamento    │                           │ Sistema 2 (LLM)  │
│ automatico o     │                           │ / Escalation     │
│ esecuzione tool  │                           │ umana            │
└──────────────────┘                           └──────────────────┘
Applicazioni principali:
- Instradamento di ticket di supporto e lead: categorizzazione istantanea dei ticket in arrivo (ad esempio {fatturazione, tecnico, vendite}) e valutazione dell'urgenza senza analizzare risposte testuali disordinate.
- Autorizzazione degli strumenti degli agenti IA: decisione se una chiamata a uno strumento debba essere approvata automaticamente in base alle regole di sicurezza, eliminando i ritardi nei cicli autonomi.
- Pipeline RAG a cascata: valutazione della rilevanza del contesto dei documenti vettoriali recuperati prima di inviarlo a un costoso modello generativo.
- Moderazione e guardrail: scansione delle richieste degli utenti in arrivo o degli output dei modelli alla ricerca di violazioni delle policy in meno di 100 ms.
Limitazioni: cosa NON può fare Jev
Per sviluppare efficacemente con i modelli Sistema Uno, è essenziale comprenderne i limiti:
- Nessuna generazione di testo libero: Jev non può redigere email, scrivere codice, riassumere documenti lunghi in prosa o conversare.
- Nessuna conoscenza interna del mondo: Jev si basa interamente sullo stato che gli viene passato; non può navigare sul web né eseguire autonomamente complesse ricerche di conoscenza interna.
- Richiede uno schema predefinito: devi conoscere l'esatto insieme delimitato di scelte o criteri di valutazione prima di effettuare la chiamata API.
Il verdetto: l'architettura a doppio modello è arrivata
Il lancio di Jev di TypeSafe segna un cambiamento chiave nell'ingegneria dell'IA. L'era dell'utilizzo di un unico LLM enorme e costoso per ogni passaggio di un'applicazione sta svanendo.
Le applicazioni di livello produttivo si stanno invece orientando verso un'architettura ibrida:
- Sistema Uno (Jev): gestisce classificazione rapida ad alto volume, selezione degli strumenti, instradamento e filtraggio con bassa latenza.
- Sistema 2 (GPT/Claude/Gemini): subentra per la generazione di testi lunghi, ragionamenti complessi e analisi aperte.
Delegando le micro-decisioni ai modelli Sistema Uno, gli sviluppatori possono creare sistemi di IA più veloci, drasticamente più economici e matematicamente affidabili.
Mentre le architetture backend si orientano verso modelli a bassa latenza come Jev per ottimizzare i dati, anche la presentazione e la reportistica frontend non dovrebbero essere un collo di bottiglia. Scopri come Presentation Intelligence (PI) aiuta i team a creare, strutturare e automatizzare istantaneamente pitch deck e report ad alto impatto.