ホワイトハウスAIサミット:新たな安全性フレームワークを解説
8月4日、ホワイトハウスAIサミットは、人工知能に対する米国連邦政府のアプローチを再び世界の政策論争の中心に据えた。注目すべき点は、ワシントンが単に監督強化を望んでいるということではない。新たなAI安全性フレームワークは、最も強力なAIシステムが国家安全保障、透明性、公共に対する説明責任へのより高い期待を満たしながら、どのように規模拡大を継続できるかを定義するために設計されているように見えることだ。
OpenAI、Meta、Google、そしてAnthropicにとって、メッセージは明確だ。フロンティアAIは、もはや製品競争だけではない。ガバナンス競争になりつつある。最も高性能なモデルを構築する企業は、大規模展開に至る前に、それらのモデルをどのようにテスト、監視、文書化、管理するかをますます証明する必要がある。
8月4日のホワイトハウスAIサミットで何が起きたのか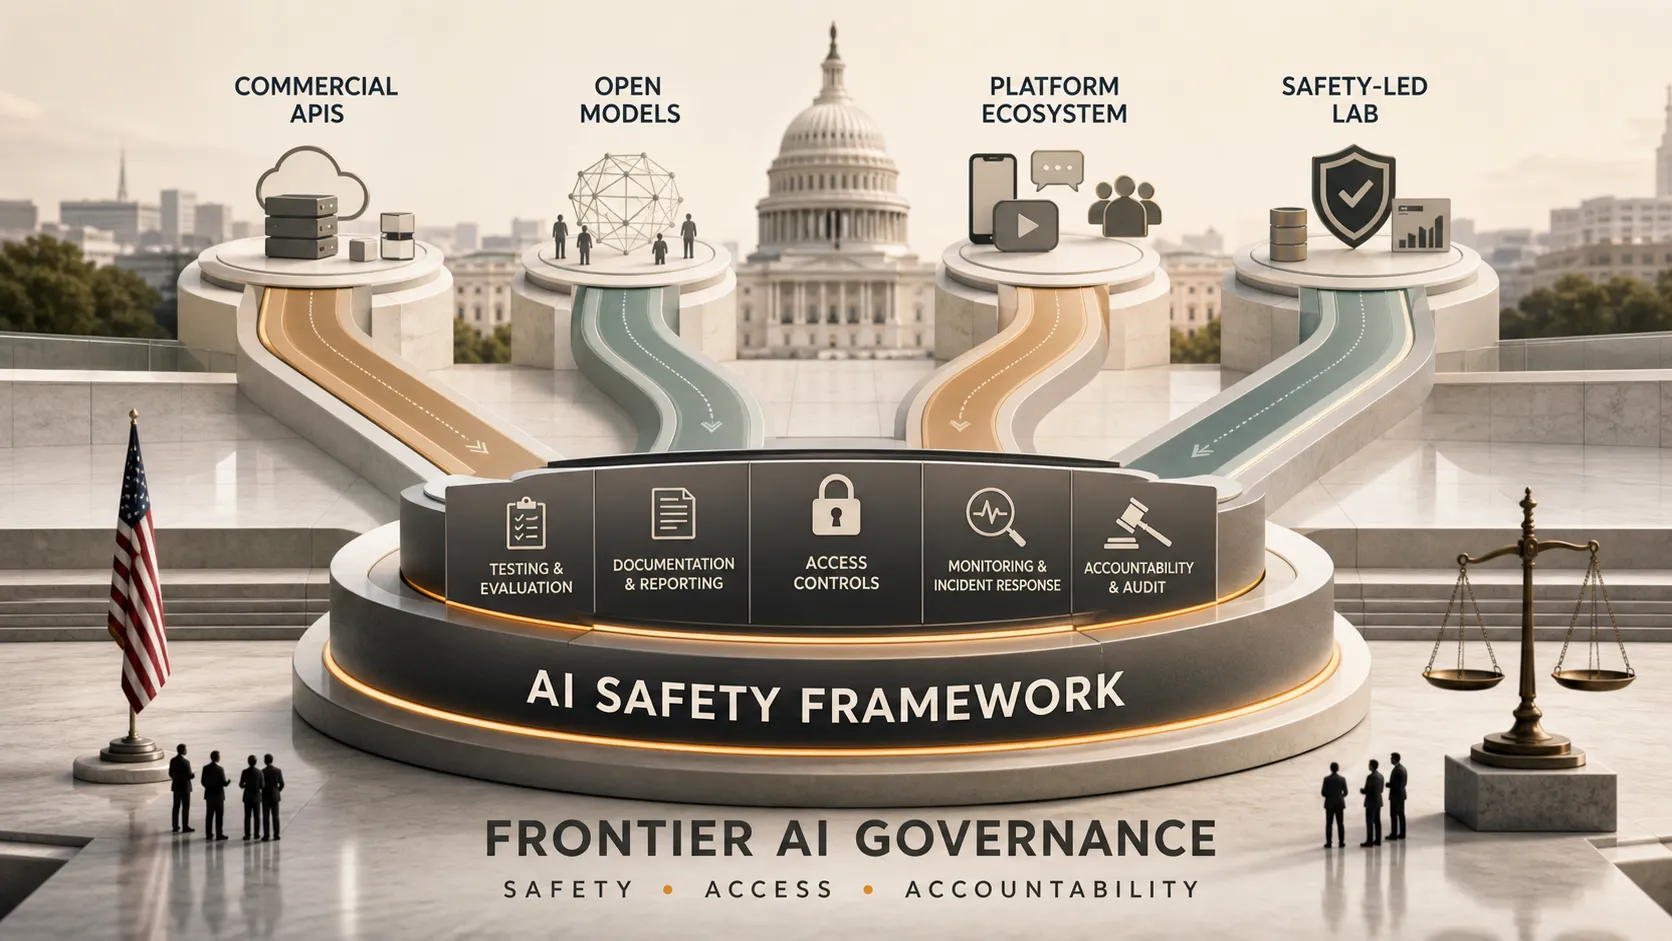
8月4日のAIサミットでは、AI安全性、業界の責任、米国の競争優位性に関する連邦政府の優先事項が一堂に会した。ホワイトハウスはAI規制を単一のルールブックとして扱うのではなく、安全性をフロンティアモデル開発のための戦略的な運用レイヤーとして位置付けた。
AI安全性フレームワークは、政策シグナルとして理解するのが最も適切だ。主要AI企業には、モデルの能力が向上し広く展開されるにつれて、より強固な安全対策を示すことが期待される。これは、すべての原則が直ちに法的拘束力を持つことを意味するわけではない。しかし、自主的なコミットメント、連邦ガイダンス、調達上の期待、規制基準が収束し始めていることを示唆している。
これは、AIシステムが実験的なツールから、重要なビジネス、政府、安全保障のワークフローへと移行しているため重要だ。政策上の問いは、もはやAIを統治すべきかどうかではなく、イノベーションや商業的競争力を損なわずにどのように統治するかである。
AI安全性フレームワークが解決しようとしていること
AI安全性フレームワークは実務的な問題に対応している。最先端のモデルは莫大な経済的価値を生み出せる一方で、従来のソフトウェアガバナンスでは管理できるように設計されていないリスクも生み出し得る。
主な懸念には、予測不可能なフロンティアモデルの能力、サイバー作戦や詐欺に関わる悪用、モデル学習に関する透明性の不足、高影響度のワークフローにおける弱い説明責任、そして高度AIをめぐる世界的競争に結び付いた国家安全保障上のリスクが含まれる。
このフレームワークは業界に対し、より高い基準の根拠を求めている。企業がモデルは安全だと主張するだけでは不十分だ。安全性をどのように評価したか、どのリスクを特定したか、どの緩和策を追加したか、そしてリリース後にシステムをどのように監視するかを示さなければならない。
米国のアプローチはEU AI法とどう異なるのか
米国のフレームワークをEU AI法と混同してはならない。EUのモデルは明確に権利基盤型であり、基本的権利、リスク分類、さまざまなAIユースケースにまたがるコンプライアンス義務に強く焦点を当てている。
対照的に米国のアプローチは、国家安全保障、商業的競争力、フロンティアモデルの安全性、Big Techの説明責任とより密接に結び付いている。広範な権利優先の規制アーキテクチャを構築するのではなく、ワシントンは強力なAI企業が高度なシステムを構築、展開、輸出し続けられる条件に焦点を当てているように見える。
これはOpenAI、Meta、Google、Anthropiにとって何を意味するのか
新たなフレームワークは、各社のビジネスモデル、流通チャネル、安全性に関する考え方が同じではないため、主要AI企業それぞれに異なる影響を与える。
| 企業 | 主な影響領域 | 戦略的課題 |
|---|---|---|
| OpenAI | 商用フロンティアモデルとエンタープライズ展開 | 急速な製品拡大の前に安全性を証明すること |
| Meta | Llamaのようなオープンソースおよびダウンロード可能なモデル | 公開後に安全管理を適用すること |
| Search、Cloud、Workspace、Android、広告にまたがるAI | 大規模なエコシステム全体でガバナンスを調整すること | |
| Anthropic | 安全性主導のフロンティアモデル開発 | 安全性を重視する立場を検証可能な根拠へと変えること |
OpenAIは、展開のペースに関して最も直接的な圧力に直面する可能性がある。同社の商業モデルは、フロンティア能力を広く採用される製品、API、エンタープライズのワークフローに転換することに依存している。AI安全性フレームワークの下では、より速いリリースには、より強力な文書化、より説得力のあるモデル評価、そして商業需要が安全性の規律を上回っていないことを示す、より明確な根拠が必要になる。
Metaは異なる、そして潜在的にはより難しいジレンマに直面している。同社のLlama戦略は、オープンモデルを大きな競争優位にしてきた。しかし、管理されたアクセス、追跡可能な展開、監視されたリスク軽減を重視する連邦フレームワークは、オープンソース配布とは相性が悪い。モデルが第三者によってダウンロード、ファインチューニング、改変されると、Metaの下流での挙動に対する管理は弱まる。問題はオープンモデルが安全になり得るかどうかではなく、分散化後にも連邦政府の期待に沿って安全性を実証できるかどうかだ。
Googleの課題は規模だ。AIは検索、生産性ソフトウェア、クラウドインフラ、広告ツール、モバイルシステム、開発者向け製品に組み込まれている。この広がりはGoogleに大きな戦略的力を与える一方で、コンプライアンスの複雑さも増幅する。ある製品領域での安全性の失敗が、エコシステム全体の評判および規制上の問題になり得る。
Anthropicは、安全性が常に同社ブランドの中心であったため、フレームワークをめぐる議論においてより有利な立場から入る。しかし、Anthropicでさえより高い基準に直面する。安全性優先の文化だけでは、もはや十分ではない。政策立案者は、再現可能なテストプロセス、監査可能な文書化、モデル能力の向上に伴ってもガバナンス慣行が機能することを示す明確な根拠を求めるだろう。
なぜこのフレームワークはAIのビジネスモデルを変えるのか
AI安全性フレームワークは、単に事務作業を増やすものではない。企業がスピード、流通、信頼について考える方法を変える。
生成AI競争の前段階では、市場は迅速なローンチ、モデルベンチマーク、開発者の採用、ユーザー成長を評価した。次の段階でもそれらの優位性は重要だが、根拠に基づくガバナンスと並存することになる。フロンティアモデルのリリースには、安全性レポート、レッドチームの調査結果、リスク緩和策、エスカレーション方針、展開後の監視計画がますます必要になる可能性がある。
これはBig TechのAI規制にとって新たな運用現実を生み出す。製品チーム、政策チーム、法務チーム、セキュリティチームは、開発サイクルのより早い段階から連携する必要がある。安全性をモデル学習の最後に行うレビューとして扱うことは、もはやできない。モデルのロードマップそのものの一部にしなければならない。
ビジネスチームが次に注視すべきこと
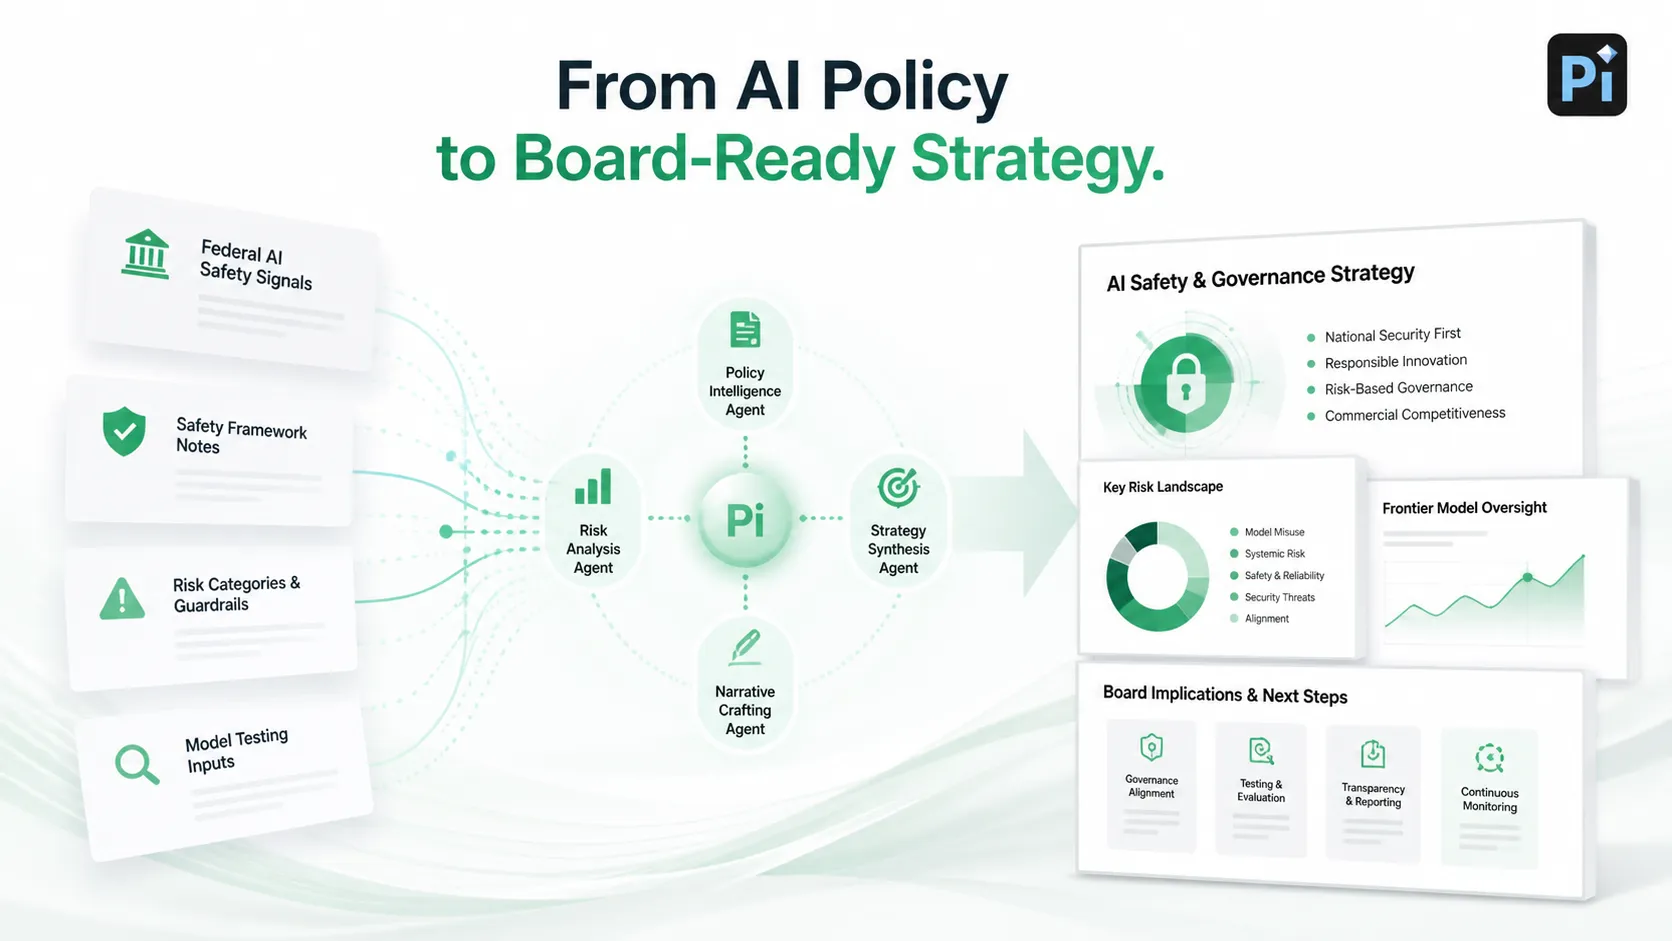
ホワイトハウスAIサミットはAIラボだけに関係するものではない。取締役会、顧客、投資家、規制当局に対してAI戦略を購入、統合、提示する企業にも影響を与える。連邦政府の期待が変わると、企業がAI導入を説明する方法も変わらなければならない。
ビジネスチームは、使用しているAIシステム、それらのシステムが生み出すリスク、ガバナンスをどのように扱っているかという3つの問いについて、より明確な社内向けの説明を必要とする。これは、確実性を過大に主張せずにAIの能力を説明しなければならない経営陣向けプレゼンテーション、コンサルティングレポート、投資家向け更新資料、製品ローンチ資料において特に重要だ。
こうした重大な議論を進める組織にとって、規制の複雑さと構造化されたプロフェッショナルなコミュニケーションをつなぐ実用的なツールは、ますます重要になっている。政策変更を取締役会向けの説明に翻訳する場合でも、競争上の影響を統合する場合でも、Piのようなプラットフォームは、受動的な報告から積極的な経営層向けストーリーテリングへ移行しようとする戦略チームにとって、価値ある資産として台頭している。
結論:AI安全性は競争要件になりつつある
ホワイトハウスAIサミットとそれに伴うAI安全性フレームワークは、AI業界にとって明確な転換点を表している。これらは、連邦政府による監督がもはや仮説ではないことを示している。主要AIラボにとって、安全性は社内のエンジニアリング上の優先事項から、中核的なコンプライアンスおよびガバナンス要件へと移行した。
このフレームワークはAI開発を停止させるものではないが、モデルの構築、テスト、文書化、リリースの方法を再構築する。最終的に、この新たな環境で成功する企業は、単に最も強力なモデルを持つ企業ではなく、最も信頼性の高い安全性に関する説明を持つ企業となる。
この議論の次の段階は、それらの主張をどのように検証するかに焦点を当てる。そのため、 NIST基準によるフロンティアモデルのテストiが、政策上の意図と現実世界におけるAI展開をつなぐ重要な橋渡しとなりつつある。
よくある質問(FAQ)
Q: ホワイトハウスAIサミットでは何が発表されましたか?
A: ホワイトハウスAIサミットでは、フロンティアモデルの安全性、国家安全保障、透明性、主要AI企業の説明責任に焦点を当てた新たなAI安全性フレームワークが強調されました。
Q: AI安全性フレームワークとは何ですか?
A: AI安全性フレームワークは、特に安全性テスト、悪用防止、文書化、責任ある展開を通じて、強力なAIシステムをめぐるガバナンスの改善を目指す米国の政策アプローチです。
Q: このフレームワークはOpenAI、Meta、Google、Anthropicにどのような影響を与えますか?
A: OpenAIは迅速な展開前に安全性を証明する圧力に直面し、Metaはオープンソースの管理上の課題に対処する必要があり、Googleにはエコシステム全体のガバナンスが求められ、Anthropicは安全性を重視する立場を検証可能な根拠に変える必要があります。
Q: フロンティアモデルのテストとは何ですか?
A: フロンティアモデルのテストとは、能力評価、悪用テスト、堅牢性チェック、アラインメント評価、継続的なリスク監視を通じて、高度なAIシステムを展開前および展開後に評価するプロセスです。


