Para além dos LLMs: o que TypeSafe Jev significa para a IA do Sistema Um
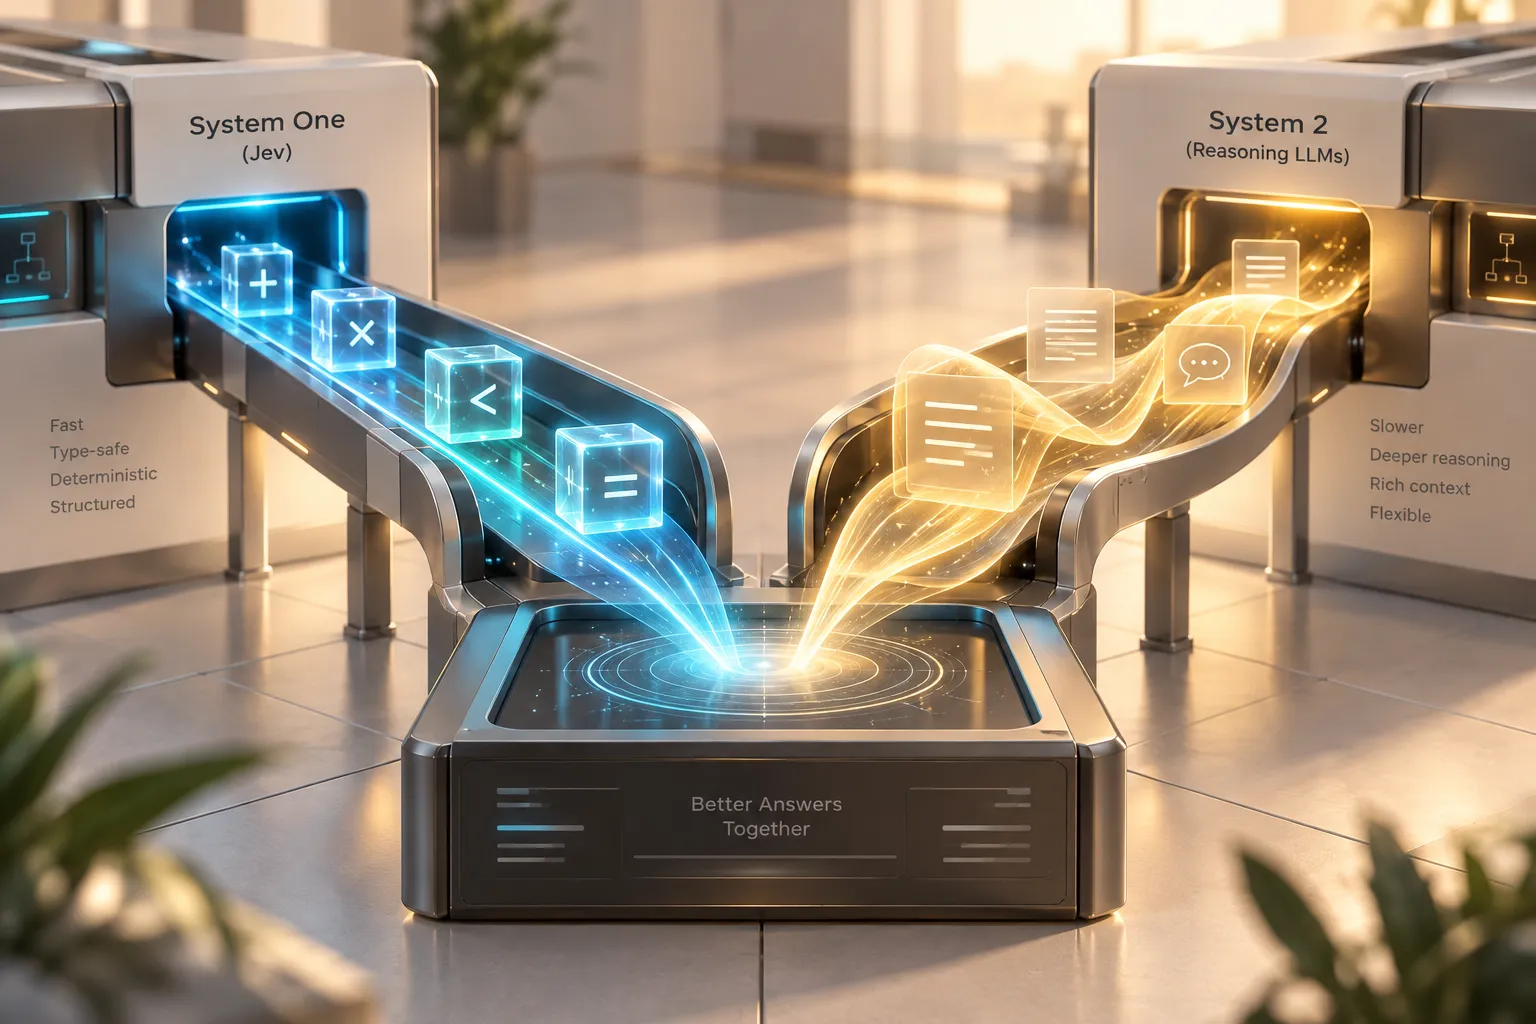
Na economia comportamental, o laureado com o Prémio Nobel Daniel Kahneman apresentou ao mundo o Sistema 1 (decisões rápidas, instintivas e paralelas) e o Sistema 2 (raciocínio lento, deliberado e analítico).
Durante anos, o boom da IA generativa tem estado obcecado em construir enormes motores do Sistema 2: LLMs gigantes de raciocínio como Claude 3.5, GPT-4 e Gemini 1.5, que escrevem ensaios, compõem código e resolvem problemas complexos de várias etapas.
No entanto, o desenvolvimento de software enfrenta um estrangulamento silencioso: a maioria das operações dentro das aplicações modernas não exige raciocínio complexo nem prosa em linguagem natural. Exigem decisões ultrarrápidas e estruturadas — como encaminhar um ticket, atribuir uma pontuação de confiança ou detetar spam. Utilizar um LLM de chat gigante para estas tarefas é como contratar um filósofo para acender um interruptor: é lento, caro e propenso a quebrar analisadores JSON.
Apresentamos o Jev, o principal Modelo do Sistema Um lançado pela TypeSafe AI.
Se desenvolve software com IA, aqui está uma análise completa do que são os modelos do Sistema Um, como o Jev funciona e porque esta mudança poderá reestruturar fundamentalmente a forma como a IA se integra na sua infraestrutura de produção.
O que é um Modelo do Sistema Um?
Um Modelo do Sistema Um é um modelo de IA concebido especificamente para tomada de decisões de alta velocidade, delimitada e tipada, em vez de geração de texto aberta.
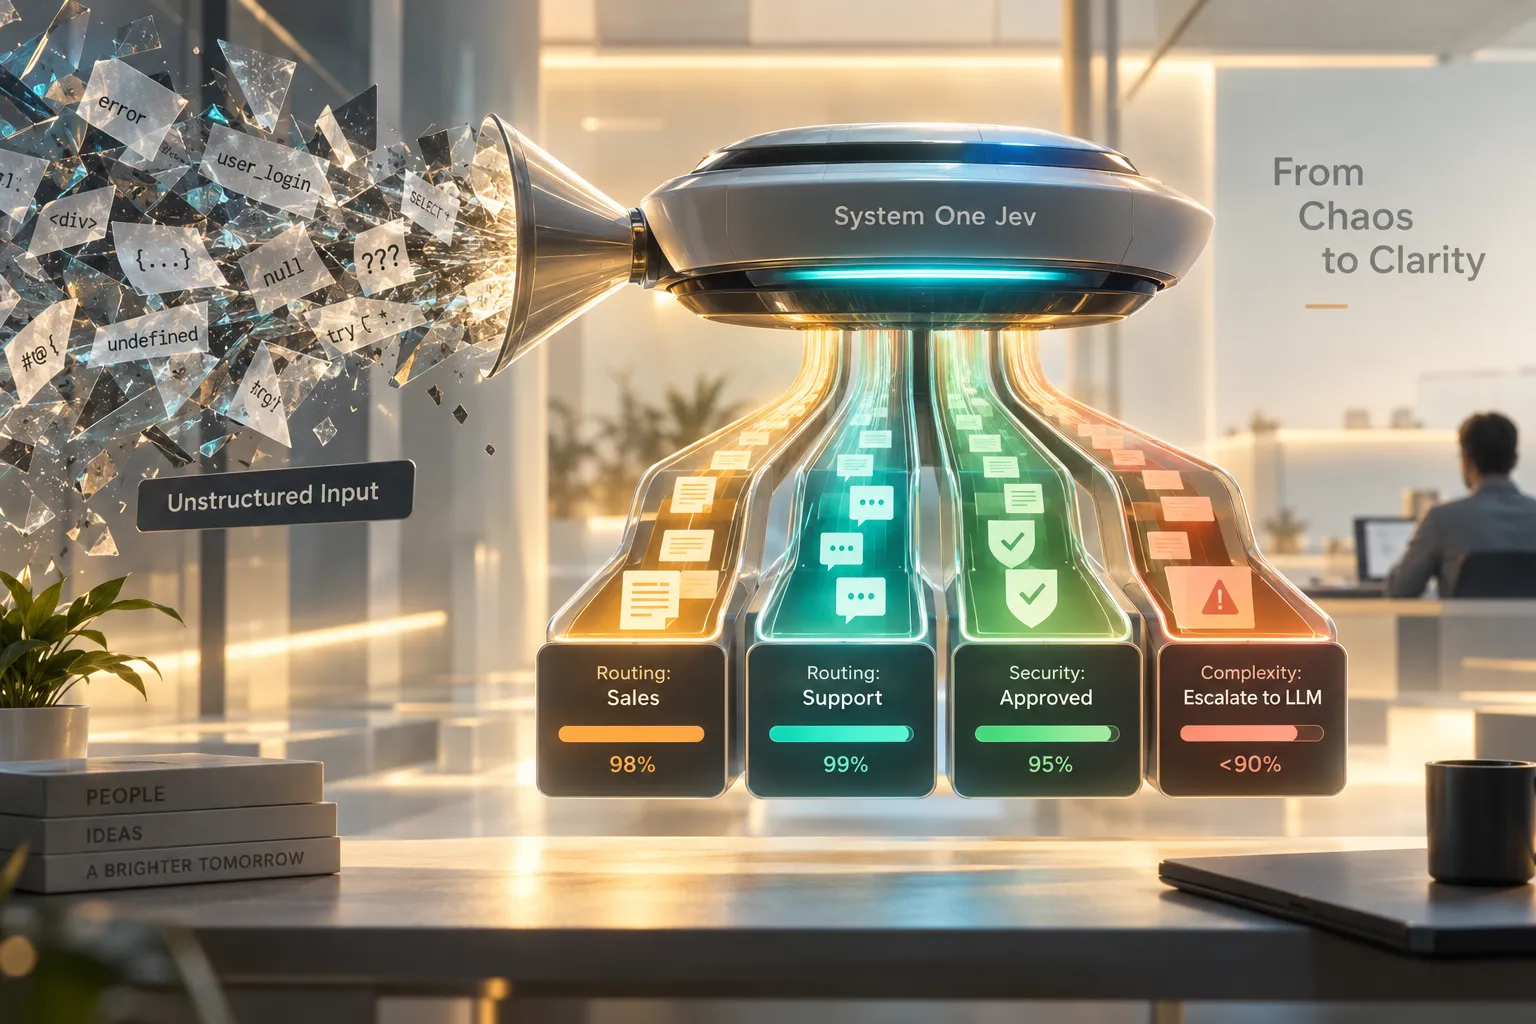
Em vez de gerar texto bruto token a token, um modelo do Sistema Um aceita o estado não estruturado do programa (por exemplo, registos de texto, entrada do utilizador ou objetos JSON) e avalia escolhas definidas numa única passagem paralela.
[Entrada / Estado não estruturado] ---> [ Modelo do Sistema Um (Jev) ] ---> [ Decisão type-safe + Probabilidade ]
Em vez de produzir prosa, devolve primitivas type-safe como:
- Escolha: Seleção categórica a partir de um conjunto definido de opções (até 255 opções).
- Pontuação: Classificações numéricas segundo métricas definidas.
- Booleano (Noul): Probabilidades calibradas de sim/não.
O que torna o TypeSafe Jev diferente dos LLMs padrão?
Para compreender porque a adoção do Jev pelos programadores aumentou tanto, considere como se compara com LLMs de ponta padrão, como GPT-4o ou Claude:
| Funcionalidade | LLMs padrão de chat/raciocínio | Modelos do Sistema Um (Jev) |
| Tipo de saída | Strings não estruturadas (prosa, texto JSON) | Valores estritamente tipados (Escolha, Pontuação, Booleano) |
| Mecanismo de amostragem | Autorregressivo (token a token) | Uma única passagem paralela |
| Latência | 1 a mais de 10 segundos | 70 ms – 500 ms |
| Pontuação de confiança | Frequentemente excessivamente confiante ou não calibrada | Probabilidades calibradas por saída |
| Erros de tipo / quebra de esquema | Risco de saída malformada/falhas na análise de JSON | Taxa de erros de tipo de 0% (por construção) |
| Principal caso de utilização | Geração de conteúdos, conversação, raciocínio de agentes | Encaminhamento de tickets, deteção de spam, controlo de agentes |
Principais vantagens da arquitetura Jev do Sistema Um
1. Zero alucinações e erros de tipo
Como os modelos do Sistema Um não geram frases livres, eliminam erros de formatação. As aplicações de software não necessitam de lógica complexa de repetição nem de análise defensiva de JSON — a saída segue estritamente o esquema declarado no código.
2. Confiança calibrada integrada
Os LLMs tradicionais são conhecidos por darem respostas erradas com confiança. O Jev é treinado com técnicas como Aprendizagem por Reforço para Decisões Calibradas (RLCD), fornecendo uma probabilidade matemática juntamente com cada decisão.
Isto permite aos programadores criar portas lógicas claras:
- Confiança > 95%: Executar automaticamente.
- Confiança < 80%: Encaminhar para revisão humana ou escalar para um modelo mais robusto do Sistema 2 (como Claude ou GPT-4).
3. Eficiência de latência e custos
Ao eliminar a sobrecarga da geração de texto autorregressiva, os modelos do Sistema Um funcionam até 40x–100x mais depressa do que os LLMs de chat tradicionais. Os custos dos tokens de entrada diminuem drasticamente, enquanto a sobrecarga padrão da geração de saída é totalmente eliminada.
Casos de utilização no mundo real: onde o Sistema Um se enquadra na sua arquitetura
O Jev e os modelos do Sistema Um não se destinam a substituir LLMs como ChatGPT ou Claude — foram concebidos para ficar à frente deles ou ao seu lado como uma camada de decisão rápida e determinística.
                     ┌────────────────────────┐
                     │ Pedido de utilizador recebido │
                     └───────────┬────────────┘
                                 │
                                 ▼
                     ┌────────────────────────┐
                     │  Sistema Um (API Jev)  │
                     └───────────┬────────────┘
                                 │
          ┌──────────────────────┴──────────────────────┐
          │ Confiança elevada (>90%)                    │ Confiança baixa (<90%)
          ▼                                             ▼
┌──────────────────┐                           ┌──────────────────┐
│ Rota automatizada│                           │ Sistema 2 (LLM)  │
│ ou execução de   │                           │ / Escalada humana│
│ ferramenta       │                           │                  │
└──────────────────┘                           └──────────────────┘
Principais aplicações:
- Encaminhamento de tickets de suporte e leads: Categorização instantânea dos tickets recebidos (por exemplo, {faturação, técnico, vendas}) e avaliação da urgência sem analisar respostas de texto desorganizadas.
- Autorização de ferramentas para agentes de IA: Decidir se uma chamada de ferramenta deve ser aprovada automaticamente com base em regras de segurança, eliminando atrasos em ciclos autónomos.
- Pipelines RAG em cascata: Avaliar se o contexto de documentos vetoriais recuperados é relevante antes de o enviar para um modelo generativo dispendioso.
- Moderação e barreiras de proteção: Analisar pedidos recebidos dos utilizadores ou saídas de modelos para detetar violações de políticas em menos de 100 ms.
Limitações: o que o Jev NÃO consegue fazer
Para desenvolver eficazmente com modelos do Sistema Um, é essencial compreender os seus limites:
- Sem geração de texto livre: o Jev não consegue redigir e-mails, escrever código, resumir documentos longos em prosa nem conversar.
- Sem conhecimento interno do mundo: o Jev depende inteiramente do estado que lhe é transmitido; não consegue navegar na Web nem realizar sozinho uma recuperação complexa de conhecimento interno.
- Requer um esquema predefinido: tem de conhecer o conjunto exato e delimitado de escolhas ou critérios de pontuação antes de fazer a chamada à API.
O veredito: a arquitetura de modelo duplo chegou
O lançamento do Jev da TypeSafe assinala uma mudança fundamental na engenharia de IA. A era de utilizar um único LLM enorme e dispendioso para cada etapa de uma aplicação está a desaparecer.
Em vez disso, as aplicações de nível de produção estão a avançar para uma arquitetura híbrida:
- Sistema Um (Jev): Lida com classificação rápida e de grande volume, seleção de ferramentas, encaminhamento e filtragem com baixa latência.
- Sistema 2 (GPT/Claude/Gemini): Assume a geração de textos longos, o raciocínio complexo e a análise aberta.
Ao delegar microdecisões nos modelos do Sistema Um, os programadores podem criar sistemas de IA mais rápidos, drasticamente mais baratos e matematicamente fiáveis.
Enquanto as arquiteturas de backend avançam para modelos de baixa latência como o Jev para simplificar os dados, a apresentação e os relatórios no frontend também não devem ser um estrangulamento. Descubra como a Inteligência de Apresentação (PI) ajuda as equipas a criar, estruturar e automatizar instantaneamente apresentações comerciais e relatórios de elevado impacto.


