การประชุมสุดยอด AI ทำเนียบขาว: อธิบายกรอบความปลอดภัยใหม่
เมื่อวันที่ 4 สิงหาคม การประชุมสุดยอด AI ของทำเนียบขาวได้นำแนวทางของรัฐบาลกลางสหรัฐต่อปัญญาประดิษฐ์กลับมาอยู่ใจกลางการถกเถียงเชิงนโยบายระดับโลกอีกครั้ง ประเด็นสำคัญไม่ใช่เพียงว่าวอชิงตันต้องการการกำกับดูแลที่มากขึ้น แต่คือกรอบความปลอดภัย AIฉบับใหม่ดูเหมือนออกแบบมาเพื่อกำหนดวิธีที่ระบบ AI อันทรงพลังที่สุดจะขยายขีดความสามารถต่อไปได้ พร้อมตอบสนองความคาดหวังที่สูงขึ้นด้านความมั่นคงแห่งชาติ ความโปร่งใส และความรับผิดชอบต่อสาธารณะ
สำหรับ OpenAI, Meta, Google และ Anthropic ข้อความชัดเจนว่า AI ระดับแนวหน้าไม่ได้เป็นเพียงการแข่งขันด้านผลิตภัณฑ์อีกต่อไป แต่กำลังกลายเป็นการแข่งขันด้านธรรมาภิบาล บริษัทที่สร้างโมเดลที่มีความสามารถสูงที่สุดจะต้องพิสูจน์มากขึ้นเรื่อย ๆ ว่าโมเดลเหล่านั้นได้รับการทดสอบ เฝ้าติดตาม จัดทำเอกสาร และควบคุมอย่างไร ก่อนนำไปใช้งานในวงกว้าง
เกิดอะไรขึ้นในการประชุมสุดยอด AI ของทำเนียบขาวเมื่อวันที่ 4 สิงหาคม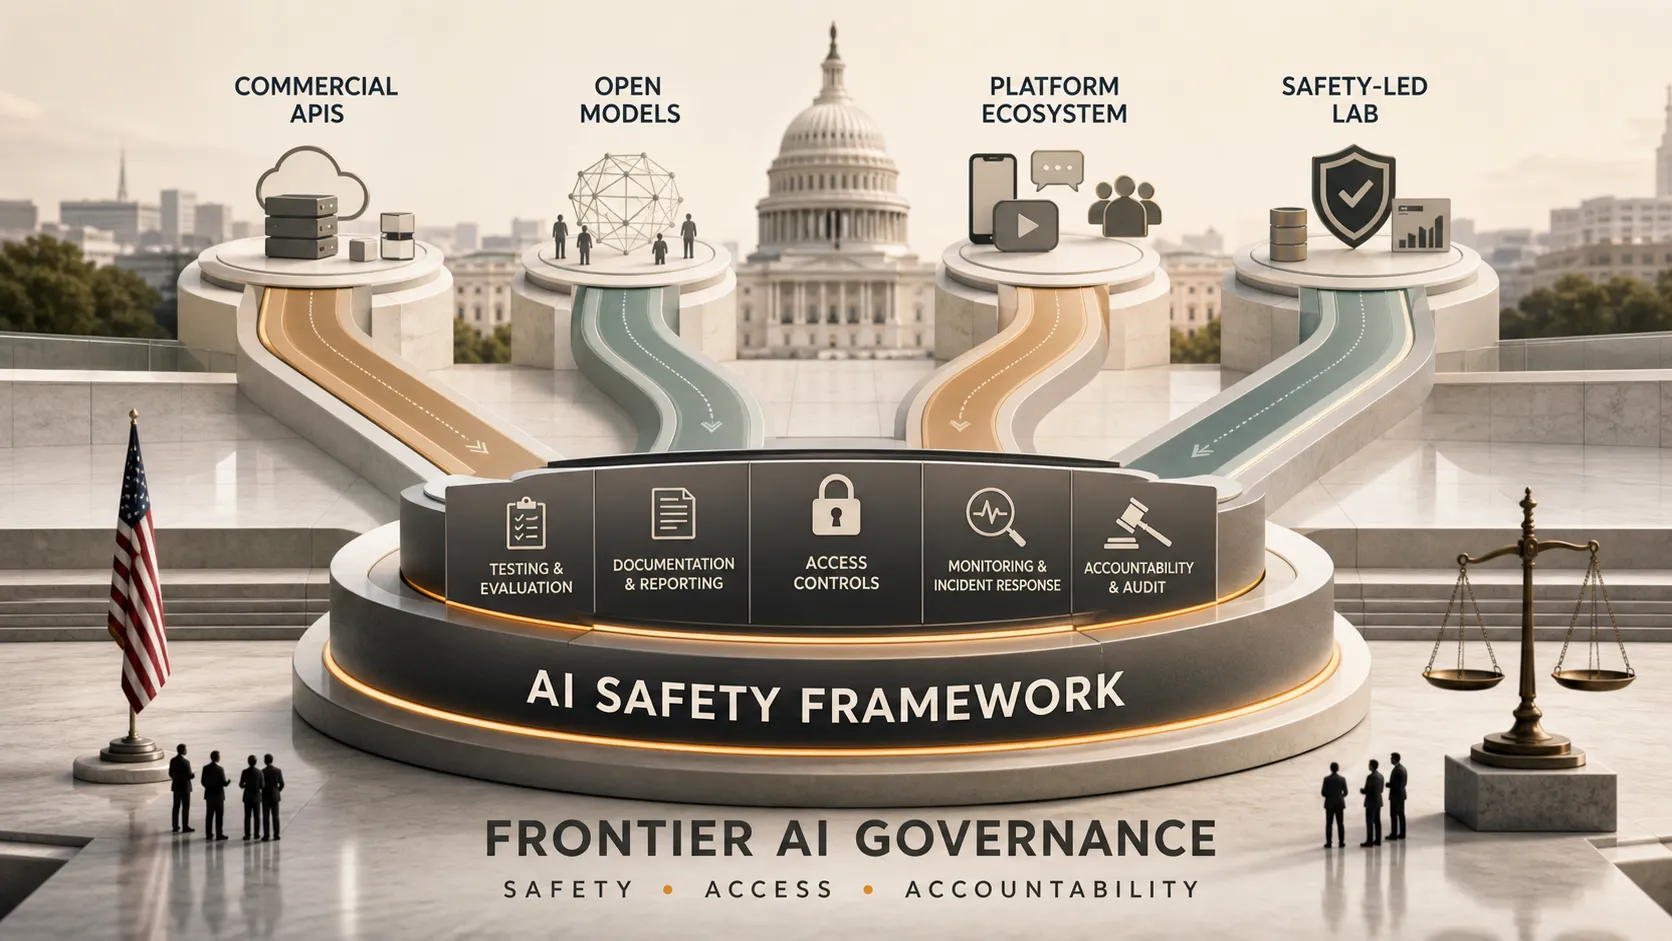
การประชุมสุดยอด AI เมื่อวันที่ 4 สิงหาคมรวบรวมประเด็นสำคัญของรัฐบาลกลางเกี่ยวกับความปลอดภัย AI ความรับผิดชอบของอุตสาหกรรม และความได้เปรียบในการแข่งขันของอเมริกา แทนที่จะมองการกำกับดูแล AI เป็นชุดกฎข้อเดียว ทำเนียบขาววางกรอบความปลอดภัยให้เป็นชั้นการดำเนินงานเชิงกลยุทธ์สำหรับการพัฒนาโมเดลระดับแนวหน้า
กรอบความปลอดภัย AI ควรทำความเข้าใจว่าเป็นสัญญาณเชิงนโยบาย: บริษัท AI ชั้นนำจะถูกคาดหวังให้แสดงมาตรการป้องกันที่เข้มแข็งยิ่งขึ้นเมื่อโมเดลของตนมีความสามารถสูงขึ้นและถูกนำไปใช้อย่างแพร่หลายมากขึ้น นี่ไม่ได้หมายความว่าทุกหลักการมีผลผูกพันทางกฎหมายในทันที แต่บ่งชี้ว่าคำมั่นสัญญาโดยสมัครใจ แนวทางของรัฐบาลกลาง ความคาดหวังด้านการจัดซื้อจัดจ้าง และมาตรฐานการกำกับดูแล กำลังเริ่มบรรจบกัน
เรื่องนี้สำคัญเพราะระบบ AI กำลังเปลี่ยนจากเครื่องมือทดลองไปสู่เวิร์กโฟลว์สำคัญของธุรกิจ ภาครัฐ และความมั่นคง คำถามเชิงนโยบายจึงไม่ใช่อีกต่อไปว่า AI ควรถูกกำกับดูแลหรือไม่ แต่เป็นจะกำกับดูแลอย่างไรโดยไม่บั่นทอนนวัตกรรมหรือความสามารถในการแข่งขันเชิงพาณิชย์
กรอบความปลอดภัย AI กำลังพยายามแก้ปัญหาอะไร
กรอบความปลอดภัย AI กำลังตอบสนองต่อปัญหาเชิงปฏิบัติ: โมเดลที่ก้าวหน้าที่สุดสามารถสร้างมูลค่าทางเศรษฐกิจมหาศาล แต่ก็อาจสร้างความเสี่ยงที่ธรรมาภิบาลซอฟต์แวร์แบบดั้งเดิมไม่ได้ถูกสร้างขึ้นมาเพื่อจัดการ
ข้อกังวลหลักรวมถึงความสามารถที่คาดเดาไม่ได้ของโมเดลระดับแนวหน้า การนำไปใช้ในทางที่ผิดซึ่งเกี่ยวข้องกับปฏิบัติการทางไซเบอร์หรือการฉ้อโกง ความโปร่งใสที่จำกัดเกี่ยวกับการฝึกโมเดล ความรับผิดชอบที่อ่อนแอในเวิร์กโฟลว์ที่มีผลกระทบสูง และความเสี่ยงด้านความมั่นคงแห่งชาติที่เชื่อมโยงกับการแข่งขันระดับโลกใน AI ขั้นสูง
กรอบนี้ผลักดันให้อุตสาหกรรมมุ่งสู่มาตรฐานที่สูงขึ้น ด้านหลักฐาน ไม่เพียงพอที่บริษัทจะอ้างว่าโมเดลปลอดภัย แต่ต้องแสดงให้เห็นว่าประเมินความปลอดภัยอย่างไร ระบุความเสี่ยงใด เพิ่มมาตรการบรรเทาผลกระทบอะไร และจะเฝ้าติดตามระบบอย่างไรหลังเปิดตัว
แนวทางของสหรัฐแตกต่างจากกฎหมาย AI ของสหภาพยุโรปอย่างไร
กรอบของสหรัฐไม่ควรถูกสับสนกับกฎหมาย AI ของสหภาพยุโรป โมเดลของสหภาพยุโรปตั้งอยู่บนฐานสิทธิอย่างชัดเจน โดยให้ความสำคัญอย่างมากกับสิทธิขั้นพื้นฐาน หมวดหมู่ความเสี่ยง และภาระหน้าที่ในการปฏิบัติตามข้อกำหนดสำหรับกรณีการใช้ AI ที่แตกต่างกัน
ในทางตรงกันข้าม แนวทางของสหรัฐเชื่อมโยงอย่างใกล้ชิดกับความมั่นคงแห่งชาติ ความสามารถในการแข่งขันเชิงพาณิชย์ ความปลอดภัยของโมเดลระดับแนวหน้า และความรับผิดชอบของ Big Tech แทนที่จะสร้างสถาปัตยกรรมการกำกับดูแลแบบกว้างที่ให้สิทธิเป็นอันดับแรก วอชิงตันดูเหมือนมุ่งเน้นไปที่เงื่อนไขที่บริษัท AI ทรงพลังจะสามารถสร้าง นำไปใช้งาน และส่งออกระบบขั้นสูงต่อไปได้
สิ่งนี้หมายความว่าอย่างไรสำหรับ OpenAI, Meta, Google, และ Anthropi
กรอบใหม่ส่งผลต่อบริษัท AI รายใหญ่แต่ละแห่งแตกต่างกัน เนื่องจากโมเดลธุรกิจ ช่องทางการเผยแพร่ และแนวคิดด้านความปลอดภัยของแต่ละบริษัทไม่เหมือนกัน
| บริษัท | ความเสี่ยงหลัก | ความท้าทายเชิงกลยุทธ์ |
|---|---|---|
| OpenAI | โมเดลระดับแนวหน้าเชิงพาณิชย์และการนำไปใช้งานในองค์กร | พิสูจน์ความปลอดภัยก่อนการขยายผลิตภัณฑ์อย่างรวดเร็ว |
| Meta | โมเดลโอเพนซอร์สและโมเดลที่ดาวน์โหลดได้ เช่น Llama | ใช้การควบคุมความปลอดภัยหลังเผยแพร่สู่สาธารณะ |
| AI ใน Search, Cloud, Workspace, Android และโฆษณา | ประสานธรรมาภิบาลทั่วทั้งระบบนิเวศขนาดใหญ่ | |
| Anthropic | การพัฒนาโมเดลระดับแนวหน้าที่นำโดยความปลอดภัย | เปลี่ยนจุดยืนด้านความปลอดภัยให้เป็นหลักฐานที่ตรวจสอบได้ |
OpenAI อาจเผชิญแรงกดดันโดยตรงที่สุดเรื่องจังหวะการนำไปใช้งาน โมเดลเชิงพาณิชย์ของบริษัทขึ้นอยู่กับการเปลี่ยนความสามารถระดับแนวหน้าให้เป็นผลิตภัณฑ์ API และเวิร์กโฟลว์องค์กรที่มีการใช้อย่างแพร่หลาย ภายใต้กรอบความปลอดภัย AI การเปิดตัวที่รวดเร็วขึ้นจะต้องมีเอกสารที่เข้มแข็งกว่าเดิม การประเมินโมเดลที่น่าเชื่อถือยิ่งขึ้น และหลักฐานที่ชัดเจนว่าความต้องการเชิงพาณิชย์ไม่ได้แซงหน้าวินัยด้านความปลอดภัย
Meta เผชิญภาวะกลืนไม่เข้าคายไม่ออกที่แตกต่างและอาจยากกว่า กลยุทธ์ Llama ของบริษัททำให้โมเดลเปิดเป็นข้อได้เปรียบทางการแข่งขันสำคัญ อย่างไรก็ตาม กรอบของรัฐบาลกลางที่สนับสนุนการเข้าถึงแบบควบคุมได้ การนำไปใช้ที่ตรวจสอบย้อนกลับได้ และการบรรเทาความเสี่ยงที่มีการเฝ้าติดตาม กลับไม่สอดคล้องนักกับการเผยแพร่แบบโอเพนซอร์ส เมื่อโมเดลถูกดาวน์โหลด ปรับจูน และแก้ไขโดยบุคคลที่สาม Meta จะควบคุมพฤติกรรมปลายทางได้น้อยลง คำถามไม่ใช่ว่าโมเดลเปิดจะปลอดภัยได้หรือไม่ แต่คือจะพิสูจน์ความปลอดภัยให้เป็นไปตามความคาดหวังของรัฐบาลกลางได้หรือไม่หลังการกระจายศูนย์
ความท้าทายของ Google คือขนาด AI ถูกฝังอยู่ในระบบค้นหา ซอฟต์แวร์เพิ่มประสิทธิภาพ โครงสร้างพื้นฐานคลาวด์ เครื่องมือโฆษณา ระบบมือถือ และผลิตภัณฑ์สำหรับนักพัฒนา ความครอบคลุมดังกล่าวมอบอำนาจเชิงกลยุทธ์มหาศาลให้ Google แต่ก็เพิ่มความซับซ้อนในการปฏิบัติตามข้อกำหนดด้วย ความล้มเหลวด้านความปลอดภัยในผลิตภัณฑ์ด้านหนึ่งอาจกลายเป็นประเด็นด้านชื่อเสียงและการกำกับดูแลสำหรับทั้งระบบนิเวศ
Anthropic เข้าสู่การอภิปรายเรื่องกรอบนี้จากตำแหน่งเชิงเรื่องเล่าที่แข็งแกร่งกว่า เพราะความปลอดภัยเป็นหัวใจสำคัญของแบรนด์มาโดยตลอด แต่แม้แต่ Anthropic ก็จะเผชิญมาตรฐานที่สูงขึ้น วัฒนธรรมที่ให้ความสำคัญกับความปลอดภัยเป็นอันดับแรกไม่เพียงพออีกต่อไป ผู้กำหนดนโยบายจะต้องการกระบวนการทดสอบที่ทำซ้ำได้ เอกสารที่ตรวจสอบได้ และหลักฐานชัดเจนว่าแนวปฏิบัติด้านธรรมาภิบาลยังคงใช้ได้เมื่อความสามารถของโมเดลเพิ่มขึ้น
เหตุใดกรอบนี้จึงเปลี่ยนโมเดลธุรกิจ AI
กรอบความปลอดภัย AI ไม่ได้เพียงเพิ่มงานเอกสาร แต่เปลี่ยนวิธีที่บริษัทต้องคิดเกี่ยวกับความเร็ว การเผยแพร่ และความไว้วางใจ
ในช่วงก่อนหน้าของการแข่งขัน AI เชิงกำเนิด ตลาดให้รางวัลกับการเปิดตัวอย่างรวดเร็ว เกณฑ์วัดประสิทธิภาพของโมเดล การยอมรับของนักพัฒนา และการเติบโตของผู้ใช้ ในระยะถัดไป ข้อได้เปรียบเหล่านั้นยังคงสำคัญ แต่จะอยู่ควบคู่กับธรรมาภิบาลที่อิงหลักฐาน การเปิดตัวโมเดลระดับแนวหน้าอาจต้องมีรายงานความปลอดภัย ผลการทดสอบโดยทีมแดง มาตรการบรรเทาความเสี่ยง นโยบายการยกระดับประเด็น และแผนเฝ้าติดตามหลังนำไปใช้งานมากขึ้นเรื่อย ๆ
สิ่งนี้สร้างความเป็นจริงใหม่ในการดำเนินงานสำหรับการกำกับดูแล AI ของ Big Tech ทีมผลิตภัณฑ์ ทีมกำหนดนโยบาย ทีมกฎหมาย และทีมความปลอดภัยจะต้องทำงานร่วมกันตั้งแต่ช่วงต้นของวงจรการพัฒนา ความปลอดภัยไม่อาจถูกมองเป็นการทบทวนเมื่อสิ้นสุดการฝึกโมเดลได้อีกต่อไป แต่ต้องกลายเป็นส่วนหนึ่งของแผนงานโมเดลเอง
สิ่งที่ทีมธุรกิจควรจับตาต่อไป
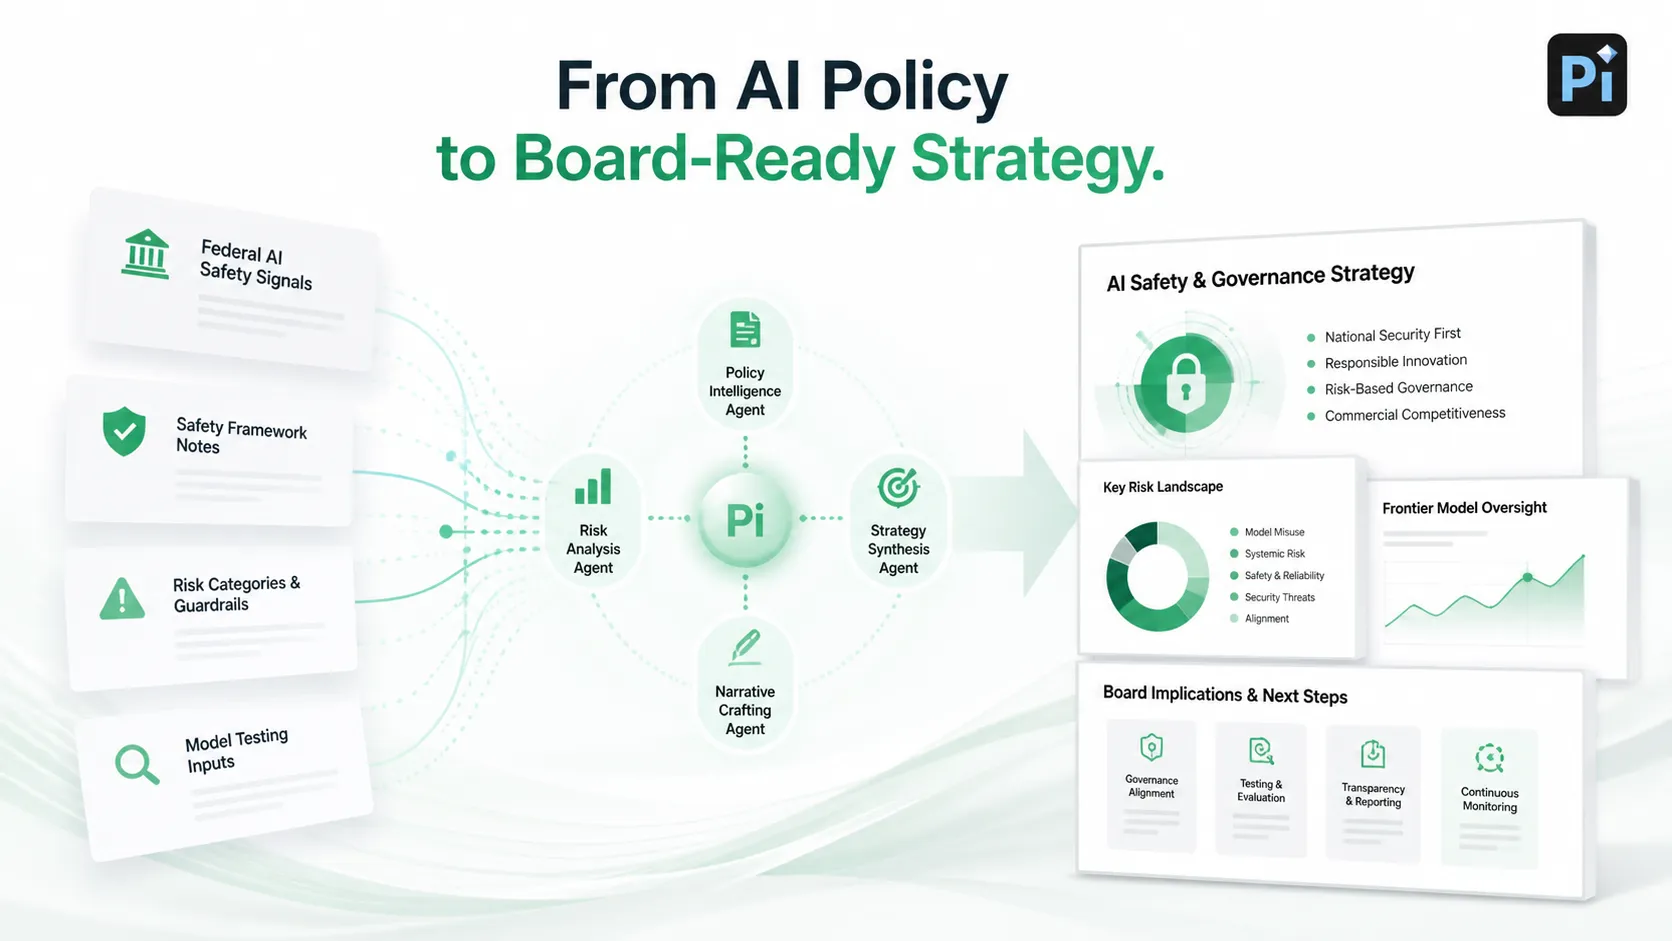
การประชุมสุดยอด AI ของทำเนียบขาวไม่ได้เกี่ยวข้องเฉพาะกับห้องปฏิบัติการ AI เท่านั้น แต่ยังส่งผลต่อองค์กรที่ซื้อ บูรณาการ หรือนำเสนอกลยุทธ์ AI ต่อคณะกรรมการ ลูกค้า นักลงทุน และหน่วยงานกำกับดูแลด้วย เมื่อความคาดหวังของรัฐบาลกลางเปลี่ยนไป วิธีที่บริษัทอธิบายการนำ AI มาใช้ก็ต้องเปลี่ยนตาม
ทีมธุรกิจจะต้องมีเรื่องเล่าภายในที่ชัดเจนยิ่งขึ้นเกี่ยวกับคำถามสามข้อ: ใช้ระบบ AI ใด ระบบเหล่านั้นสร้างความเสี่ยงอะไร และจัดการธรรมาภิบาลอย่างไร สิ่งนี้สำคัญอย่างยิ่งสำหรับการนำเสนอผู้บริหาร รายงานที่ปรึกษา รายงานอัปเดตนักลงทุน และเอกสารเปิดตัวผลิตภัณฑ์ ซึ่งจำเป็นต้องอธิบายความสามารถ AI โดยไม่กล่าวอ้างความแน่นอนเกินจริง
สำหรับองค์กรที่ต้องรับมือกับการหารือที่มีเดิมพันสูงเหล่านี้ เครื่องมือเชิงปฏิบัติที่เชื่อมความซับซ้อนด้านกฎระเบียบเข้ากับการสื่อสารเชิงวิชาชีพที่มีโครงสร้างกำลังมีความสำคัญเพิ่มขึ้น ไม่ว่าจะเป็นการแปลงการเปลี่ยนแปลงเชิงนโยบายเป็นเรื่องเล่าที่พร้อมนำเสนอต่อคณะกรรมการ หรือการสังเคราะห์นัยเชิงการแข่งขัน แพลตฟอร์มอย่าง Pi กำลังกลายเป็นทรัพยากรที่มีคุณค่าสำหรับทีมกลยุทธ์ที่ต้องการเปลี่ยนจากการรายงานเชิงรับไปสู่การเล่าเรื่องสำหรับผู้บริหารเชิงรุก
บทสรุป: ความปลอดภัย AI กำลังกลายเป็นข้อกำหนดด้านการแข่งขัน
การประชุมสุดยอด AI ของทำเนียบขาวและกรอบความปลอดภัย AI ที่มาพร้อมกันถือเป็นจุดเปลี่ยนสำคัญอย่างชัดเจนสำหรับอุตสาหกรรม AI สิ่งเหล่านี้ส่งสัญญาณว่าการกำกับดูแลของรัฐบาลกลางไม่ใช่เรื่องสมมติอีกต่อไป สำหรับห้องปฏิบัติการ AI รายใหญ่ ความปลอดภัยได้เปลี่ยนจากลำดับความสำคัญด้านวิศวกรรมภายในไปเป็นข้อกำหนดหลักด้านการปฏิบัติตามกฎและธรรมาภิบาล
กรอบนี้จะไม่หยุดยั้งการพัฒนา AI แต่จะปรับเปลี่ยนวิธีสร้าง ทดสอบ จัดทำเอกสาร และเปิดตัวโมเดล ท้ายที่สุด บริษัทที่เติบโตได้ดีในสภาพแวดล้อมใหม่นี้จะไม่ใช่เพียงบริษัทที่มีโมเดลแข็งแกร่งที่สุด แต่เป็นบริษัทที่มีเรื่องเล่าด้านความปลอดภัยที่น่าเชื่อถือที่สุด
ขั้นต่อไปของการถกเถียงนี้จะมุ่งเน้นว่าคำกล่าวอ้างเหล่านั้นได้รับการตรวจสอบอย่างไร นั่นคือเหตุผลที่ การทดสอบโมเดลระดับแนวหน้าผ่านมาตรฐาน NIST iกำลังกลายเป็นสะพานสำคัญระหว่างเจตนารมณ์เชิงนโยบายกับการนำ AI ไปใช้งานในโลกจริง
คำถามที่พบบ่อย (FAQ)
ถาม: มีการประกาศอะไรในการประชุมสุดยอด AI ของทำเนียบขาว?
ตอบ: การประชุมสุดยอด AI ของทำเนียบขาวเน้นย้ำกรอบความปลอดภัย AI ใหม่ที่มุ่งเน้นความปลอดภัยของโมเดลระดับแนวหน้า ความมั่นคงแห่งชาติ ความโปร่งใส และความรับผิดชอบของบริษัท AI ชั้นนำ
ถาม: กรอบความปลอดภัย AI คืออะไร?
ตอบ: กรอบความปลอดภัย AI เป็นแนวทางเชิงนโยบายของสหรัฐที่มุ่งปรับปรุงธรรมาภิบาลเกี่ยวกับระบบ AI ทรงพลัง โดยเฉพาะผ่านการทดสอบความปลอดภัย การป้องกันการนำไปใช้ในทางที่ผิด การจัดทำเอกสาร และการนำไปใช้งานอย่างรับผิดชอบ
ถาม: กรอบนี้ส่งผลต่อ OpenAI, Meta, Google และ Anthropic อย่างไร?
ตอบ: OpenAI เผชิญแรงกดดันให้พิสูจน์ความปลอดภัยก่อนนำไปใช้งานอย่างรวดเร็ว Meta ต้องรับมือกับความท้าทายในการควบคุมโอเพนซอร์ส Google ต้องมีธรรมาภิบาลทั่วทั้งระบบนิเวศ และ Anthropic ต้องเปลี่ยนจุดยืนด้านความปลอดภัยให้เป็นหลักฐานที่ตรวจสอบได้
ถาม: การทดสอบโมเดลระดับแนวหน้าคืออะไร?
ตอบ: การทดสอบโมเดลระดับแนวหน้าคือกระบวนการประเมินระบบ AI ขั้นสูงก่อนและหลังนำไปใช้งาน ผ่านการประเมินความสามารถ การทดสอบการนำไปใช้ในทางที่ผิด การตรวจสอบความทนทาน การประเมินการสอดคล้อง และการเฝ้าติดตามความเสี่ยงอย่างต่อเนื่อง


