超越 LLM:TypeSafe Jev 对系统一 AI 的意义
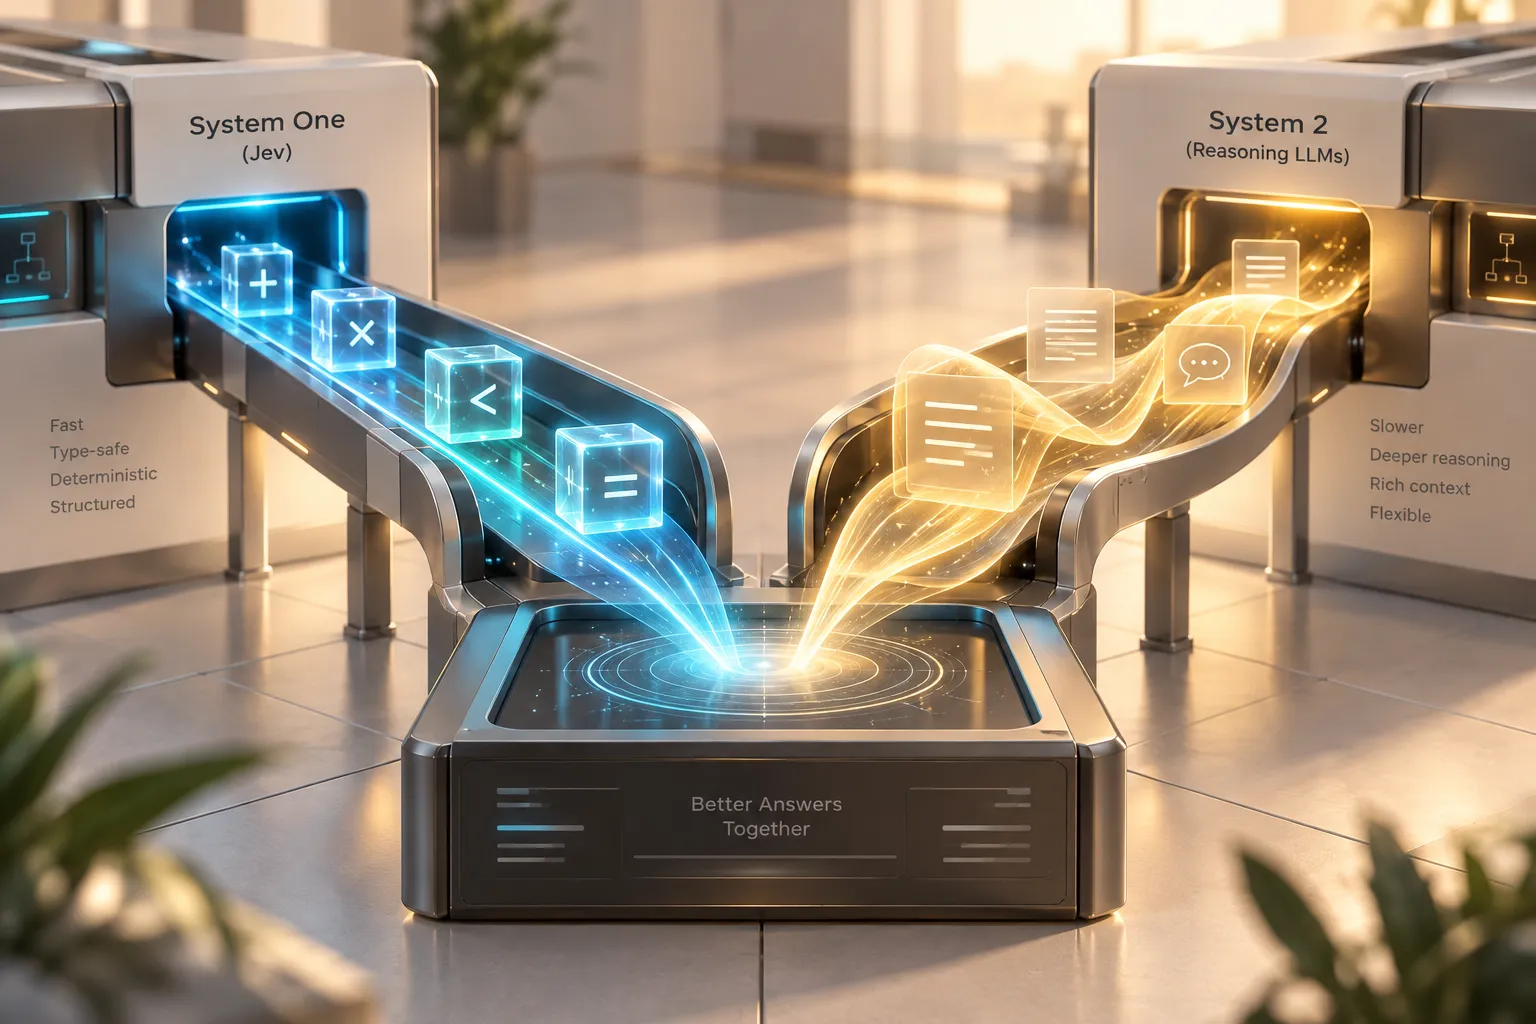
在行为经济学中,诺贝尔奖得主 Daniel Kahneman 向世界介绍了系统 1(快速、直觉式、并行决策)和系统 2(缓慢、审慎、分析性推理)。
多年来,生成式 AI 热潮一直痴迷于构建庞大的系统 2 引擎:例如 Claude 3.5、GPT-4 和 Gemini 1.5 等巨型推理 LLM,能够撰写文章、编写代码并解决复杂的多步骤问题。
然而,软件开发面临一个隐形瓶颈:现代应用内部的大多数操作并不需要复杂推理或自然语言散文。它们需要的是超高速、结构化的决策——例如路由工单、分配置信度评分或检测垃圾信息。对这些任务使用巨型聊天 LLM,就像雇一位哲学家来开关灯:缓慢、昂贵,而且容易导致 JSON 解析器出错。
Jev登场:这是 TypeSafe AI 发布的旗舰系统一模型。
如果你使用 AI 构建软件,以下将全面解析什么是系统一模型、Jev 如何工作,以及这一转变为何可能从根本上重构 AI 融入生产技术栈的方式。
什么是系统一模型?
系统一模型是一种专为高速、有边界且带类型的决策而设计的 AI 模型,而非用于开放式文本生成。
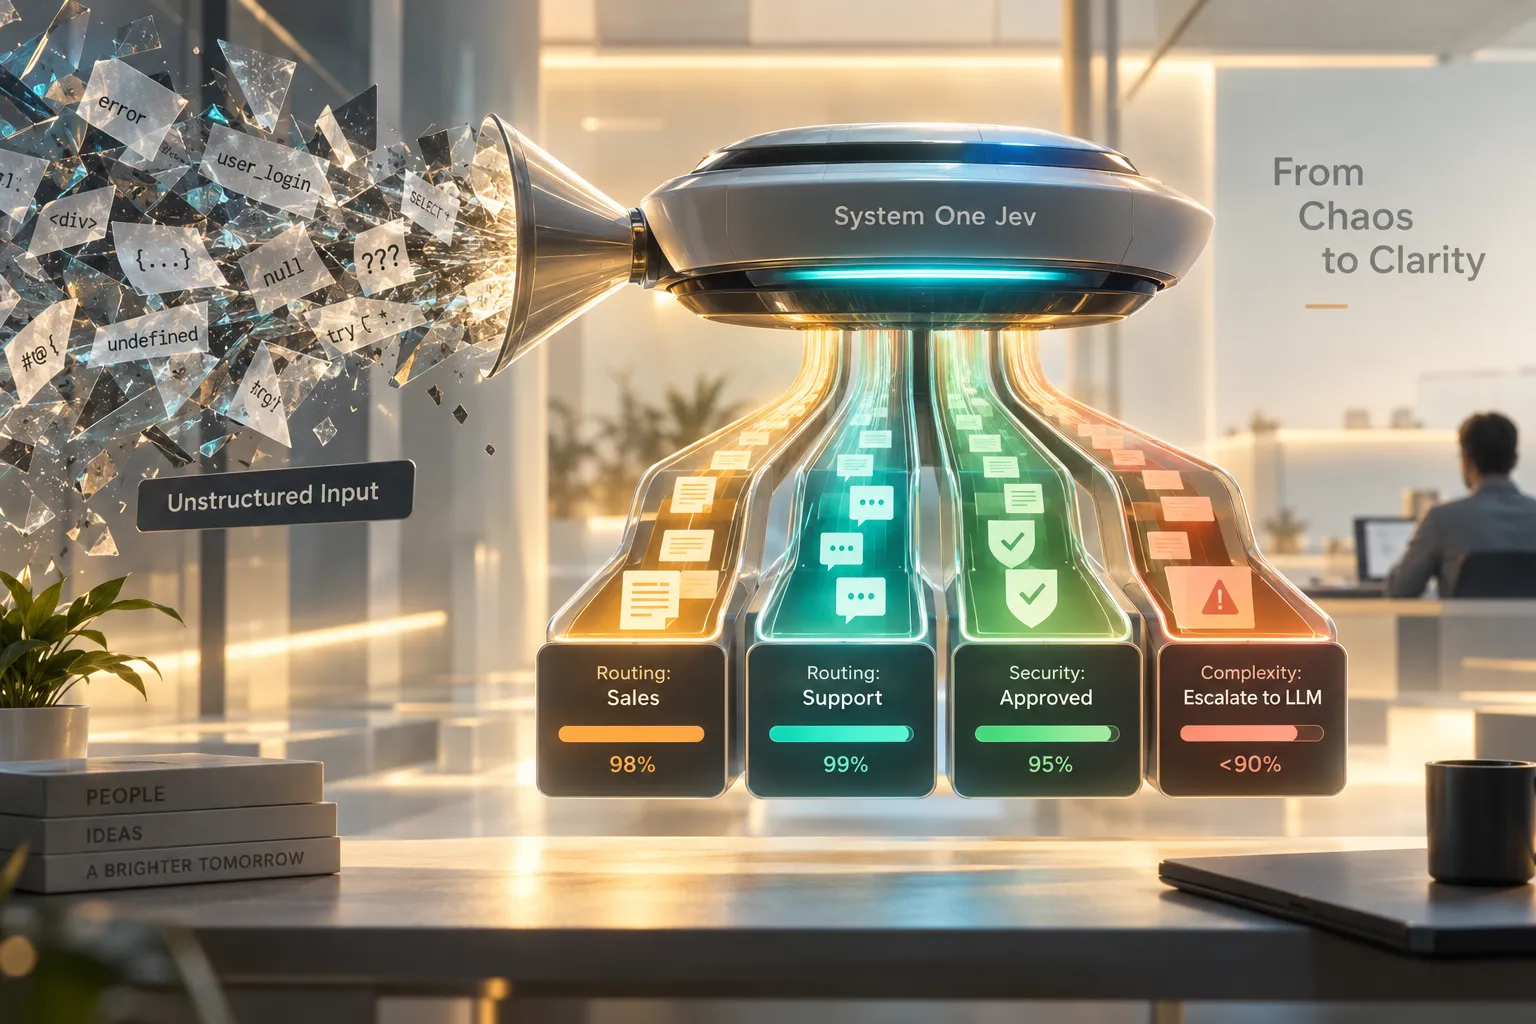
系统一模型不会逐词元生成原始文本,而是接收非结构化的程序状态(例如文本日志、用户输入或 JSON 对象),并在单次并行处理中评估预定义选项。
[非结构化输入 / 状态] ---> [ 系统一模型 (Jev) ] ---> [ 类型安全的决策 + 概率 ]
它不会输出散文,而是返回如下类型安全原语:
- 选择:从预定义选项集中进行分类选择(最多 255 个选项)。
- 评分:沿预定义指标给出数值评级。
- 布尔值(Noul):经过校准的是/否概率。
TypeSafe Jev 与标准 LLM 有何不同?
要了解为什么开发者对 Jev 的采用率激增,可以看看它与 GPT-4o 或 Claude 等标准前沿 LLM 的对比:
| 特性 | 标准聊天/推理 LLM | 系统一模型(Jev) |
| 输出类型 | 非结构化字符串(散文、JSON 文本) | 严格类型化的值(选择、评分、布尔值) |
| 采样机制 | 自回归(逐词元) | 单次并行处理 |
| 延迟 | 1 至 10+ 秒 | 70 毫秒 – 500 毫秒 |
| 置信度评分 | 常常过度自信或未经校准 | 每项输出均提供校准后的概率 |
| 类型错误 / 架构破坏 | 存在格式错误输出/JSON 解析失败的风险 | 0% 类型错误率(由设计保证) |
| 主要使用场景 | 内容生成、聊天、智能体推理 | 工单路由、垃圾信息检测、智能体准入控制 |
Jev 系统一架构的主要优势
1. 零幻觉和类型错误
由于系统一模型不生成自由形式的句子,它们消除了格式错误。软件应用无需复杂的重试逻辑或防御性 JSON 解析——输出会严格遵循代码中声明的架构。
2. 内置校准置信度
传统 LLM 因自信地给出错误答案而臭名昭著。Jev 采用用于校准决策的强化学习(RLCD)等技术进行训练,为每个决策提供数学概率。
这使开发者能够构建清晰的逻辑门:
- 置信度 > 95%:自动执行。
- 置信度 < 80%:转交人工审核,或升级至更强大的系统 2 模型(如 Claude 或 GPT-4)。
3. 延迟与成本效率
通过去除自回归文本生成的开销,系统一模型的运行速度可比传统聊天 LLM 快 40 倍至 100 倍。输入词元成本大幅下降,而标准输出生成开销则被完全消除。
真实应用场景:系统一在你的架构中适合哪里
Jev 和系统一模型并非旨在取代 ChatGPT 或 Claude 等 LLM——它们被设计为在其前面或旁边充当快速、确定性的决策层。
                     ┌────────────────────────┐
                     │   传入的用户请求       │
                     └───────────┬────────────┘
                                 │
                                 ▼
                     ┌────────────────────────┐
                     │   系统一(Jev API)     │
                     └───────────┬────────────┘
                                 │
          ┌──────────────────────┴──────────────────────┐
          │ 高置信度(>90%)                            │ 低置信度(<90%)
          ▼                                             ▼
┌──────────────────┐                           ┌──────────────────┐
│ 自动路由         │                           │ 系统 2(LLM)    │
│ 或工具执行       │                           │ / 人工升级处理   │
└──────────────────┘                           └──────────────────┘
主要应用:
- 支持工单与销售线索路由:即时分类传入工单(例如 {billing, technical, sales})并评估紧急程度,无需解析杂乱的文本回复。
- AI 智能体工具授权:根据安全规则决定是否应自动批准工具调用,从而消除自主循环中的延迟。
- 级联 RAG 管道:在将检索到的向量文档上下文发送给高成本生成模型之前,评估其是否相关。
- 内容审核与护栏:在 100 毫秒内扫描传入的用户请求或模型输出,检查是否存在违反政策的情况。
局限性:Jev 无法做什么
要有效地使用系统一模型进行构建,必须了解其边界:
- 无法自由文本生成:Jev 无法起草电子邮件、编写代码、将长文档概括为散文,或进行聊天。
- 没有内部世界知识:Jev 完全依赖传递给它的状态;它无法浏览网页,也无法自行执行复杂的内部知识检索。
- 需要预定义架构:在进行 API 调用之前,你必须知道确切的有边界选项集或评分标准。
结论:双模型架构已经到来
TypeSafe 的 Jev 发布标志着 AI 工程领域的一次关键转变。在应用的每一步都使用一个庞大且昂贵的 LLM 的时代正在淡去。
相反,生产级应用正转向混合架构:
- 系统一(Jev):以低延迟处理高速、高容量的分类、工具选择、路由和过滤。
- 系统 2(GPT/Claude/Gemini):负责长篇生成、复杂推理和开放式分析。
通过将微决策委托给系统一模型,开发者可以构建速度更快、成本大幅降低且在数学上可靠的 AI 系统。
尽管后端架构正转向 Jev 等低延迟模型以简化数据流程,前端呈现和报告也不应成为瓶颈。了解演示智能(PI)如何帮助团队即时创建、构建并自动化高影响力的推介演示文稿和报告。


