Kimi K3 開放日:2.8 兆參數,現已開放權重
2026 年 7 月 27 日,Moonshot AI 舉辦了 Kimi K3 Open Day,並宣布三項相互關聯的發布:Kimi K3 模型權重、官方技術公告,以及三項基礎設施技術:MoonEP、FlashKDA和AgentEnv。此次活動將Kimi K3定位為不僅是一個新的大型模型,更是一項涵蓋模型存取、架構與部署基礎設施的發布。
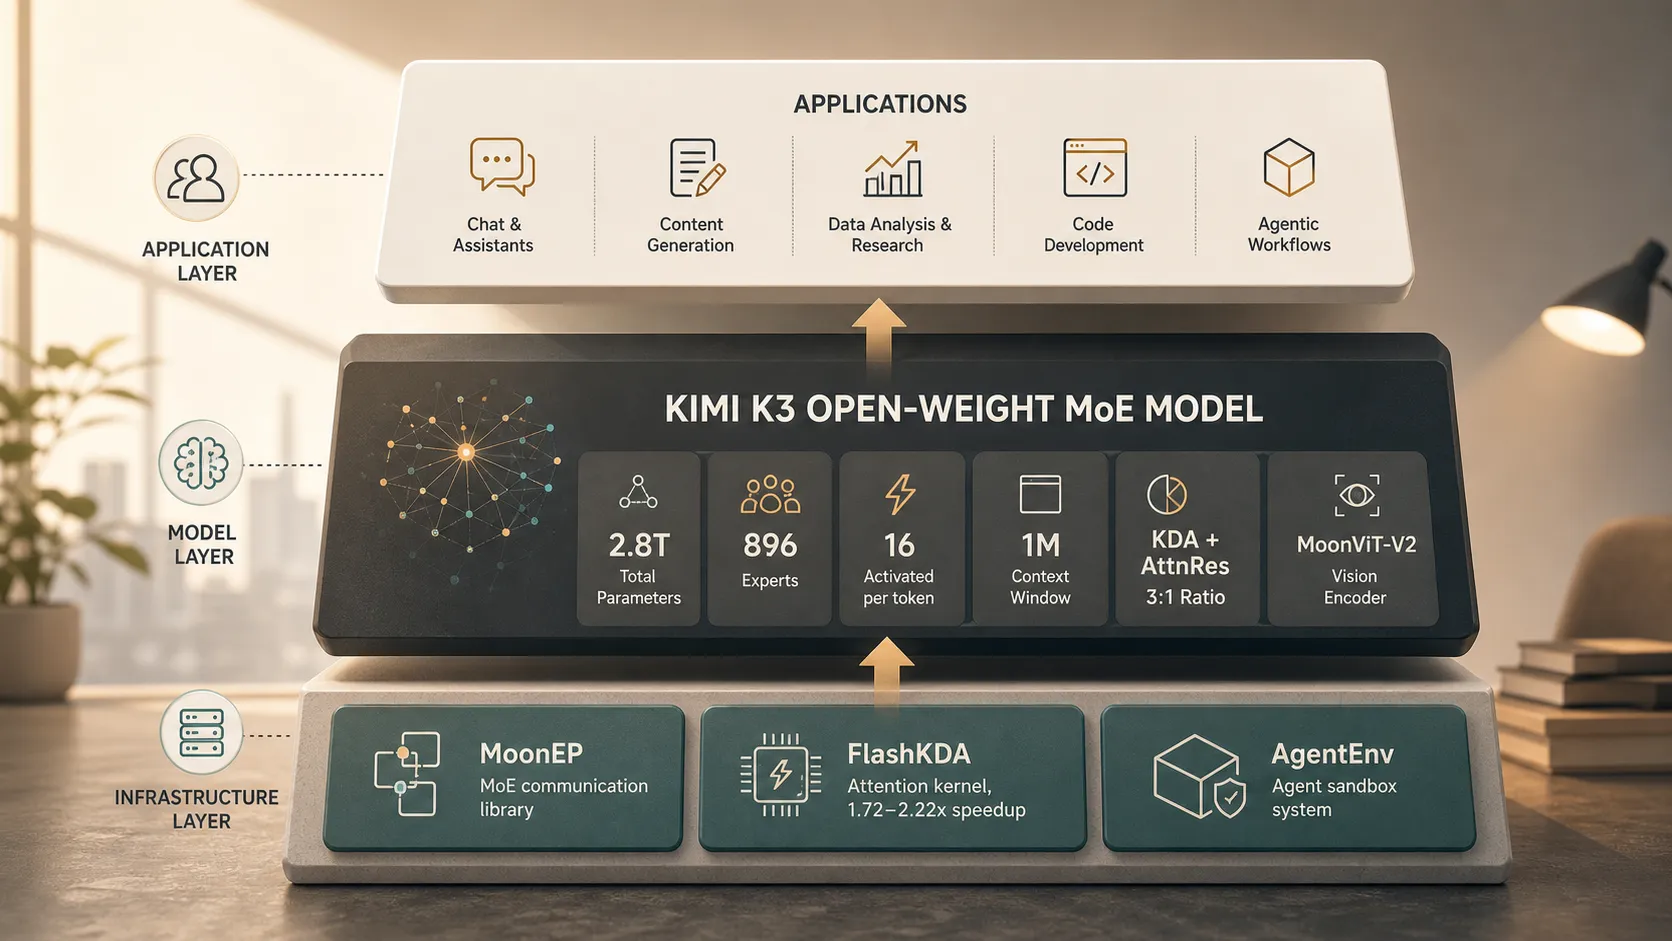
核心規格很明確:Kimi K3 是一個擁有 2.8 兆參數的開放權重模型,建立於專家混合(MoE)架構之上。Moonshot AI 揭露了多項重要技術細節,包括896 位專家、每個 token 啟用 16 位專家、100 萬 token 的上下文視窗、以 3:1 比例搭配的 KDA + AttnRes、MoonViT-V2,以及宣稱的2.5 倍擴展效率提升。
開放權重一詞很重要。開放權重意味著已訓練的模型權重會依既定條款提供。這並不自動表示模型完全開源;完全開源通常意味著可更廣泛存取原始碼、訓練資料、工具及重現流程。儘管如此,開放權重存取仍可改變開發者與組織部署、檢視及圍繞大型 AI 模型進行建置的方式。
Moonshot AI 如此總結此方法的價值:「開放權重模型……降低取得智慧能力的門檻、推動創新,並讓使用者對資料、隱私與所有權擁有更大的控制權。」
Open Day 活動:三項核心發布
Kimi K3 Open Day 聚焦於三類發布內容。
首先,Moonshot AI 發布了Kimi K3 模型權重。這是核心的開放權重公告。對建構者而言,取得權重可帶來比僅限託管 API 更靈活的部署方式,尤其是在團隊需要掌控基礎設施、延遲、隱私或資料駐留時。
其次,Moonshot AI 發布了 Kimi K3 技術報告。這很重要,因為大型模型的發布不能只憑參數數量來評估。架構、路由策略、長上下文設計、多模態能力及效率宣稱,決定了一個模型在實務上是否有用。
第三,Moonshot AI 發布了MoonEP、FlashKDA和AgentEnv。這些基礎設施技術針對專家通訊、注意力效能與代理執行。其納入顯示 Kimi K3 Open Day 不只是一場模型發布;它也是一項基礎設施發布,旨在更有效地使用超大型開放權重模型。
模型:核心規格
Kimi K3 是一個擁有 2.8 兆參數的 MoE 模型。在專家混合架構中,每個 token 僅會啟用部分模型。路由器會選擇一部分專家,讓系統能結合極大的總容量,以及低於相似規模稠密模型的活躍運算量。
根據 Moonshot AI,Kimi K3 擁有896 位專家,並且每個 token 啟用 16 位專家。此設計是模型效率特性的核心。它讓模型可保有龐大的整體容量,同時在推論期間採用選擇性啟用。
| 規格 | Kimi K3 官方細節 |
|---|---|
| 總參數量 | 2.8 兆 |
| 架構 | 專家混合(MoE) |
| 專家配置 | 896 位專家 / 每個 token 啟用 16 位 |
| 上下文視窗 | 100 萬 token |
| 注意力設計 | 以 3:1 比例搭配的 KDA + AttnRes |
| 視覺架構 | MoonViT-V2 |
| 擴展效率 | 提升 2.5 倍 |
100 萬 token 的上下文視窗是最具實用性的規格之一。長上下文可支援完整文件分析、大型程式碼庫審查、多檔案推理、法律或財務文件工作流程,以及更長的代理任務,而無須將每個輸入強制拆分成小片段。
Kimi K3 也採用以 3:1 比例搭配的 KDA + AttnRes,這是一種與其長上下文策略相關的混合注意力設計。該模型將MoonViT-V2納入其視覺架構,表示具備原生多模態能力,而非純文字系統。Moonshot AI 也報告了2.5 倍擴展效率提升,顯示 Kimi K3 的設計不僅著眼於規模,也著眼於更實際的訓練與推論經濟效益。
基礎設施發布:MoonEP、FlashKDA和AgentEnv。
開放權重模型仍需要強大的周邊系統。大型 MoE 模型仰賴高效率通訊、快速注意力核心和安全的執行環境。Moonshot AI 的基礎設施發布直接回應了這些需求。
MoonEP:MoE 專家通訊
MoonEP是一個用於 MoE 專家並行的通訊函式庫。在 MoE 系統中,token 會被路由至不同專家,而這些專家可能分布在多個裝置上。這會帶來通訊挑戰,可能限制吞吐量並增加延遲。
對於擁有896 位專家、且每個 token 啟用 16 位專家的 Kimi K3 而言,專家路由是一項重大的系統問題。MoonEP 旨在改善分散式專家通訊,並減少大規模 MoE 部署中的瓶頸。
FlashKDA:更快的長上下文注意力
FlashKDA是一個針對 KDA 最佳化的注意力核心。其角色對長上下文工作負載尤其重要,因為預填運算可能變得昂貴。Moonshot AI 表示,與 flash-linear-attention 基準相比,FlashKDA 在 Nvidia H20 GPU 上的預填效能可帶來1.72 倍至 2.22 倍加速。
這很重要,因為 100 萬 token 的上下文視窗只有在能夠高效率提供服務時才有用。更快的注意力核心可使長文件分析、程式碼審查、研究工作流程及多步驟推理更適合在生產環境中使用。
AgentEnv:AI 代理沙箱
AgentEnv是一個與 KVCache.ai 共同開發的代理沙箱系統。它為需要執行步驟、測試操作、分叉狀態、還原先前狀態或執行平行分支的代理提供一個隔離的沙箱環境。
代理工作流程通常不只是文字生成。它們可能使用檔案、工具、程式碼執行及多步驟決策。沙箱有助於將代理行為與外部系統分離,同時支援實驗。當代理需要在產出最終結果前探索多條路徑時,AgentEnv 的快照、還原與分叉功能相當實用。
為何開放權重很重要
開放權重存取改變了模型供應商與建構者之間的關係。封閉的託管 API 可以很強大,但基礎設施、託管、資料流和營運限制仍由供應商控制。開放權重模型讓符合條件的團隊有更多空間部署、調整、最佳化並將模型整合至自己的系統。
對企業而言,最大的優勢是部署與資料控制。敏感文件、內部程式碼、法律紀錄、客戶資訊及財務資料可能需要私有基礎設施。開放權重存取可支援本地或私有雲部署,在這些部署中,資料治理、隱私與所有權是核心要求。
對開發者而言,開放權重存取能實現更深入的技術整合。團隊可以最佳化推論堆疊、測試調適方法,並圍繞模型的優勢建立工作流程。Kimi K3 的 MoE 規模、100 萬 token 上下文、MoonViT-V2 視覺能力及基礎設施發布,為專門應用奠定基礎。
與開源的區別仍至關重要。開放權重並不會自動提供訓練資料、原始流程或完整的重現方法。然而,對需要模型存取、私有部署或更大效能與隱私控制權的團隊而言,它仍可降低實際門檻。
結論:模型與基礎設施的發布
最適合將Kimi K3 Open Day 理解為跨越三個層面的協同發布:模型存取、技術揭露和部署基礎設施。擁有 2.8 兆參數的 MoE 模型是本次公告的核心,但技術報告與基礎設施工具對理解其更廣泛的意義同樣關鍵。
官方規格相當可觀:2.8 兆總參數、896 位專家,其中每個 token 啟用 16 位、100 萬 token 的上下文視窗、以 3:1 比例搭配的 KDA + AttnRes、MoonViT-V2,以及宣稱的2.5 倍擴展效率提升。MoonEP、FlashKDA 和 AgentEnv 顯示 Moonshot AI 也在處理有效運行大型開放權重模型所需的系統。
Kimi K3並未被描述為完全開源;它是開放權重模型。即便如此,透過發布權重、技術細節及支援基礎設施,Moonshot AI 使 Kimi K3 成為大規模開放權重 AI 發展中的重要事件。
常見問題(FAQ)
問:什麼是 Kimi K3?
答:Kimi K3 是 Moonshot AI 推出的擁有 2.8 兆參數的開放權重專家混合 AI 模型,於 2026 年 7 月 27 日的 Kimi K3 Open Day 上發布。
問:開放權重是什麼意思?
答:開放權重意味著可依既定授權條款存取已訓練的模型權重。它不同於開源;開源通常意味著可更廣泛存取原始碼、資料及重現流程。
問:Kimi K3 同時發布了哪些基礎設施技術?
答:Moonshot AI 發布了MoonEP、FlashKDA和AgentEnv。MoonEP 支援 MoE 通訊,FlashKDA 加速 KDA 注意力,AgentEnv 則為 AI 代理提供沙箱系統。
問:Kimi K3 最重要的規格有哪些?
答:Kimi K3 擁有 2.8 兆總參數、896 位專家且每個 token 啟用 16 位、100 萬 token 的上下文視窗、以 3:1 比例搭配的 KDA + AttnRes、MoonViT-V2,以及 2.5 倍擴展效率提升。


