什麼是機器學習
如果你想問什麼是機器學習,最簡單的答案是:機器學習是一種讓電腦從資料中學習模式,並運用這些模式做出預測、推薦或決策的方法。人們不必親手編寫每一條規則,而是提供系統範例,讓系統從中學習。
NIST 的詞彙表將機器學習定義為能夠適應並從資料中學習,以提升準確度的電腦系統。這聽起來很技術性,但日常概念其實很熟悉:系統看到的有用範例越多,就越能辨識模式。
用簡單的話說,什麼是機器學習
機器學習是人工智慧的一個分支。IBM、Google Cloud、Microsoft Azure和AWS都以類似方式說明:機器學習使用資料與演算法來訓練系統,使其能夠在未針對每種情況明確編程的情況下做出預測或找出模式。
想像你正在教孩子辨識狗。你不會列出所有可能的耳朵形狀、尾巴長度和毛色。你會展示範例。隨著時間過去,孩子會學到其中的模式。機器學習的精神相似,但運用的是資料、數學和演算法。
機器學習如何運作
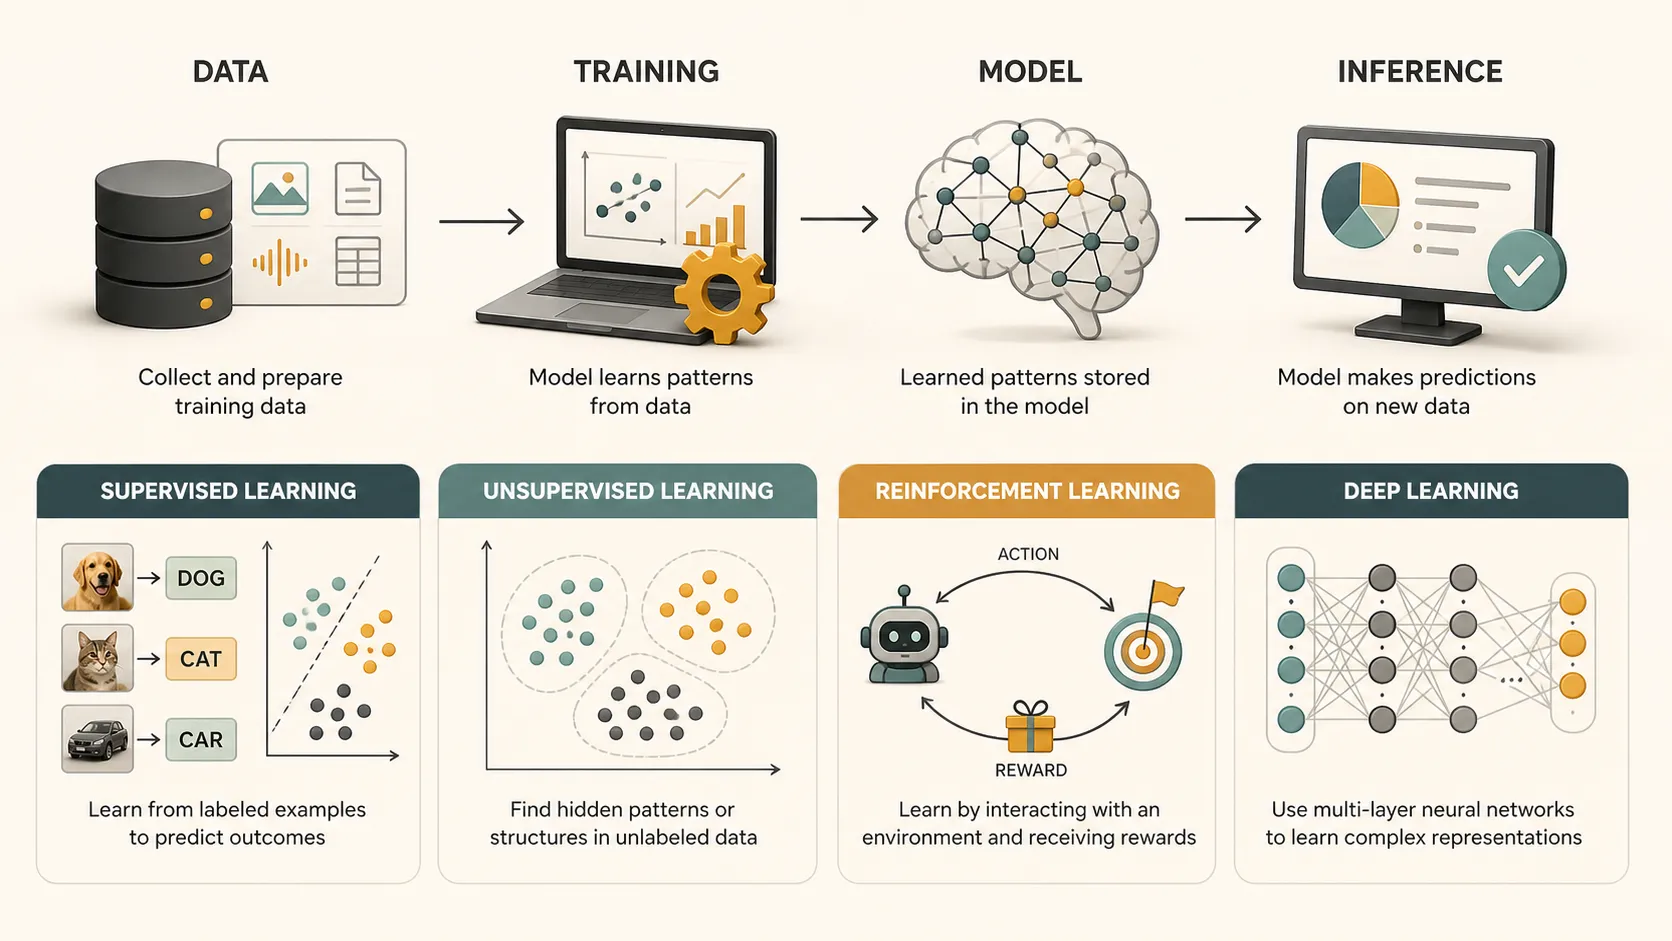
大多數機器學習專案都遵循基本流程:收集資料、準備資料、訓練模型、測試模型,然後將模型用於新的輸入。AWS 關於建立機器學習應用程式的指南將此描述為迭代過程:定義問題、準備資料、建立有用的特徵、訓練模型、評估模型,並用它進行預測。
垃圾郵件篩選器是一個簡單例子。系統從標示為「垃圾郵件」和「非垃圾郵件」的電子郵件中學習。在訓練期間,它會注意到各種模式:可疑連結、重複字詞、寄件者行為或格式。在推論期間,它會將所學套用到新電子郵件,並預測其是否為垃圾郵件。
重要的詞是「預測」。機器學習不像人一樣理解世界。它會找出統計模式。這可能非常強大,但也意味著資料品質極其重要。
常見的機器學習類型
機器學習不是單一方法,而是包含數種主要方法:
| 類型 | 機器學習在這裡的用途是什麼? | 範例 |
|---|---|---|
| 監督式學習 | 從已標記的範例中學習 | 根據過去的銷售資料預測房價 |
| 非監督式學習 | 在沒有標籤的情況下找出模式 | 依行為將客戶分群 |
| 強化學習 | 透過獎勵與懲罰學習 | 訓練遊戲代理人 |
| 深度學習 | 使用多層神經網路 | 影像辨識或語音轉錄 |
Stanford CS229透過監督式學習、非監督式學習、神經網路和強化學習等核心主題教授機器學習。Google 的Machine Learning Crash Course也很適合初學者,因為它以實用範例解釋這些概念。對於想要實作文件的人來說,scikit-learn 使用者指南和TensorFlow 機器學習基礎是很好的技術參考資料。
機器學習與 AI、深度學習的差異
人們經常混淆 AI、機器學習和深度學習。它們彼此相關,但並不相同。
人工智慧是廣泛的領域:建立能執行與人類智慧相關任務的系統,例如推理、語言、感知、學習或決策。機器學習是建立 AI 系統的一種方法。深度學習則是一種使用多層神經網路的機器學習。
因此,三者的關係很簡單:AI 是大類別,機器學習位於 AI 之內,深度學習則位於機器學習之內。
計算機遵循固定規則,因此不是機器學習。透過學習使用者行為而持續改善的推薦系統是機器學習。使用深度神經網路的大型語言模型則是深度學習。
機器學習的實際範例
機器學習已是日常生活的一部分。串流服務用它來推薦影片。銀行用它來偵測異常交易。電子郵件服務用它來篩選垃圾郵件。翻譯工具用它來轉換語言。搜尋引擎用它來理解相關性與排序訊號。
在醫療保健領域,FDA 維護一份支援 AI 的醫療器材清單,其中許多使用 AI 或機器學習技術進行影像處理、診斷或臨床支援。這很好地提醒我們,機器學習可能很有用,但高風險系統需要測試與監督。
科學是另一個有力的例子。AlphaFold使用 AI 預測蛋白質結構,協助研究人員更有效率地研究生物學。這顯示機器學習不僅適用於廣告、應用程式和儀表板;它也能支持科學發現。
資料品質為何重要
機器學習模型的好壞,取決於其背後的資料與假設。如果訓練資料不完整、有偏差、過時或標記不佳,模型可能學到錯誤的模式。
例如,以帶有偏見的過往招聘資料訓練的招聘模型,可能重複這些模式。主要使用某一族群資料訓練的醫療模型,對另一族群的表現可能較差。推薦模型可能變得過於狹隘,不斷向使用者展示更多相同的內容。
良好的機器學習工作包含資料清理、測試、驗證、監控和人工審查。這也意味著要提出令人不自在的問題:資料中代表了誰?誰被遺漏了?如果模型出錯會怎樣?
使用 Pi 以視覺方式解釋機器學習
機器學習可能讓人感到抽象,因為重要工作往往是看不見的:資料準備、模型訓練、評估、部署和回饋迴路。視覺化說明能幫助人們看見這個過程。
使用Pi,你可以將機器學習概念轉化為簡報:從資料到模型的工作流程、監督式與非監督式學習的比較、顯示模型準確度的圖表,或以圖示說明訓練與推論。Pi 也能自訂主題、色彩、版面配置、圖示、圖表和 AI 生成的視覺素材,讓技術概念更容易向學生、客戶、創辦人或內部團隊呈現。
風險與負責任的使用
機器學習系統可能犯錯。它們可能放大偏見、洩露私人資訊、造成不公平的結果,或變得難以解釋。這就是為什麼負責任的 AI 很重要。
NIST AI 風險管理框架為組織提供思考可信賴 AI 風險的方法。OECD AI 原則強調以人為本的價值、公平性、透明度、穩健性、安全性和問責性。
對初學者而言,重點很簡單:評估機器學習不應只看準確度,也應考量公平性、安全性、隱私、可解釋性和現實世界的影響。
結論
機器學習是教導電腦從資料中學習模式,並將這些模式應用於新情境的實務。它是現代 AI 背後的主要引擎之一,涵蓋推薦、詐欺偵測、醫療工具和科學研究。
概念很簡單,但實務上需要謹慎。良好的機器學習需要優質資料、明確目標、測試、監控和負責任的使用。最好的模型不只是聰明,還要對受其影響的人有用、可靠且合適。
常見問題(FAQ)
問:什麼是機器學習?
答:機器學習是 AI 的一個分支,電腦會從資料中學習模式,並運用這些模式做出預測、推薦或決策。
問:機器學習和人工智慧是一樣的嗎?
答:不一樣。AI 是更廣泛的領域。機器學習是用於建立 AI 系統的一種方法。深度學習則是機器學習中的較小類別。
問:機器學習有哪些常見範例?
答:常見範例包括推薦系統、垃圾郵件篩選器、詐欺偵測、語音辨識、影像分類、翻譯工具,以及某些醫療 AI 系統。
問:學習機器學習需要程式設計嗎?
答:你可以不透過程式設計來理解基本概念,但建立真正的機器學習模型通常需要程式設計、統計、資料處理和測試技能。


