白宮 AI 高峰會:新安全框架解析
8月4日,白宮 AI 高峰會將美國聯邦政府對人工智慧的方針重新置於全球政策辯論的核心。焦點不僅是華盛頓希望加強監督,更在於新的 AI 安全框架似乎旨在界定最強大的 AI 系統如何在滿足更高的國家安全、透明度與公共問責期待之下持續擴展。
對 OpenAI、Meta、Google 和 Anthropic而言,訊息很明確:前沿 AI 已不再只是一場產品競賽,而正逐漸成為一場治理競賽。打造最具能力模型的公司,在大規模部署前將日益需要證明這些模型如何經過測試、監控、記錄與控制。
8月4日白宮 AI 高峰會發生了什麼事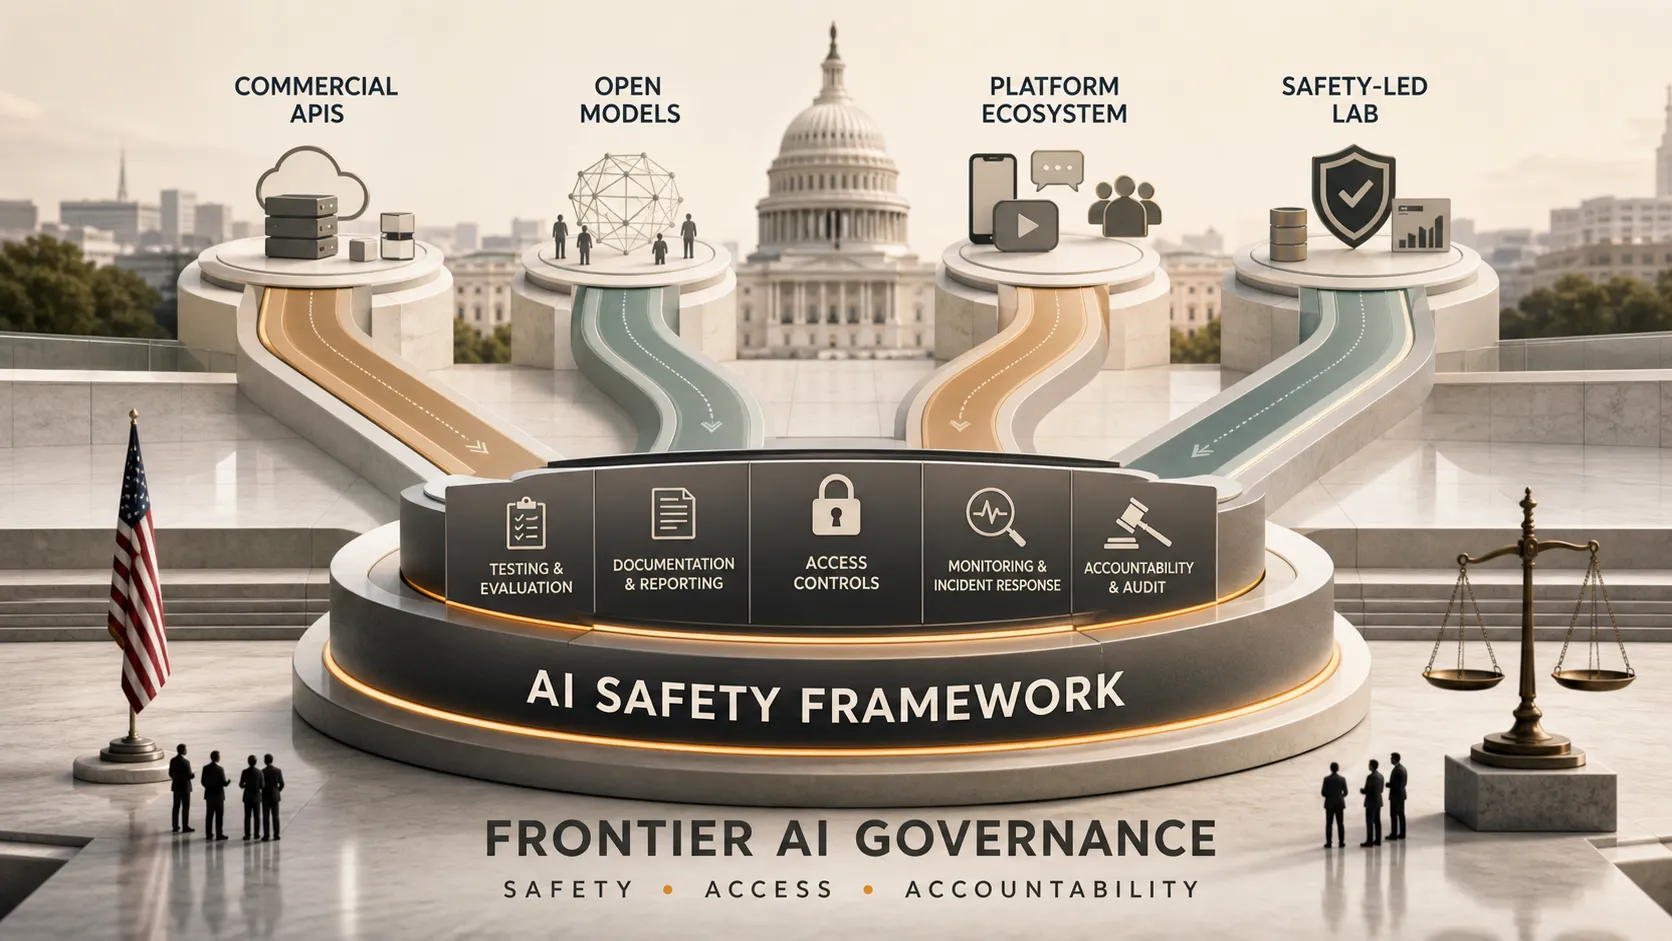
8月4日的 AI 高峰會匯集了聯邦政府在 AI 安全、產業責任及美國競爭優勢方面的優先事項。白宮並未將 AI 監管視為單一規則手冊,而是將安全定位為前沿模型開發的策略性營運層面。
AI 安全框架最好被理解為一項政策訊號:隨著模型能力提升並獲得更廣泛部署,領先的 AI 公司將被期望展現更強的防護措施。這不代表每項原則都立即具有法律約束力,但確實意味著自願承諾、聯邦指引、採購要求與監管標準正開始匯流。
這一點之所以重要,是因為 AI 系統正從實驗性工具進入關鍵的商業、政府與安全工作流程。政策問題不再是是否應治理 AI,而是如何在不損害創新或商業競爭力的情況下加以治理。
AI 安全框架試圖解決什麼問題
AI 安全框架回應的是一項實際問題:最先進的模型能創造巨大的經濟價值,但也可能帶來傳統軟體治理原本並非為管理而設計的風險。
核心關切包括難以預測的前沿模型能力、涉及網路行動或詐欺的濫用、模型訓練缺乏透明度、高影響力工作流程中的問責薄弱,以及與先進 AI 全球競爭相關的國家安全風險。
該框架促使產業朝向更高標準的證據邁進。公司僅聲稱模型安全已不足夠,還必須展示其如何評估安全性、辨識出哪些風險、加入了哪些緩解措施,以及系統發布後將如何受到監控。
美國的方針與歐盟 AI 法案有何不同
美國框架不應與歐盟 AI 法案混為一談。歐盟模式明確以權利為基礎,高度聚焦基本權利、風險類別,以及不同 AI 使用情境下的合規義務。
相較之下,美國的方針更緊密地連結於國家安全、商業競爭力、前沿模型安全及大型科技公司的問責。華盛頓似乎並非建立廣泛、以權利優先的監管架構,而是聚焦於強大 AI 公司能在何種條件下持續建構、部署及出口先進系統。
這對 OpenAI、Meta、Google、和 Anthropi意味著什麼
這項新框架對各大 AI 公司的影響各不相同,因為它們的商業模式、分發管道與安全理念並不一致。
| 公司 | 核心影響面向 | 策略挑戰 |
|---|---|---|
| OpenAI | 商業化前沿模型與企業部署 | 在快速擴張產品前證明安全性 |
| Meta | 如 Llama 等開源及可下載模型 | 在公開發布後套用安全控制措施 |
| 橫跨搜尋、雲端、Workspace、Android 與廣告的 AI | 協調大型生態系統中的治理 | |
| Anthropic | 以安全為主導的前沿模型開發 | 將安全定位轉化為可驗證的證據 |
OpenAI 在部署節奏方面可能面臨最直接的壓力。其商業模式取決於將前沿能力轉化為廣泛採用的產品、API 與企業工作流程。在 AI 安全框架下,更快的發布將需要更完善的文件、更具說服力的模型評估,以及更明確的證據證明商業需求並未超越安全規範。
Meta 面臨不同且可能更棘手的困境。其 Llama 策略已使開放模型成為一項重要競爭優勢。然而,偏好受控存取、可追溯部署與受監控風險緩解的聯邦框架,與開源分發並不完全相容。一旦模型被下載、微調並由第三方修改,Meta 對後續行為的控制力便會降低。問題不在於開放模型是否能夠安全,而在於去中心化後能否依聯邦標準證明其安全性。
Google 的挑戰在於規模。AI 已嵌入搜尋、生產力軟體、雲端基礎設施、廣告工具、行動系統與開發人員產品之中。這種廣度賦予 Google 巨大的策略力量,但也使合規複雜性倍增。任何一個產品領域的安全失誤,都可能成為整個生態系統的聲譽與監管問題。
Anthropic 在框架討論中擁有更強的敘事優勢,因為安全始終是其品牌核心。但即使 Anthropic 也將面臨更高門檻。僅有安全優先的文化已不再足夠。政策制定者將要求可重複的測試流程、可稽核的文件,以及明確證據證明隨著模型能力提升,治理實務依然有效。
為何該框架改變 AI 商業模式
AI 安全框架不只是增加文書作業,它改變了公司必須如何看待速度、分發與信任。
在生成式 AI 競爭的前一階段,市場獎勵快速推出、模型基準測試、開發人員採用與使用者成長。在下一階段,這些優勢仍然重要,但將與證據導向的治理並存。前沿模型的發布可能愈來愈需要安全報告、紅隊測試結果、風險緩解措施、升級政策及部署後監控計畫。
這為大型科技公司 AI 監管帶來新的營運現實。產品團隊、政策團隊、法務團隊與安全團隊將需要在開發週期更早期展開合作。安全不能再被視為模型訓練結束時才進行的審查,而必須成為模型路線圖本身的一部分。
企業團隊接下來應關注什麼
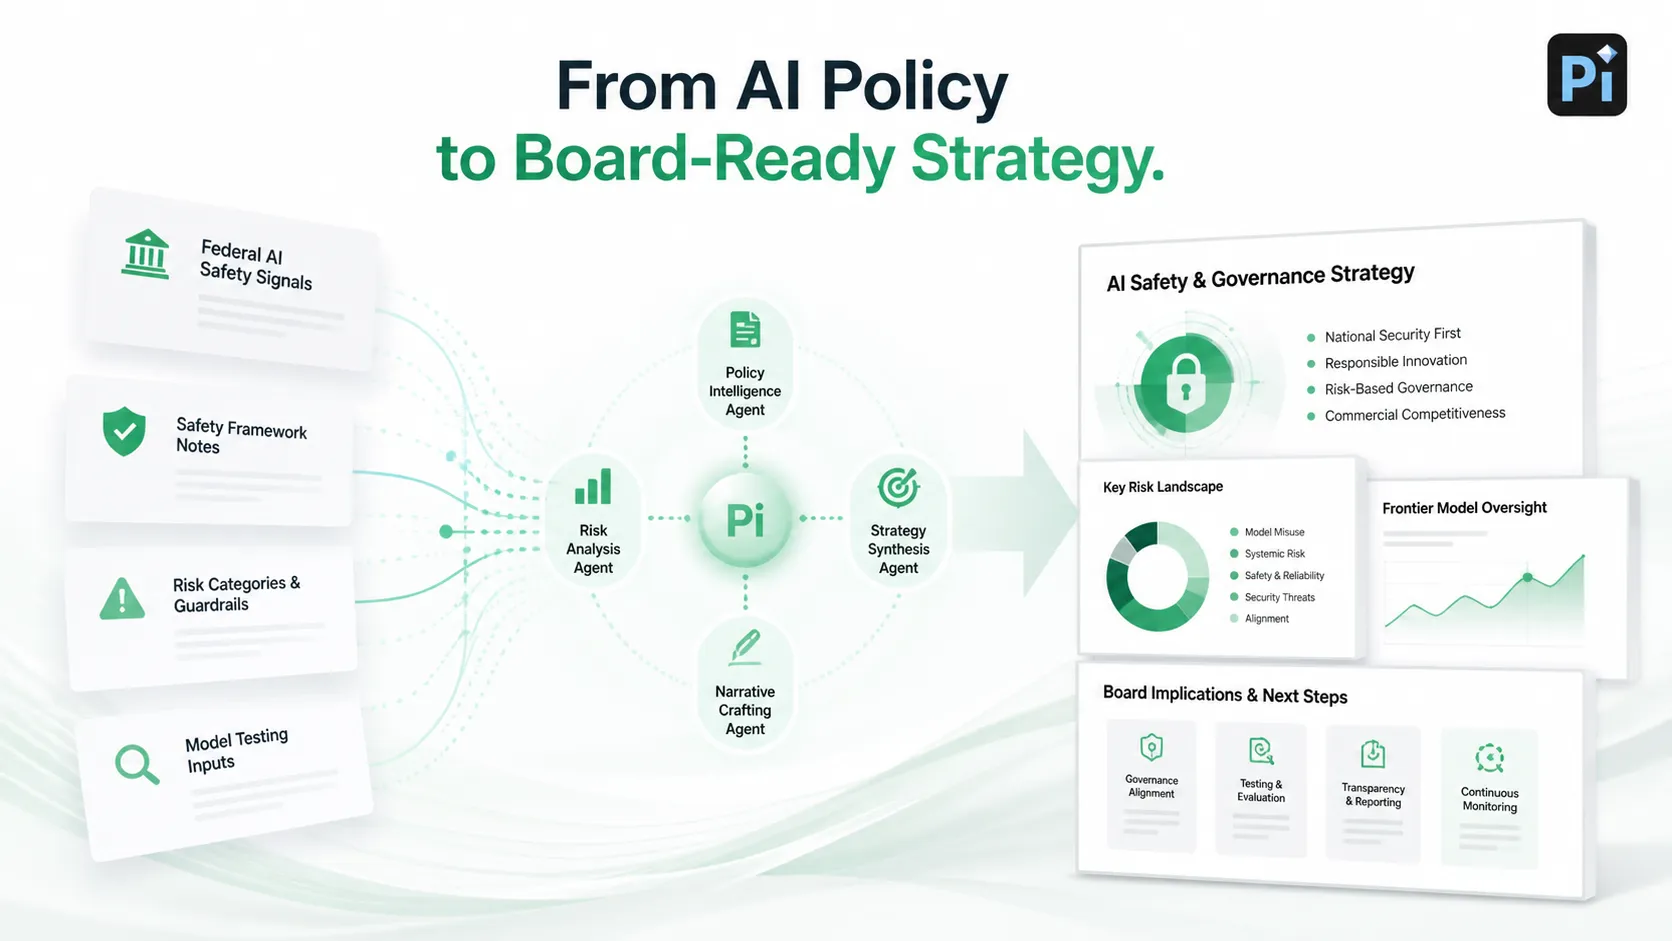
白宮 AI 高峰會不僅與 AI 實驗室相關,也影響那些採購、整合 AI,或向董事會、客戶、投資人與監管機關提出 AI 策略的企業。當聯邦期望改變時,公司說明 AI 採用方式也必須改變。
企業團隊將需要針對三個問題建立更清晰的內部敘事:使用哪些 AI 系統、這些系統造成哪些風險,以及如何處理治理問題。這對高階主管簡報、顧問報告、投資人更新及產品發布簡報尤其重要;在這些情境中,必須說明 AI 能力,同時避免過度宣稱確定性。
對於處理這些高風險討論的組織而言,能夠連結監管複雜性與結構化專業溝通的實用工具日益關鍵。無論是將政策變化轉化為適合董事會的敘事,或是綜合競爭影響,Pi 等平台正成為策略團隊的寶貴資產,協助其從被動報告轉向主動的高階主管敘事。
結論:AI 安全正成為競爭必備條件
白宮 AI 高峰會及其配套的 AI 安全框架,代表 AI 產業一個明確的轉折點。它們表明聯邦監督已不再是假設。對主要 AI 實驗室而言,安全已從內部工程優先事項轉變為核心合規與治理要求。
該框架不會阻止 AI 發展,但將重塑模型的建構、測試、記錄與發布方式。最終,能在這個新環境中蓬勃發展的公司,不會只是擁有最強模型的公司,而是擁有最可信安全敘事的公司。
這場辯論的下一階段將聚焦於如何驗證這些主張。這就是為何 透過 NIST 標準進行前沿模型測試i正成為連結政策意圖與現實世界 AI 部署的關鍵橋梁。
常見問題(FAQ)
問:白宮 AI 高峰會宣布了什麼?
答:白宮 AI 高峰會重點介紹了一項新的 AI 安全框架,聚焦於前沿模型安全、國家安全、透明度,以及對領先 AI 公司的問責。
問:什麼是 AI 安全框架?
答:AI 安全框架是一種美國政策方針,旨在改善對強大 AI 系統的治理,特別是透過安全測試、防止濫用、文件記錄與負責任部署。
問:該框架如何影響 OpenAI、Meta、Google 與 Anthropic?
答:OpenAI 面臨在快速部署前證明安全性的壓力;Meta 必須處理開源控制挑戰;Google 需要涵蓋整個生態系統的治理;Anthropic 則必須將其安全定位轉化為可驗證的證據。
問:什麼是前沿模型測試?
答:前沿模型測試是指在部署前後,透過能力評估、濫用測試、穩健性檢查、對齊評估及持續風險監控,評估先進 AI 系統的過程。


